AUC计算方法详解与Python实现代码
本文详细介绍AUC(ROC曲线下面积)的计算原理及其在二分类模型评估中的应用。重点解析基于统计意义的AUC计算公式,即正样本排在负样本前的概率,并提供完整的Python实现代码。通过排序与秩和计算,帮助开发者快速掌握AUC的核心算法与编码技巧。
2026-10-13
6

本文详细介绍AUC(ROC曲线下面积)的计算原理及其在二分类模型评估中的应用。重点解析基于统计意义的AUC计算公式,即正样本排在负样本前的概率,并提供完整的Python实现代码。通过排序与秩和计算,帮助开发者快速掌握AUC的核心算法与编码技巧。
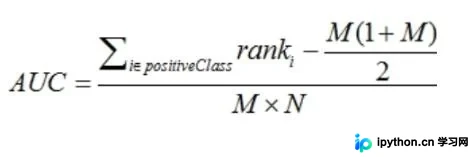
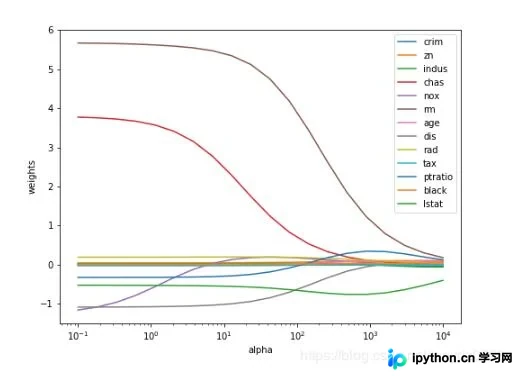
本文详解Python中数据共线性的成因、检测方法(如VIF、相关系数)及处理方案。通过岭回归、逐步回归和主成分回归等算法实战,展示如何利用sklearn库解决多重共线性问题,提升模型稳定性与预测精度。
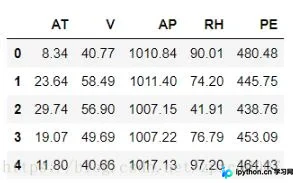
本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。
本文通过TensorFlow代码实例,演示如何使用tf.gradients函数计算梯度。以矩阵乘法为例,解析变量w1对结果res的导数计算过程,并展示梯度裁剪的实现方式,帮助开发者理解梯度反向传播的基本原理。
本文详细介绍Python中数据归一化的定义、目的及常见实现方法。归一化旨在消除量纲影响,提升数据可比性,主要处理奇异样本数据。内容涵盖最大-最小标准化(映射至[0,1])和Z-score标准化(均值0,方差1),并解析矩阵列归一化原理。通过sklearn库的normalize函数示例,展示axis参数在行与列归一化中的具体应用,为机器学习数据预处理提供实用参考。
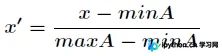
本文详细介绍TensorFlow中tf.summary系列函数的用法,涵盖scalar、histogram、image等常用接口。通过示例解析如何记录训练指标、保存日志及利用TensorBoard进行可视化分析,帮助开发者高效监控模型训练过程。
在使用Python进行机器学习开发时,LogisticRegression和SVM等模型常触发FutureWarning导致控制台输出杂乱。本文介绍两种有效消除这些警告的方法:通过warnings模块的simplefilter函数忽略特定警告,以及直接导入warnings模块进行全局配置。
本文详解如何利用Python进行幂律分布的数据可视化。通过推导对数变换公式,阐明双对数坐标下幂律关系转化为线性方程的原理。结合Matplotlib与Scikit-learn库,演示从生成带噪声的幂律数据、绘制散点图到使用线性回归模型进行拟合的全过程,并评估拟合效果。

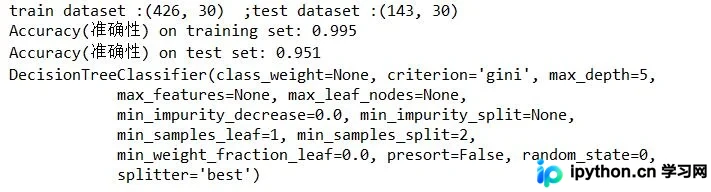
本文基于Python与sklearn库,使用乳腺癌数据集演示决策树模型的实现。重点探讨criterion(信息熵与基尼不纯度)及max_depth参数对模型性能的影响。通过可视化训练集与测试集得分,深入分析决策树深度增加导致的过拟合现象,并提供初步的参数调整结论。
本文整理了8段高效Python数据清洗代码,涵盖删除多列、内存优化、分类变量数值化、缺失值检查、字符串清理及时间戳转换等核心场景。所有代码均封装为独立函数,无需修改参数即可直接复用,旨在帮助数据科学家和开发者快速提升数据处理效率。
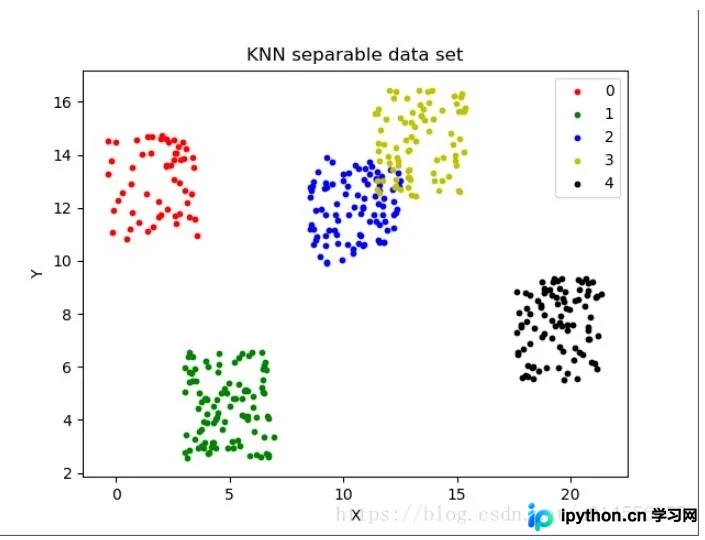
本文通过Python的Matplotlib和Numpy库,详细演示如何可视化实现KNN(最近邻)分类算法。内容涵盖算法核心逻辑、模拟数据集生成、数据可视化展示以及完整的KNN分类代码实现,帮助读者直观理解机器学习基础算法原理。
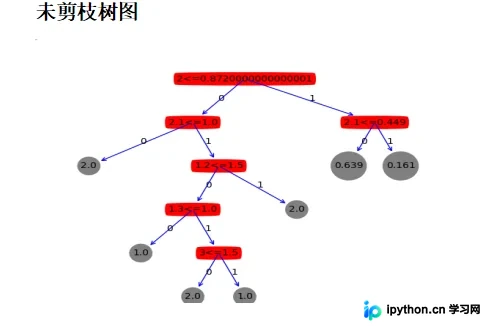
本文详细解析Python中决策树剪枝算法的实现。涵盖ID3算法基于信息熵的分裂逻辑,以及CART算法采用基尼指数进行二元划分的机制。通过完整代码示例,展示如何计算香农熵、处理连续变量划分,并实现预剪枝与后剪枝策略,帮助开发者掌握机器学习核心算法的底层实现。