

从零构建Python点击率预估模型:基于NumPy的前馈神经网络实战

本文从零开始,仅使用Python基础库NumPy构建一个极简的前馈神经网络(即单层逻辑回归),用于解决微博点击率预估问题。通过解析数据预处理、Sigmoid激活函数、前向传播及反向传播权重更新等核心步骤,帮助初学者深入理解监督学习中分类模型的训练原理与代码实现。
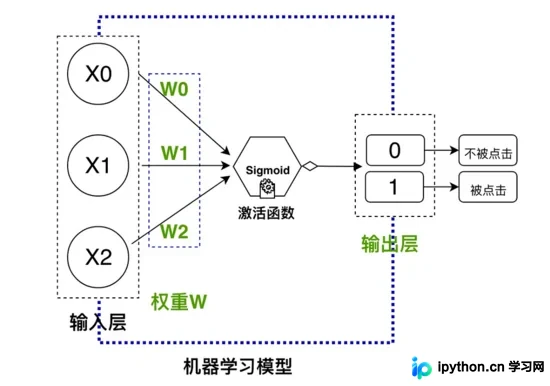
点击率预估模型
0.前言
本文旨在作为机器学习的基础入门指南,帮助读者熟悉神经网络的基本结构及其在Python中的具体应用方式。
在日常开发中,我们通常依赖sklearn、TensorFlow等成熟的机器学习工具包来快速搭建模型以解决各类业务问题。
本文将摒弃高级封装库,仅利用基础的numpy库,使用Python从零实现一个最简化的神经网络(本质上是一个单层神经网络,即逻辑回归LR),以此解决点击率预估这一具体业务场景。
1.假设一个业务场景
声明:为了简化演示过程,下文的所有设定均经过简化处理。
定义需要解决的问题:
假设老板提出需求:小李,这台机器上有一批微博的点击日志数据,你拿去分析一下,然后搞点击率预测啥的…
是的,核心任务就是预测一篇微博是否会被用户点击(即计算被点击的概率)……预测未来,看似神奇,实则基于数据规律。
热门微博
简单介绍一下加深的业务数据背景
每一条微博数据由三部分构成: {微博id, 微博特征X, 微博点击标志Y}
微博特征X包含三个维度:
X={x0="该微博有娱乐明星”,x1="该微博有图”,x2="该微博有表情”}
微博是否被点击过的标志Y:
Y={y0=“点击”, y1=“未点击”}
数据准备就绪后,接下来需要设计模型。将数据输入进行训练后,在预测阶段,只需输入{微博id, 微博特征X},模型即可输出每个微博id被点击的概率。
2.任务分析:
这是一个典型的有监督机器学习任务。
对于有监督学习,通常分为分类与回归两类。此处我们旨在预测一条微博是否会被用户点击,目标变量为二值类别:点击或不点击,因此显然应将其视为分类问题。
因此,我们需要搭建一个分类模型(即点击率预测模型),这也决定了我们需要构建一个有监督学习的训练数据集。
模型的选择
选择最简单的神经网络模型。人工神经网络有多种类型,如前馈神经网络、卷积神经网络及递归神经网络等。本文将以简单的前馈或感知神经网络为例,这类网络的数据传递方向是从前到后,简称前向传播过程。
3.数据准备:
整体流程如下:
数据预处理(数值化编码)——>特征筛选——>选择模型(前馈神经网络)——>训练模型——>模型预测
假设对4条微博的数据进行数值化编码,可表示为如下矩阵格式:
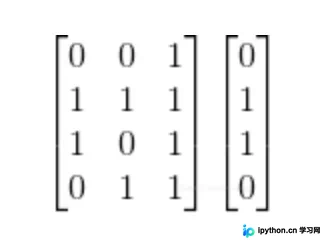
训练数据XY
解读一条样本数据: 第一条样本数据为:X0=[0 0 1],分别对应着三维的特征,最后4x1的矩阵是Y,0表示无,1表示有,可知该特征对应的Y0是未点击。
因此,这条样本可以翻译为:[该微博没娱乐明星,没有图片,有表情],最终y=0,代表该条微博没有被点击。
业务以及数据特征是不是很简单….简单有点看起来编的不太合理 - !
4.神经网络基本结构:
1.输入层:输入的业务特征数据
2.隐藏层:初始化权重参数
3.激活函数:选择激活函数
4.输出层:预测的目标,定义损失函数
我们即将使用的机器学习模型:
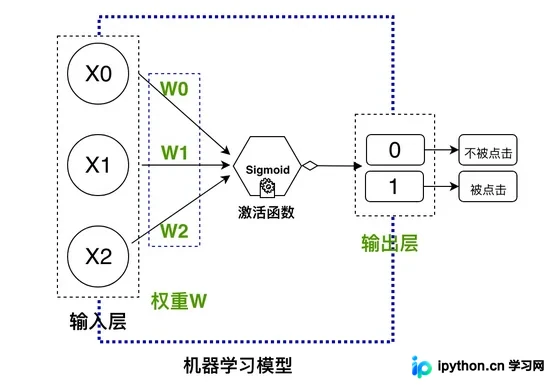
超级简单的前馈神经网络
机器学习模型类似一个黑盒子,输入历史点击的数据,进行训练,然后就可以对未来的数据进行预测….我们上面设计的是一个超级简单的前馈神经网络,但是可以实现我们上面的目的。
关于激活函数:
通过引入激活函数,实现了非线性变换,增强了模型的拟合效果。
关乎激活函数,请看之前的文章 吾爱NLP(2)--解析深度学习中的激活函数
在本文教程中,使用的是简单的Sigmoid激活函数,但注意一点,在深层神经网络模型中, sigmoid激活函数一般不作为首选,原因是其易发生梯度弥散现象。
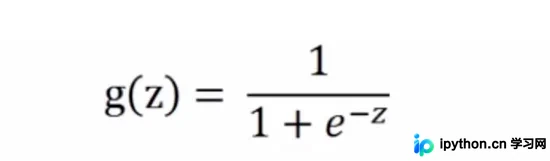
sigmoid公式
此函数可以将任何值映射到0到1之间,并能帮助我们规范化输入的加权和。
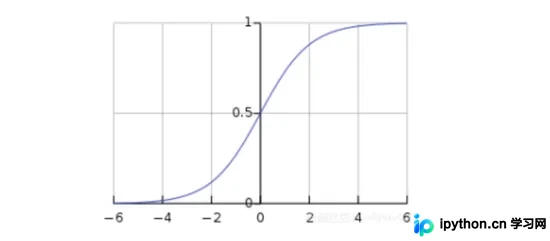
sigmoid图像
对sigmoid激活函数求偏导:
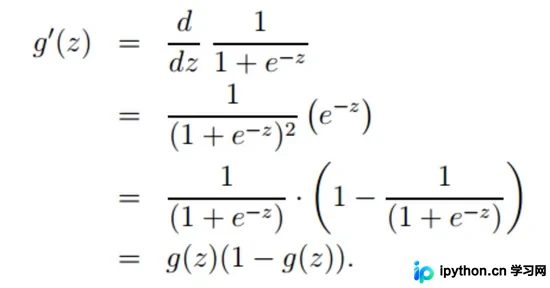
该偏导函数吗,等下写程序会用到,所以先放在这里!
模型的训练
训练阶段,模型的输入X已经确定,输出层的Y确定,机器学习模型确定,唯一需要求解的就是模型中的权重W,这就是训练阶段的目标。
主要由三个核心的流程构成:
前向计算—>计算损失函数—>反向传播
本文使用的模型是最简单的前馈神经网络,起始就是一个LR而已….所以整个过程这里就不继续介绍了,因为之前已经写过一篇关于LR的文章--- 逻辑回归(LR)个人学习总结篇 ,如果对其中的细节以及公式的推导有疑问,可以去LR文章里面去寻找答案。
这里再提一下权重参数W更新的公式:
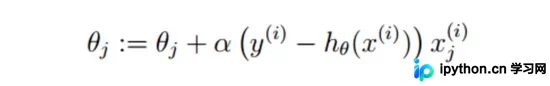
至此,所有的写代码需要的细节都已经交代结束了,剩下的就是代码了。
5.使用Python代码构建网络
# coding:utf-8
import numpy as np
class NeuralNetwork():
 # 随机初始化权重
 def __init__(self):
  np.random.seed(1)
  self.synaptic_weights = 2 * np.random.random((3, 1)) - 1
 # 定义激活函数:这里使用sigmoid
 def sigmoid(self, x):
  return 1 / (1 + np.exp(-x))
 #计算Sigmoid函数的偏导数
 def sigmoid_derivative(self, x):
  return x * (1 - x)
 # 训练模型
 def train(self, training_inputs, training_outputs,learn_rate, training_iterations):
  # 迭代训练
  for iteration in range(training_iterations):
   #前向计算
   output = self.think(training_inputs)
   # 计算误差
   error = training_outputs - output
   # 反向传播-BP-微调权重
   adjustments = np.dot(training_inputs.T, error * self.sigmoid_derivative(output))
   self.synaptic_weights += learn_rate*adjustments
 def think(self, inputs):
  # 输入通过网络得到输出
  # 转化为浮点型数据类型
  inputs = inputs.astype(float)
  output = self.sigmoid(np.dot(inputs, self.synaptic_weights))
  return output
if __name__ == "__main__":
 # 初始化前馈神经网络类
 neural_network = NeuralNetwork()
 print "随机初始化的权重矩阵W"
 print neural_network.synaptic_weights
 # 模拟训练数据X
 train_data=[[0,0,1], [1,1,1], [1,0,1], [0,1,1]]
 training_inputs = np.array(train_data)
 # 模拟训练数据Y
 training_outputs = np.array([[0,1,1,0]]).T
 # 定义模型的参数:
 # 参数学习率
 learn_rate=0.1
 # 模型迭代的次数
 epoch=150000
 neural_network.train(training_inputs, training_outputs, learn_rate, epoch)
 print "迭代计算之后权重矩阵W: "
 print neural_network.synaptic_weights
 # 模拟需要预测的数据X
 pre_data=[0,0,1]
 # 使用训练的模型预测该微博被点击的概率
 print "该微博被点击的概率:"
 print neural_network.think(np.array(pre_data))
"""
终端输出的结果:
随机初始化的权重矩阵W
[[-0.16595599]
 [ 0.44064899]
 [-0.99977125]]
迭代计算之后权重矩阵W:
[[12.41691302]
 [-0.20410552]
 [-6.00463275]]
该微博被点击的概率:
[0.00246122]
[Finished in 20.2s]
"""
6.总结:
根据终端输出的模型训练以及预测的结果,针对预测数据pre_data=[0,0,1],模型输出该微博被点击的概率为0.00246,很显然被点击的概率比较小,可以认为简单认为该微博不会被点击!
是的,我们的业务目标初步实现了----输入任意一条微博的样本数据到我们的机器学习模型中,既可以输出该样本被点击的概率。
上面的就是我们设计的一个超级简单的模型,假设了一个超级简单的业务场景,并随机设定了超简单的训练数据,如果有 编 的不合理地方多多包涵!!!该例子虽然可能并不能帮你解决实际的业务问题,但是对于机器学习的新手理解神经网络,或许会有一点点帮助吧!
总结
以上所述是小编给大家介绍的用Python搭建超级简单的点击率预估模型,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









