Python读取TXT文件及数据处理实战:类型转换与文本清洗
本文总结Python读取TXT文件的两种常见场景:数值型数据处理与文本情感分类。针对数组运算中常见的字符串类型报错,提供将元素强制转换为float的解决方案;同时展示如何利用正则表达式删除电影评论数据集中的多余符号,并结合文件遍历实现大规模文本数据的预处理与分类存储。
2026-10-13
6

本文总结Python读取TXT文件的两种常见场景:数值型数据处理与文本情感分类。针对数组运算中常见的字符串类型报错,提供将元素强制转换为float的解决方案;同时展示如何利用正则表达式删除电影评论数据集中的多余符号,并结合文件遍历实现大规模文本数据的预处理与分类存储。
本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
本文详细介绍如何使用Python从零实现反向传播(BP)神经网络算法。通过定义激活函数与权重更新机制,首先演示了简单的逻辑门功能模拟,随后结合sklearn数据集完成手写数字识别任务。文章包含完整代码示例、训练过程解析及94%准确率的测试结果,适合AI入门者学习模型训练与部署基础。
本文深入解析随机森林算法的核心原理,涵盖Bootstrap自助法、Bagging与Boosting的区别及Gradient Boosting实现机制。详细阐述随机森林在分类与回归中的应用优势,包括高准确率、抗过拟合及并行处理能力。最后提供基于Sonar数据集的Python完整实现代码,解析关键参数调整策略,帮助开发者掌握从理论到工程落地的全流程。
本文深入解析Python标准库Pickle的序列化与反序列化机制。详细讲解pickle.dump、pickle.dumps、pickle.load及pickle.loads等核心API的参数用法,对比Protocol版本差异,并通过完整代码示例展示如何将Python对象持久化存储至.pkl文件及在网络间高效传输。
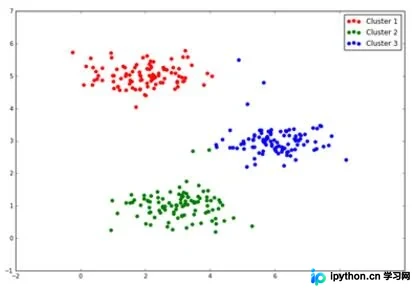
本文详细解析了Python中K-Means聚类算法的实现过程。从算法原理出发,通过构建寻找最近质心、计算新质心及迭代优化等核心函数,逐步演示如何对二维数据进行聚类。文章提供了完整的Python代码示例,包括数据加载、初始质心设定、迭代过程及结果可视化,帮助读者深入理解并掌握K-Means算法的实际应用。
本文深入解析TensorFlow中反向传播的实现原理,通过回归与二分类两个具体案例,展示如何定义计算图、声明优化函数及最小化损失。重点介绍GradientDescentOptimizer的使用及学习率对收敛的影响,结合代码输出验证模型参数的动态调整过程,帮助开发者理解自动微分与变量更新机制。
本文介绍使用Python进行验证码识别的实例代码。通过PIL读取图像,利用K-Means聚类算法对像素坐标进行分组,以区分验证码字符与背景。代码展示了如何提取非背景点并可视化聚类结果,为后续OCR识别提供预处理基础。
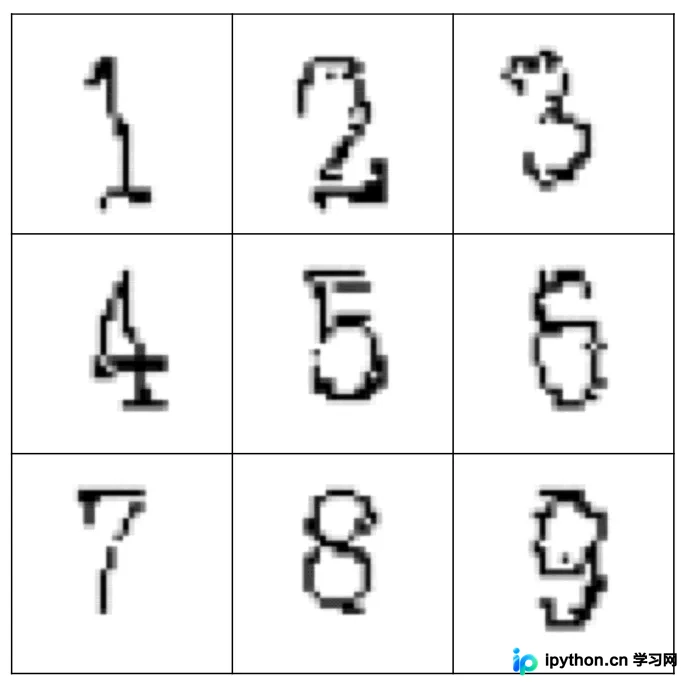
本文介绍一种使用Python3和PIL库生成手写体数字1-9图像的方法。通过随机生成数字、旋转及扭曲处理,模拟真实手写效果,无需额外安装OpenCV。文章详细解析了从空白图像创建、文字绘制到最终裁剪的完整流程,并提供相关Python源码供参考。
本文详细解析了基于Python实现的随机森林算法原理,涵盖有放回抽样、特征子集选取及不剪枝策略。通过Kaggle泰坦尼克号101数据集进行实战建模,展示了数据预处理、Gini系数分裂逻辑及投票机制。文中对比了手写模型与scikit-learn库的性能差异,并提供了提升准确率的特征工程与参数调整方向。
本文介绍如何使用TensorFlow实现弹性网络回归算法。通过加载鸢尾花数据集,构建包含L1和L2正则项的损失函数,并利用占位符和变量定义模型。代码展示了从数据预处理、模型训练到可视化损失收敛的全过程,旨在帮助读者理解多变量回归中的正则化技术应用。
本文详解如何利用TensorFlow构建卷积神经网络,结合ADB自动化截屏与点击,实现微信跳一跳游戏的AI自动通关。通过采集800组样本数据训练模型,解析从图像预处理、CNN架构搭建到参数优化的完整流程,帮助开发者掌握AI在游戏自动化中的应用。