Python数据挖掘核心技能:从数据处理到模型实战
本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
2026-10-13
6

本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
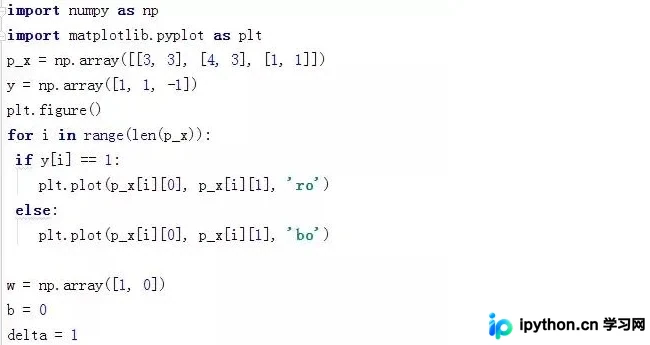
本文详细介绍基于Python实现的感知机线性分类模型。内容涵盖感知机作为判别模型的基本原理,即通过输入空间中的超平面进行分类,并阐述利用梯度下降法最小化误分类损失函数的优化过程。文中提供具体代码示例及运行结果,旨在帮助开发者理解并应用这一经典分类算法。
本文介绍 GitHub 上 Star 数超过 2.6 万的 Python 算法库 TheAlgorithms/Python。该库系统整理了排序、查找、加密、机器学习、图论及动态规划等多种算法,并提供原理简介与代码实现。文章重点展示了冒泡排序的 Python 代码示例,旨在为开发者提供全面的学习资源。
本文介绍如何使用Python实现统计字符串中出现频率最高的n个单词的函数count_words()。核心逻辑包括利用split()分割字符串,通过字典统计词频,并利用sorted()函数结合lambda表达式实现按频次降序、按字母升序的复杂排序。文章包含完整代码示例及测试用例,适用于机器学习入门练习。
本文介绍如何利用Python结合OpenCV库,从原始图像中随机截取指定宽高的子图像。通过设定随机坐标范围与目标尺寸,可批量生成用于机器学习训练的负样本或测试数据。代码包含完整的读取、随机定位、裁剪及保存逻辑,适用于需要大量随机局部图像的场景。
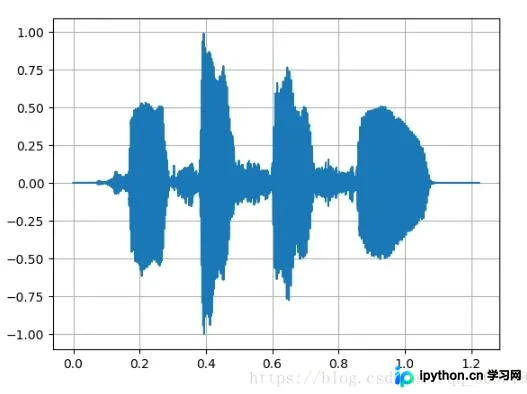
本文介绍利用Python进行语音文件特征提取的完整流程。首先通过pydub库将压缩的MP3文件转换为无损WAV格式,随后使用wave库读取音频参数并进行数据采样与归一化。最后,结合matplotlib绘制声波折线图与频谱图,直观展示音频特征,为后续语音识别模型训练提供数据基础。
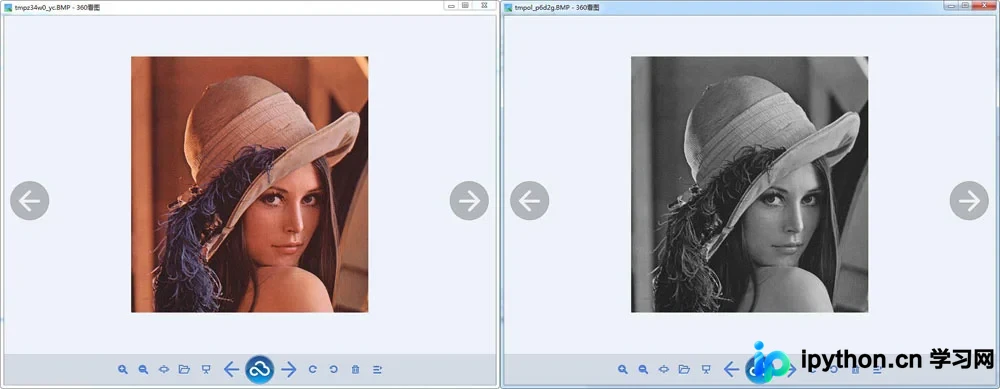
本文详解Python中图像读取、显示与保存的两种常用方法。通过PIL模块实现图像加载、灰度转换及保存;利用scipy和matplotlib模块演示图像读取、旋转操作及可视化展示。提供完整可运行代码,适用于机器学习与图像处理入门实践。
本文介绍了一种使用Python实现的基于信息增益的决策树归纳方法。通过加载属性、训练数据和类别描述文件,构建决策树节点并进行分类测试。代码展示了如何计算信息增益以选择最优分裂属性,并评估分类器的准确率。适合对机器学习和决策树算法感兴趣的开发者参考。
本文详细介绍如何在Python中利用scikit-learn库封装K近邻(KNN)算法。内容涵盖环境准备、核心代码实现及预测流程,重点解析无需显式训练过程但需拟合数据的特性,并提供完整的分类器封装与测试代码示例,帮助开发者快速掌握KNN在机器学习中的应用。
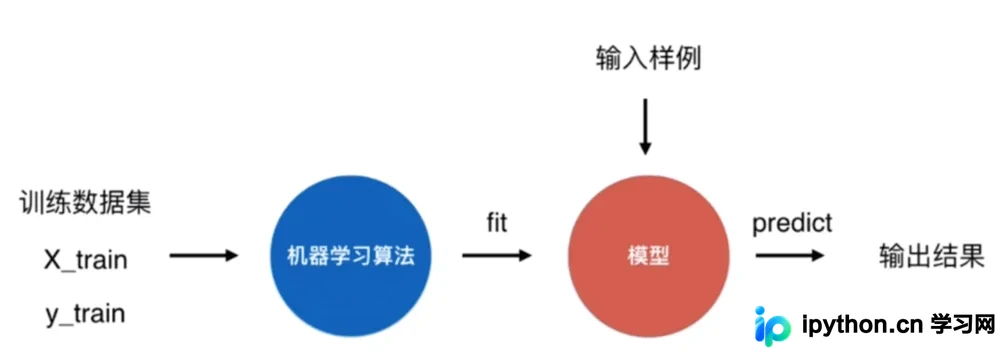
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
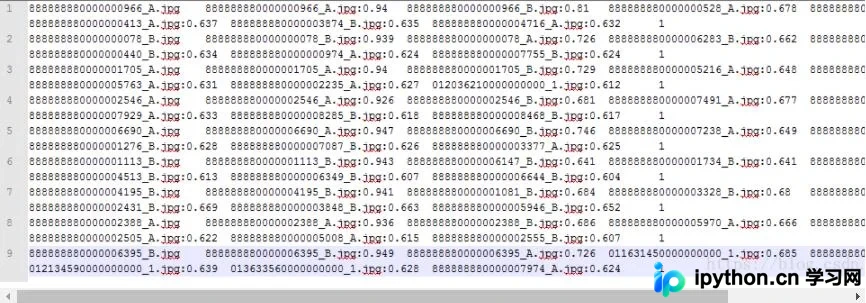
本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
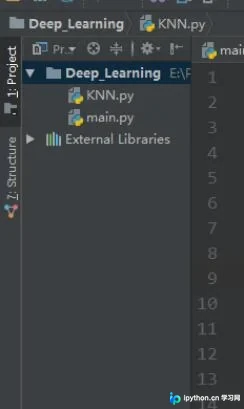
本文介绍如何在PyCharm中高效使用调试功能。通过创建包含算法模块的KNN.py及主程序main.py,重点讲解在main.py中利用__name__ == '__main__'构建测试入口,并在KNN.py中设置断点。启动Debug模式后,程序将自动进入断点,支持单步执行以观察具体运行步骤,从而快速定位并解决代码问题。