

Python机器学习实战:KNN分类算法原理与实现详解

本文深入解析Python中KNN(K近邻)分类算法的核心原理,包括距离计算、K值选择及K-D Tree与Ball-Tree优化策略。通过身高体重数据集的完整代码示例,展示如何使用scikit-learn实现分类,并详细解读准确率、混淆矩阵及决策边界可视化结果,帮助开发者掌握该基础且强大的分类模型。
本文为大家分享Python中KNN分类算法的实战应用,内容涵盖原理、代码及结果分析,供读者参考学习。
1、KNN分类算法
KNN分类算法(K-Nearest-Neighbors Classification),亦称K近邻算法,是一种概念简洁但分类性能卓越的经典分类方法。
其核心逻辑在于:为确定测试样本的类别,需遍历所有训练样本,找出与该测试样本“距离”最近的前K个样本,统计这K个样本中出现频率最高的类别,并将该类别赋予测试样本。简言之,即由最相似的K个样本通过投票机制决定归属。
文中所指的距离通常采用多维空间中的欧氏距离。这里的维度对应于样本的特征数量,即样本包含几个特征变量,便视为几维空间。
KNN算法的示意图如下所示。(图片来源:百度百科)
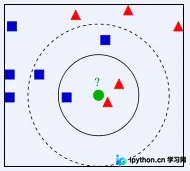
在上图中,目标是判断绿色测试样本应归属于蓝色类别还是红色类别。
当设定K=3时,根据1:2的投票比例,该样本被分类为红色;而当K=5时,依据3:2的投票比例,则被分类为蓝色。
KNN算法虽简单有效,但未优化的暴力搜索法在面对大规模数据时效率易遇瓶颈。若样本总数为N,特征维度为D,则该算法的时间复杂度约为O(DN)。
因此,KNN的实际实现通常会将训练数据构建为K-D Tree(K维树)。构建过程迅速,甚至无需计算D维欧氏距离,其搜索速度可提升至O(D*log(N))。
然而,当特征维度D过高时,会引发“维度灾难”,导致搜索效率下降至与暴力法相当的水平。
鉴于此,当D>20时,建议采用效率更高的Ball-Tree算法,其时间复杂度同样为O(D*log(N))。
长期实践表明,KNN算法虽简单,却能处理大规模数据分类,尤其适用于样本分类边界不规则的场景。此外,该算法是许多高级机器学习算法的重要基础。
当然,KNN算法也存在局限性。例如,若训练数据中某一类样本占绝大多数,简单投票机制可能失效。此时,需考虑为每个投票者分配不同的权重以优化结果。
2、测试数据
测试数据格式沿用此前使用的身高体重数据,但增加了部分样本以丰富数据集:
1.5 40 thin 1.5 50 fat 1.5 60 fat 1.6 40 thin 1.6 50 thin 1.6 60 fat 1.6 70 fat 1.7 50 thin 1.7 60 thin 1.7 70 fat 1.7 80 fat 1.8 60 thin 1.8 70 thin 1.8 80 fat 1.8 90 fat 1.9 80 thin 1.9 90 fat
3、Python代码
scikit-learn库提供了完善的KNN算法支持。具体的Python实现代码如下:
# -*- coding: utf-8 -*-
import numpy as np
from sklearn import neighbors
from sklearn.metrics import precision_recall_curve
from sklearn.metrics import classification_report
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt

''' 数据读入 '''
data = []
labels = []
with open("data\\1.txt") as ifile:
 for line in ifile:
  tokens = line.strip().split(' ')
  data.append([float(tk) for tk in tokens[:-1]])
  labels.append(tokens[-1])
x = np.array(data)
labels = np.array(labels)
y = np.zeros(labels.shape)

''' 标签转换为0/1 '''
y[labels=='fat']=1

''' 拆分训练数据与测试数据 '''
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size = 0.2)

''' 创建网格以方便绘制 '''
h = .01
x_min, x_max = x[:, 0].min() - 0.1, x[:, 0].max() + 0.1
y_min, y_max = x[:, 1].min() - 1, x[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
   np.arange(y_min, y_max, h))

''' 训练KNN分类器 '''
clf = neighbors.KNeighborsClassifier(algorithm='kd_tree')
clf.fit(x_train, y_train)

'''测试结果的打印'''
answer = clf.predict(x)
print(x)
print(answer)
print(y)
print(np.mean( answer == y))

'''准确率与召回率'''
precision, recall, thresholds = precision_recall_curve(y_train, clf.predict(x_train))
answer = clf.predict_proba(x)[:,1]
print(classification_report(y, answer, target_names = ['thin', 'fat']))

''' 将整个测试空间的分类结果用不同颜色区分开'''
answer = clf.predict_proba(np.c_[xx.ravel(), yy.ravel()])[:,1]
z = answer.reshape(xx.shape)
plt.contourf(xx, yy, z, cmap=plt.cm.Paired, alpha=0.8)

''' 绘制训练样本 '''
plt.scatter(x_train[:, 0], x_train[:, 1], c=y_train, cmap=plt.cm.Paired)
plt.xlabel(u'身高')
plt.ylabel(u'体重')
plt.show()
4、结果分析
程序运行后的输出结果如下所示:
[ 0. 0. 1. 0. 0. 1. 1. 0. 0. 1. 1. 0. 0. 1. 1. 0. 1.] [ 0. 1. 1. 0. 0. 1. 1. 0. 0. 1. 1. 0. 0. 1. 1. 0. 1.] 准确率=0.94, score=0.94 precision recall f1-score support thin 0.89 1.00 0.94 8 fat 1.00 0.89 0.94 9 avg / total 0.95 0.94 0.94 17
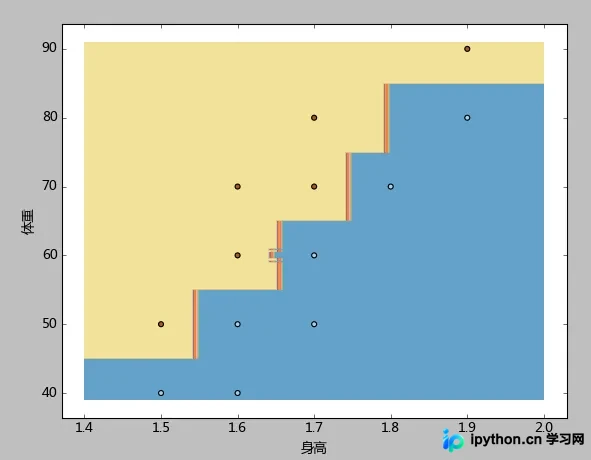
在众多分类算法中,KNN分类器属于较为简单的类型,需注意的细节不多。以下三点需特别说明:
1、KNeighborsClassifier支持设置三种算法参数:‘brute'(暴力法)、‘kd_tree'(K-D树)和‘ball_tree'(Ball-Tree)。若不确定哪种最优,可设置为‘auto',由KNeighborsClassifier根据输入数据自动选择。
2、在统计准确率时,分类器的score方法返回的是正确分类的比例,而非R2值。R2通常用于回归问题的评估。
3、本例首先根据样本中身高和体重的最大最小值,生成了一个密集网格(步长h=0.01),并将网格中的每个点视为测试样本进行预测。最后,使用contourf函数以不同颜色标注出“胖”和“瘦”两类区域。
从结果可见,本例的分类边界相对复杂,但呈现出与距离相关的明显锯齿状规则。
此类边界难以用线性函数处理,而KNN算法在处理此类边界问题时具有天然优势。在后续系列中我们将看到,该数据集能达到0.94的准确率已属优秀结果。
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









