

Python使用sklearn实现单变量线性回归详解

发布时间:2026-10-13| 5人浏览过
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。
线性回归作为机器学习领域的基础算法,归属于监督学习中的回归任务范畴。其核心目标在于最小化代价函数,实现这一目标通常采用梯度下降法或正规方程(即最小二乘法)。关于算法的具体数学原理此处不再展开,建议初学者参考吴恩达在斯坦福大学开设的相关课程以深入理解。
本文主要演示如何使用Python中的sklearn库构建并实现一个基础的单变量线性回归模型。
sklearn库对机器学习算法进行了高度封装,使得模型的使用变得十分简便。开发者通常只需调用fit、predict和score这三个核心方法,即可分别完成模型的训练、预测以及性能评估工作。
以下是一个具体的实现示例:
from pandas import DataFrame
from pandas import DataFrame
import pandas as pd
import matplotlib.pyplot as plt
from sklearn import datasets,linear_model

X=[]
Y=[]
with open("C:\\Users\\www\\ex1data1.txt","r") as f:  #读取txt文件。
 for line in f:
  p_tmp, E_tmp = [float(i) for i in line.split(',')]
  X.append(p_tmp)
  Y.append(E_tmp)
 #'data=np.loadtxt('ex1data1.txt',delimiter=',')
# X=data[0]
# Y=data[1]
data=DataFrame(X,columns={'a'})
data['b']=b
X=DataFrame(X)

fig = plt.figure()
ax1 = fig.add_subplot(1,1,1)
plt.scatter(data['a'],data['b'])   #显示X,Y的散点图

def linear_model_main(X,Y,predict_value): #定义一个使用线性回归的函数
 regr=linear_model.LinearRegression()
 regr.fit(X,Y)  #训练模型
 predict_output=regr.predict(predict_value) #预测
 predictions={}        #用一个集合装以下元素
 predictions['intercept']=regr.intercept_  #截距
 predictions['codfficient']=regr.coef_   #斜率(参数)
 predictions['predict_value']=predict_output  #预测值
 return predictions

result = linear_model_main(X,Y,1500)    #调用函数
print(result['predict_value'])


def show_predict(X,Y):
 regr=linear_model.LinearRegression()
 regr.fit(X,Y)
 plt.scatter(X,Y,color='blue')
 plt.plot(X,regr.predict(X),color='red')

show_predict(X,Y)
最终的模型拟合效果如图所示:
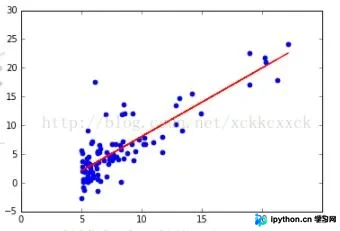
以上就是Python实现简单单变量线性回归的全部内容,希望能为读者提供有价值的参考,并欢迎大家继续支持本站获取更多技术分享。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









