Python sklearn分类决策树方法详解
本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
2026-10-16
5

本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
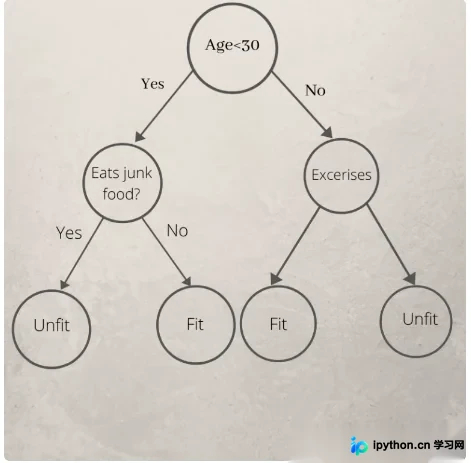
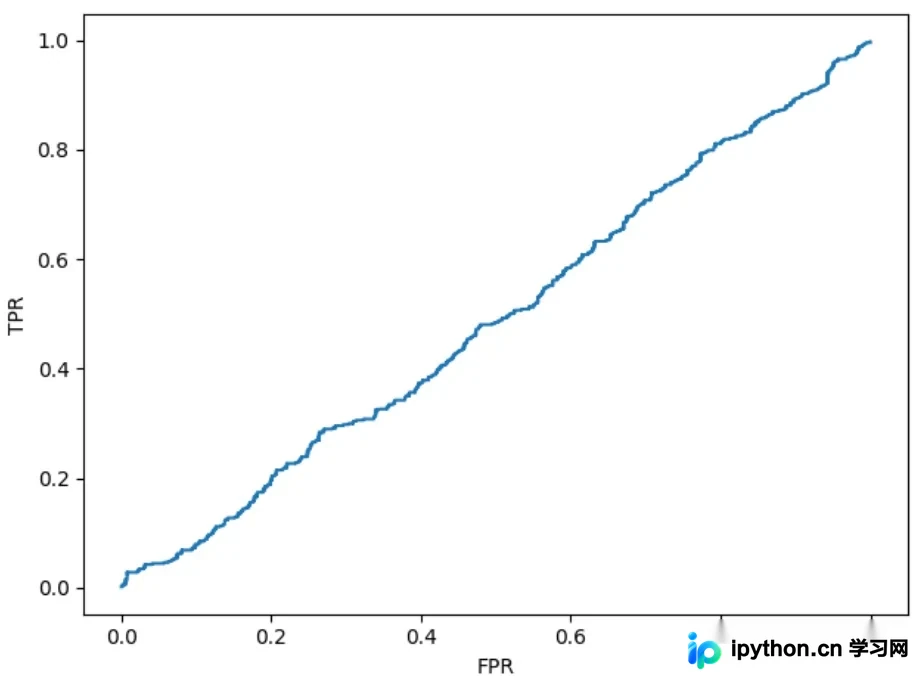
本文总结Python中计算AUC(ROC曲线下面积)的三种常用方法。首先介绍使用sklearn库直接计算的方式,其次详解通过遍历阈值计算面积的方法,最后讲解基于样本排序简化计算的算法。文章提供完整代码示例及运行结果分析,帮助开发者理解不同实现逻辑及其适用场景。
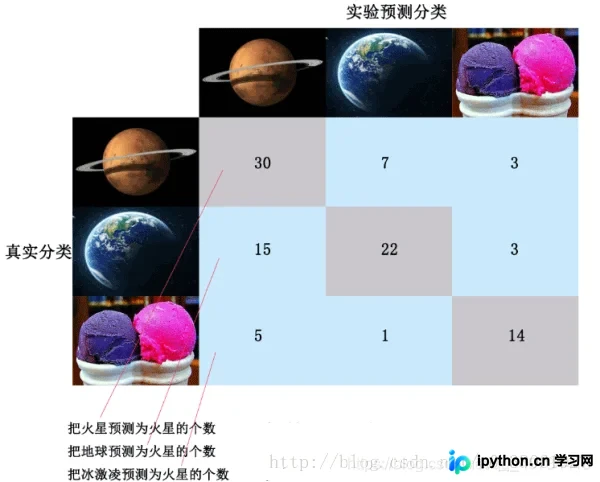
本文详解Python中多分类混淆矩阵的两种实现方式。首先解析TP、FP等核心概念及查准率、F1-Score等评价指标,随后通过sklearn库展示如何直接打印各类别分类准确率,以及如何输出具体分类数值以支持灵活计算。包含完整代码示例与可视化图表,适用于深度学习模型评估。
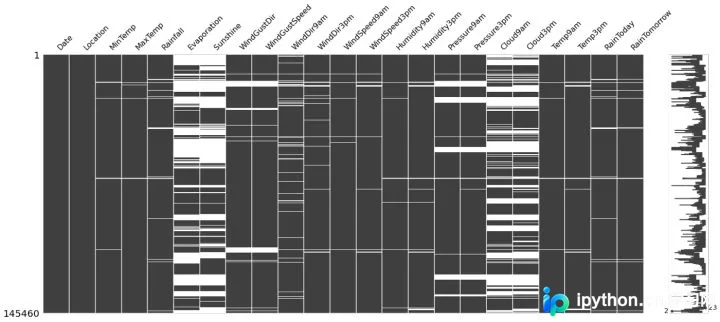
本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
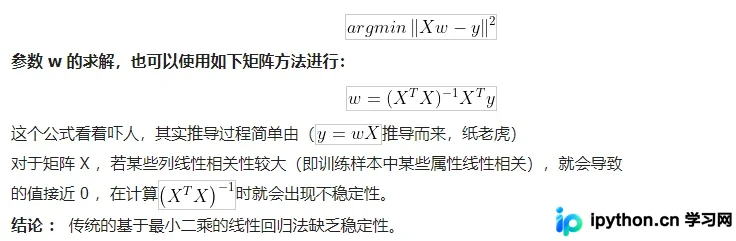
本文介绍岭回归作为处理共线性数据的有偏估计方法,对比最小二乘法与过拟合现象。详解sklearn中Ridge模型的alpha、fit_intercept等关键参数,并通过Python代码实现基于小时、星期等多维特征的交通流量多项式回归预测,展示完整数据处理与可视化过程。
本文详细介绍sklearn中make_blobs函数的用法,涵盖n_features、n_samples、centers、random_state及cluster_std等核心参数的含义与配置方法,通过具体代码示例展示如何生成指定特征、样本量及方差的多类聚类数据集,并说明随机种子对结果复现的重要性。
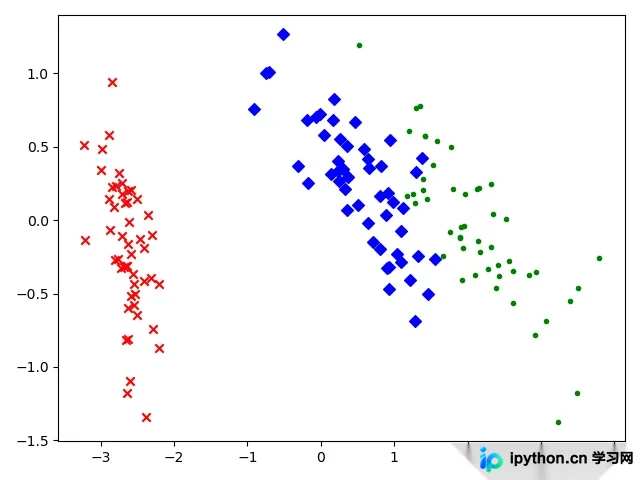
本文详细介绍Python中PCA降维的两种实现方式。首先解析PCA将高维数据投影到低维空间以保留最大信息量的原理及标准步骤,随后通过矩阵运算手动实现PCA,并对比使用sklearn库中PCA算法的调用方法。文章涵盖代码解析、可视化结果分析及重构误差说明,帮助开发者掌握特征降维技术。
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
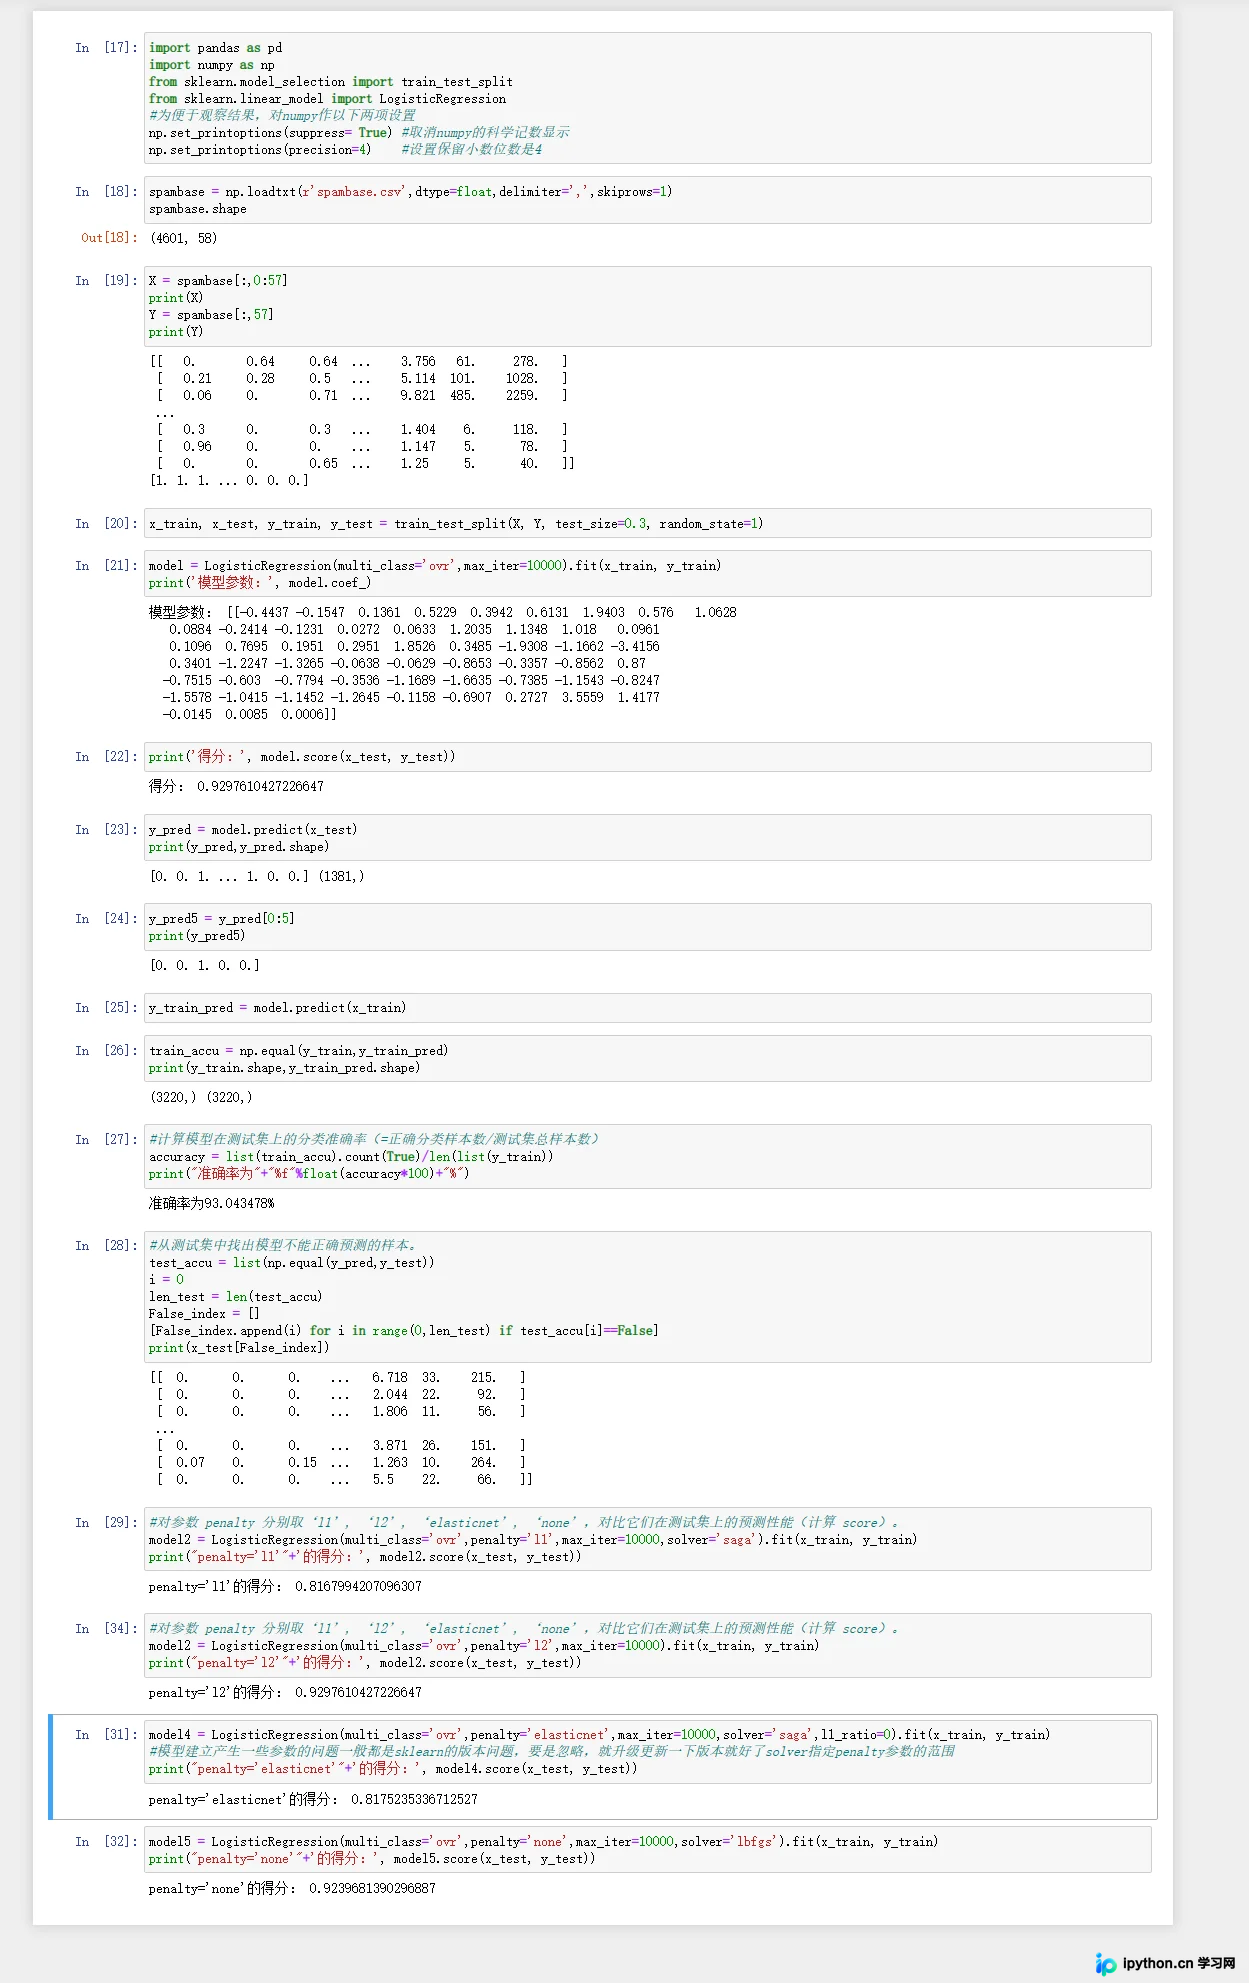
本文介绍如何在Python中使用pandas处理数据,并结合sklearn库进行数据集划分。详细讲解train_test_split函数的随机划分方法及KFold交叉验证的原理与参数设置,包括shuffle和random_state的影响,帮助开发者优化模型训练流程。
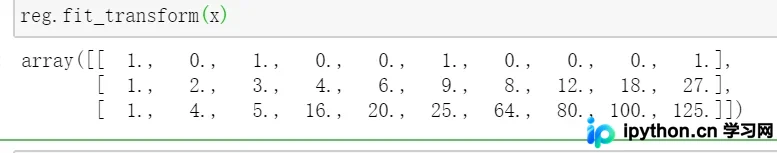
本文详细解析了Python中sklearn库PolynomialFeatures生成多项式特征的逻辑,并通过自定义函数实现相同功能。文章对比了sklearn输出与手动实现结果,验证了两者的一致性,并探讨了处理多维数组时的实现思路。
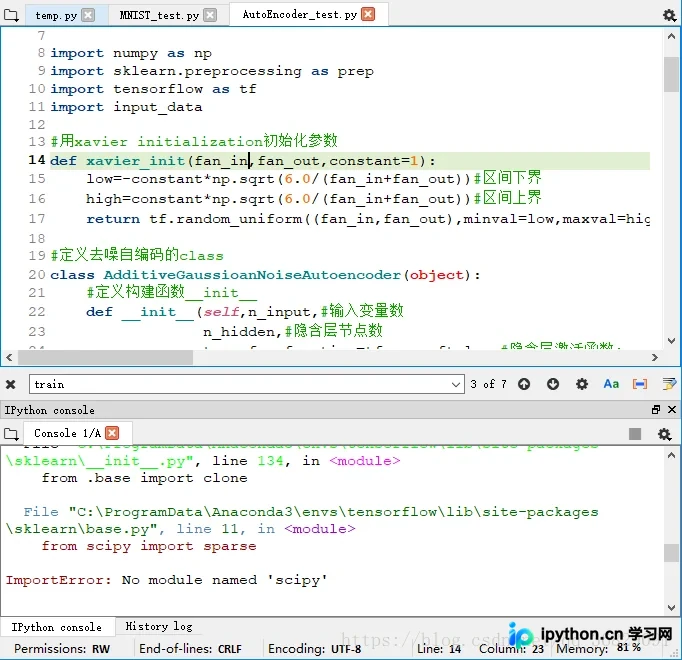
本文详细解决Python运行时报错no module named sklearn的问题。介绍通过pip install命令直接安装,以及在Anaconda/Spyder环境中使用conda activate激活环境后安装sklearn的方法。同时提供解决pip安装超时Read timed out错误的技巧,确保scikit-learn及相关依赖顺利部署。
本文介绍PyCharm中解决Unresolved reference 'sklearn'错误的两种方法。首先通过修改Console设置勾选Add source roots to PYTHONPATH并重启IDE;其次针对Python 3.6中sklearn弃用cross_validation的情况,建议使用model_selection模块导入train_test_split。