

为什么Python字典的键可以用元组但不能用列表
深入解析为什么Python字典的键允许使用元组却禁止使用列表。从哈希表底层寻址机制、可哈希性(Hashable)原理、可变对象对字典稳定性的破坏,再到元组包含可变元素的边界反例进行全面剖析。
在 Python 中,字典(dict)基于哈希表实现,要求作为“键”的对象在其生命周期内哈希值保持恒定,即必须具备可哈希性(Hashable)。列表是随时可以修改内部元素的可变对象,如果作为键,修改后会导致哈希定位崩溃,因此 Python 明确禁止列表作为字典键;而元组属于不可变对象,其哈希值计算后无法随意变动,因而天然能够用作字典的键。不过,这也存在一个极其关键的边界:只有当元组内包含的所有元素本身也都是可哈希对象时,该元组才能成为合格的键。
一、字典底层机制:为什么键必须是“可哈希”的
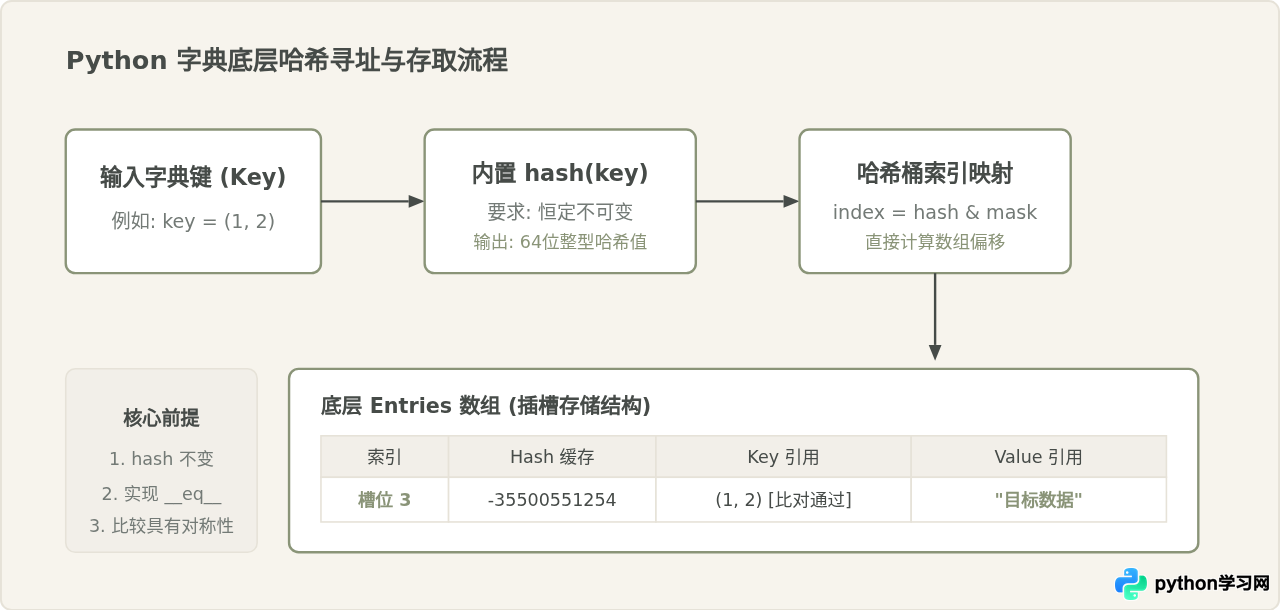
为了做到接近 O(1) 的超快查询速度,Python 字典并没有将键值对按顺序排成一列去遍历对比,而是在底层维护了一张连续分配的哈希表(Hash Table)。
当我们在字典中执行读取或写入操作时,解释器内部经历以下关键处理阶段:
- 计算哈希值:调用内置函数
hash(key),得到一个固定位宽的整型哈希值。 - 映射哈希桶索引:通过哈希值对底层表容量进行掩码运算(例如
index = hash_value & mask),算出该键应该落在底层的哪一个插槽(哈希桶)。 - 精确定位与比对:如果该槽位已有数据,先比对两个对象的哈希值是否一致;若哈希值相同,再通过
==运算符确认两个键是否真正相等,以解决哈希冲突。
这个流程建立在一个至关重要的前置假设之上:同一个键计算出来的哈希值,在字典的整个存在期间绝对不能改变。一旦哈希值变动,字典按照新哈希去寻址时,就会直接指向错误或空置的槽位,造成数据“隐形丢失”。
二、如果允许列表作键,会引发怎样的灾难?
为了直观理解 Python 为什么严格限制列表,我们可以反向推演:假定 Python 允许列表充当字典的键,会发生什么?
列表是典型的数据容器,具备原位增删改查的能力(如 append、pop、sort 或直接切片赋值)。假定列表可以计算哈希值:
# 伪代码逻辑推演(在实际 Python 中无法运行)
data_dict = {}
my_key = [1, 2]

data_dict[my_key] = "重要结果"
# 假设此时 hash([1, 2]) 计算为 10086,数据被保存在 10086 对应的哈希槽位中

# 随后,列表在外部被修改了
my_key.append(3)  # my_key 变成了 [1, 2, 3]
此时,字典面临无法化解的数学与工程死锁:
- 情况 A(哈希值随内容变化):当
my_key变成[1, 2, 3]后,它的哈希值变成了 99999。当我们再次执行data_dict[my_key]时,解释器去 99999 槽位寻找,发现那里空无一物,之前存入的"重要结果"永远也查不到了。数据明明还在内存中,却被哈希表彻底“弄丢”。 - 情况 B(哈希值不随内容变化,以内存地址为准):如果列表以对象内存地址(
id(list))作为哈希,那么新建一个内容完全相同的列表[1, 2],其哈希值和地址必定不同,这就违反了哈希表的基本数学公理:若a == b,则必有hash(a) == hash(b)。这样会导致即便传入完全相等的列表,也取不出字典中的值。
因此,Python 从语言规范层面上直接切断了这种矛盾:列表类型未实现 __hash__()(内部直接设定 __hash__ = None)。只要尝试对列表执行 hash() 或将列表作为字典的键,Python 解释器就会立即阻断并抛出异常:
>>> my_list = [1, 2]
>>> hash(my_list)
TypeError: unhashable type: 'list'

>>> d = {my_list: "value"}
TypeError: unhashable type: 'list'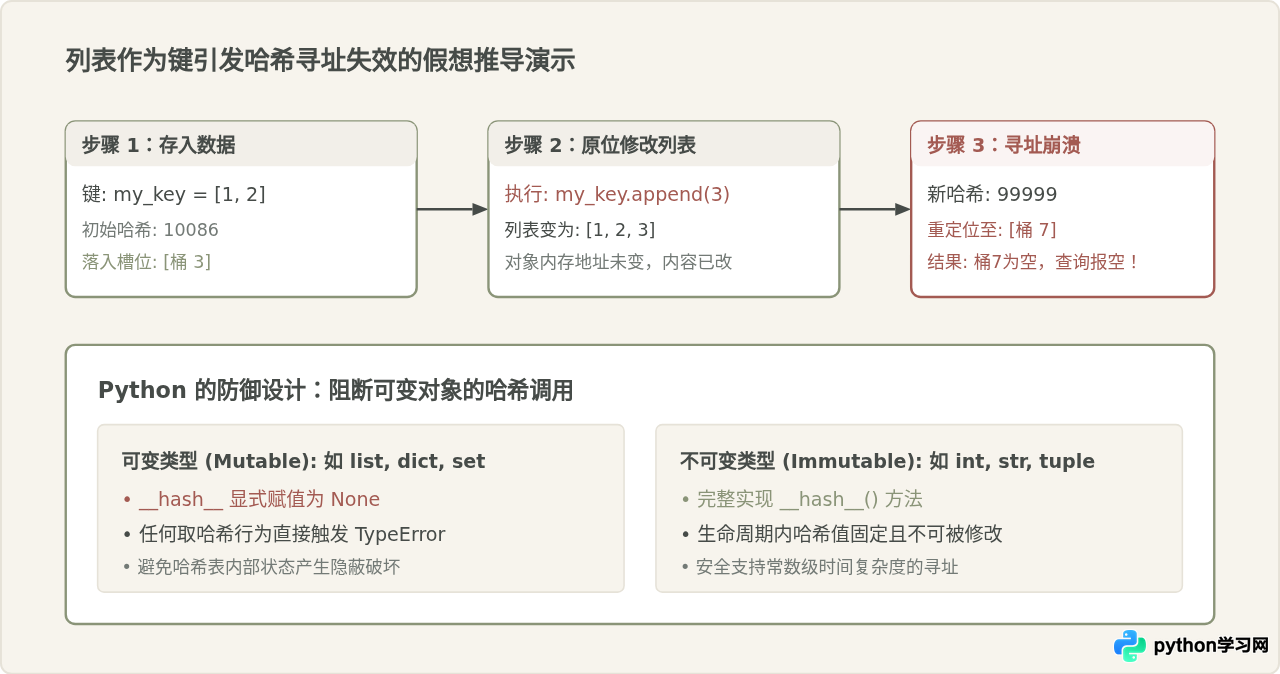
三、元组一定能作为字典键吗?关键的边界反例
很多初学者在掌握不可变性概念后,容易得出一个过于绝对的推论:“既然元组是不可变的,那么所有元组就一定能作为字典的键”。
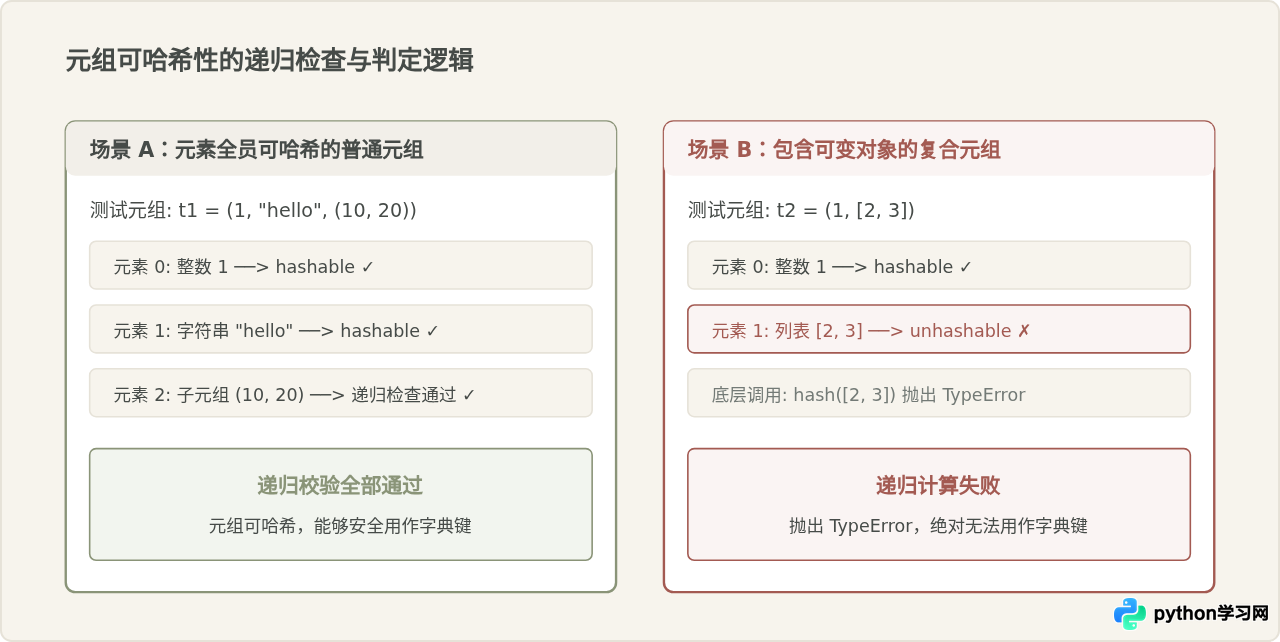
元组本身只是一个不可变的有顺序引用集合。如果我们在元组内部放置了一个列表,元组对列表的引用不可改变,但被引用的列表本身依旧是可变的!
# 示例:含有列表的元组
bad_tuple = (1, 2, ["a", "b"])

# 尽管 bad_tuple 类型为 tuple,但它依然不可哈希
print(type(bad_tuple))  # 输出: <class 'tuple'>

hash(bad_tuple)
# 抛出异常: TypeError: unhashable type: 'list'

# 尝试作为字典的键
my_dict = {bad_tuple: "test"}
# 抛出异常: TypeError: unhashable type: 'list'
为什么异常提示依旧是 unhashable type: 'list' 呢?这是因为 Python 在计算元组哈希值时,底层执行的是递归哈希组合算法:它会依次遍历元组中的每个元素并调用其 hash()。当递归遇到内部的列表元素时,底层抛出异常并向外传递,最终导致元组计算哈希失败。
四、工程实战:常见应用场景与替代转换方案
在实际开发过程中,如果我们手头有序列型或集合型的数据,且确实需要将它们作为字典的复合索引,应该如何正确处理?
1. 坐标与复合维度索引:直接选用元组
当表示二维网格地图坐标、图像像素位置或数据库复合主键时,使用纯数值或字符串构成的元组是最自然、高效的选择:
# 二维网格坐标作为键
grid_map = {}
grid_map[(0, 0)] = "起点"
grid_map[(10, 25)] = "宝箱"
grid_map[(100, 200)] = "终点"

coord = (10, 25)
print(grid_map[coord])  # 输出: 宝箱
2. 动态收集的列表:在作为键之前冻结为元组
如果在处理数据时先通过列表动态汇总了元素,后续需要拿这组数据查表或做缓存,只需显式调用 tuple() 进行一次不可变转换:
# 缓存动态参数的场景
query_items = ["苹果", "香蕉", "橙子"]

# 错误做法: cache_dict[query_items] = 100  # 报错 TypeError
# 正确做法: 转换为元组后再存入
cache_key = tuple(query_items)
cache_dict = {}
cache_dict[cache_key] = 100

print(cache_dict[("苹果", "香蕉", "橙子")])  # 成功命中缓存
3. 无序集合作为键:使用 frozenset
与 list 类似,Python 原生的 set 也是可变的,因此同样无法作为字典键。若需要使用不计顺序的元素组合作为键,应当使用 Python 提供的内置不可变集合类型 frozenset:
# 原生 set 不可哈希
# bad_dict = {{1, 2, 3}: "tag"}  # 报错 TypeError: unhashable type: 'set'

# 转换为 frozenset 即可作为键
tag_key = frozenset([1, 2, 3])
tag_dict = {tag_key: "有效组合"}
print(tag_dict[frozenset([3, 2, 1])])  # 集合无序性依然成立,输出: 有效组合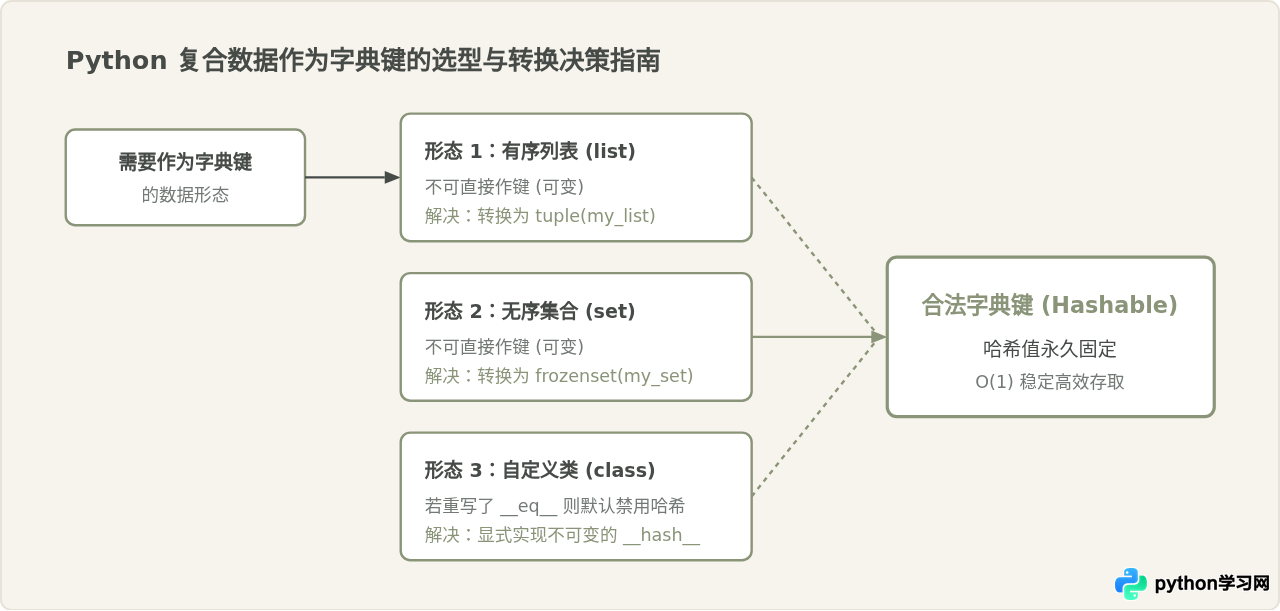
五、核心机制对照总结
为了便于速查与记忆,下表整理了常见数据类型在可变性、可哈希性以及字典键适用性上的核心特征:
| 数据类型 | 可变性 | 是否实现 __hash__ | 是否可用作字典键 | 常见处理建议 |
|---|---|---|---|---|
int / float / str |
不可变 | 是 | 可以 | 基础原子类型,天然安全 |
tuple (纯不可变元素) |
不可变 | 是 | 可以 | 复合主键、坐标索引的优先之选 |
tuple (含可变元素) |
顶层不可变,内部可变 | 否 (递归抛错) | 不可以 | 确保子元素全部由不可变类型构成 |
list |
可变 | 否 (显式设为 None) | 不可以 | 使用 tuple(list) 冻结后再作键 |
set |
可变 | 否 (显式设为 None) | 不可以 | 转换为 frozenset(set) 后作键 |
dict |
可变 | 否 | 不可以 | 提取 tuple(dict.items()) 后作键 |
总而言之,Python 之所以允许元组做键而禁止列表,并非语法层面的随意偏好,而是哈希表数据结构对“键哈希值持久不变”这一数学规律的必然要求。理解了这一规则,不仅能在日常编码中避免 TypeError: unhashable type 异常,更能帮助我们在设计复杂数据结构和缓存机制时做出最稳健的技术选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









