

Python爬虫实战教程:从Requests到Scrapy的项目案例
深入浅出的Python爬虫实战教程,从轻量级Requests+BeautifulSoup单页数据采集实战,逐步演进至Scrapy工业级异步框架的项目工程化构建与技术选型。
在Python数据采集的实际开发中,开发者通常会经历从编写简单脚本到构建工程化爬虫系统的演进过程。本文通过两个可运行的具体项目案例,完整演示如何使用Requests配合BeautifulSoup完成单页内容抓取,以及当面临多页翻页、并发控制、断点续爬等规模化需求时,如何过渡到工业级异步框架Scrapy,帮助读者建立从脚本开发到工业化采集的完整技术栈思维。
一、基础实战:基于Requests与BeautifulSoup的单页采集
对于结构简单、抓取体量在几百页以内的静态网页,轻量级网络请求库Requests搭配HTML解析库BeautifulSoup是最直观的选择。这种方式无需复杂的工程脚手架,代码编写直接,非常适合作为快速抓取原型或小规模数据收集工具。
1. 环境准备与依赖安装
在开始编写代码前,需要确保安装了Python 3标准环境以及对应的第三方库:
pip install requests beautifulsoup4 lxml
2. 实战项目:抓取名言网站的数据并导出为CSV
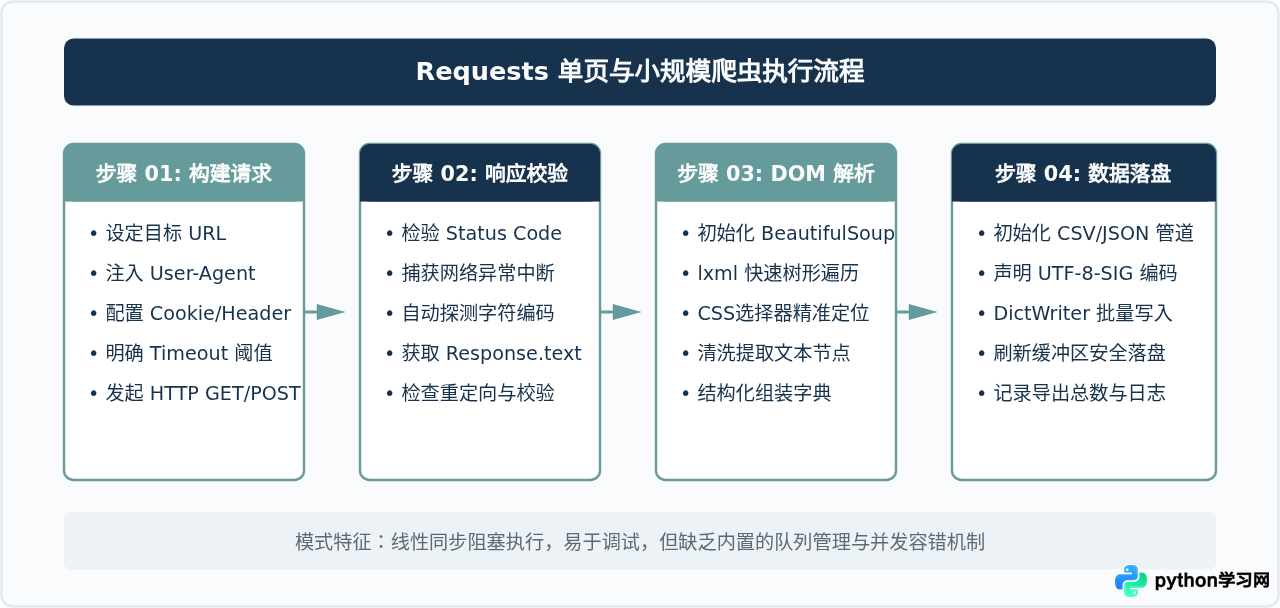
我们以公开测试站点(quotes.toscrape.com)为例,抓取页面中的名言内容(text)、作者(author)以及对应的分类标签(tags),并保存为本地CSV文件。整个过程涵盖HTTP请求、Header防封配置、DOM树解析以及结构化落盘。
import requests
from bs4 import BeautifulSoup
import csv

def fetch_quotes():
    target_url = "https://quotes.toscrape.com/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
    except requests.RequestException as e:
        print(f"网络请求发生异常: {e}")
        return []

    soup = BeautifulSoup(response.text, "lxml")
    quote_elements = soup.select("div.quote")

    results = []
    for item in quote_elements:
        text_elem = item.select_one("span.text")
        author_elem = item.select_one("small.author")
        tags_elems = item.select("div.tags a.tag")

        quote_text = text_elem.get_text(strip=True) if text_elem else ""
        author_name = author_elem.get_text(strip=True) if author_elem else ""
        tags = [t.get_text(strip=True) for t in tags_elems]

        results.append({
            "quote": quote_text,
            "author": author_name,
            "tags": "; ".join(tags)
        })

    return results

def save_to_csv(data, filename="quotes.csv"):
    if not data:
        print("未采集到数据,跳过导出。")
        return

    with open(filename, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["quote", "author", "tags"])
        writer.writeheader()
        writer.writerows(data)
    print(f"成功保存 {len(data)} 条数据至 {filename}")

if __name__ == "__main__":
    extracted_data = fetch_quotes()
    save_to_csv(extracted_data)
timeout参数。若省略超时设置,当远程服务器建立连接后陷入静默挂起状态时,Python进程将陷入无限阻塞,从而导致后续调度完全停滞。
二、从脚本到工程:单体爬虫面临的规模化瓶颈
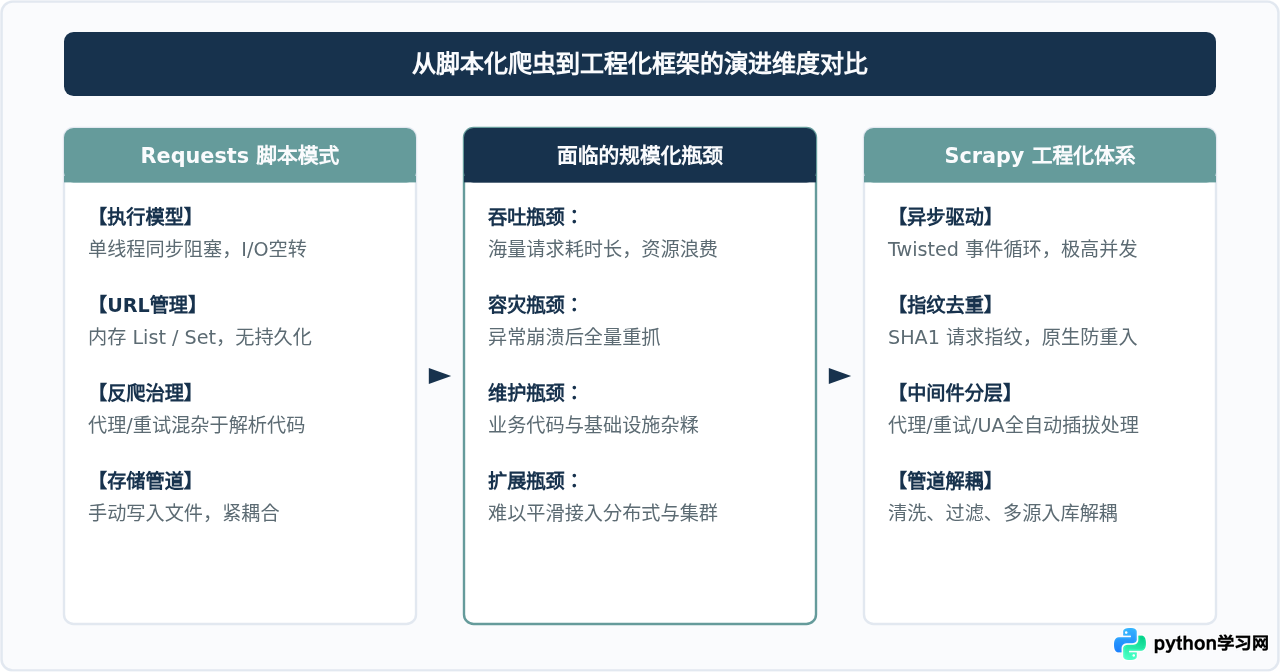
当需求从“抓取1个页面”扩展为“抓取整站数万个页面”时,基于Requests的简单脚本会迅速暴露出以下系统性缺陷:
- I/O同步阻塞与并发效率低下:Requests底层基于同步阻塞I/O。若页面网络延迟为0.5秒,单线程顺序抓取10,000个页面需要将近1.4小时。虽然可通过
concurrent.futures引入多线程池,但线程开销较大,且线程安全队列、速率限制与全局状态维护较为繁琐。 - 缺乏工业级去重与断点续爬:多页循环容易产生环路。自行在内存中使用
set()保存已访问URL,随着URL数量激增不仅耗尽内存,一旦脚本意外中断,抓取进度全部丢失,缺乏持久化调度机制。 - 反爬与异常重试逻辑侵入业务:IP代理池轮换、请求头随机切换、指数退避重试、Cookie会话维持等代码如果与HTML解析混杂在同一个函数中,会导致代码严重耦合,维护极其困难。
三、Scrapy 架构解析:核心组件与事件流转机制
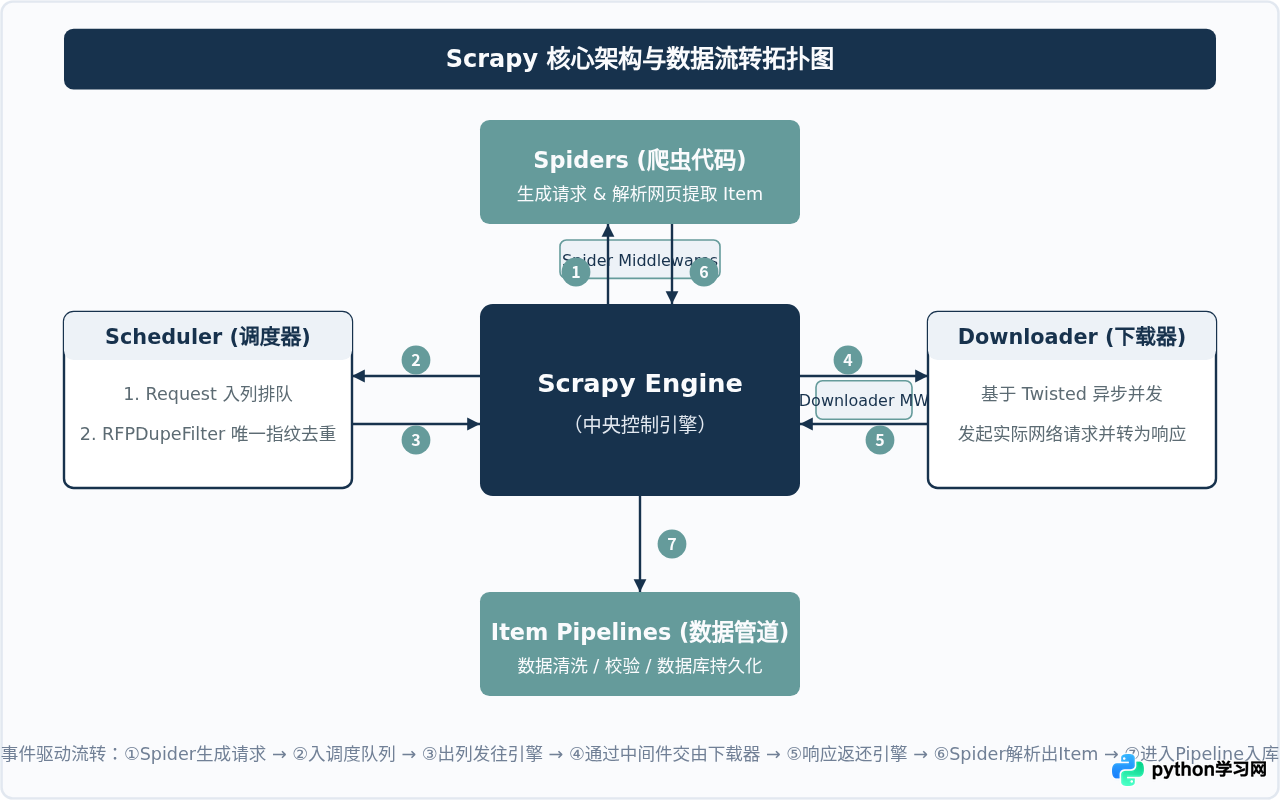
Scrapy之所以能支撑大规模爬取,核心在于它基于Twisted事件驱动引擎实现的高度解耦架构。开发者只需要专注于编写网页解析规则,网络传输、队列调度和数据清洗均由框架各司其职:
- Scrapy Engine(引擎):框架的心脏,负责控制所有组件之间的数据信号流转,触发各种事件回调。
- Spiders(爬虫模块):开发者编写的核心逻辑。负责初始URL的注入、解析Response以及产出结构化Item或新的Request。
- Scheduler(调度器):负责接收引擎转发的请求,进行URL指纹去重并根据优先级排队入列。
- Downloader(下载器):基于异步I/O高效下载网页,将生成的Response返回给引擎。
- Item Pipeline(数据管道):负责对爬虫抽取出的数据进行清洗、数据校验、去重以及写入数据库(如MySQL、MongoDB、Elasticsearch)。
- Downloader/Spider Middlewares(中间件):位于引擎与下载器/爬虫之间的钩子插件,集中处理请求头注入、代理轮换、异常重试或响应解压缩。
四、Scrapy 进阶实战:工业级多页翻页与管道工程案例
下面我们把前面的名言采集任务重构为标准Scrapy工程,演示自动翻页抽取、数据清洗管道以及并发配置规范。
1. 创建Scrapy项目工程
通过命令行工具初始化标准工程结构:
pip install scrapy
scrapy startproject quotes_project
cd quotes_project
生成的工程目录如下:
quotes_project/
├── quotes_project/
│   ├── __init__.py
│   ├── items.py          # 数据结构体定义
│   ├── middlewares.py    # 爬虫/下载器中间件
│   ├── pipelines.py      # 数据管道与持久化
│   ├── settings.py       # 运行配置与并发策略
│   └── spiders/
│       ├── __init__.py
│       └── quotes.py     # 爬虫规则与解析核心
└── scrapy.cfg            # 部署配置文件
2. 定义数据模型(items.py)
通过统一的Field定义,避免字段名散落在解析代码中导致的数据缺失或拼写错误:
import scrapy

class QuoteItem(scrapy.Item):
    quote = scrapy.Field()   # 名言内容
    author = scrapy.Field()  # 作者名字
    tags = scrapy.Field()    # 分类标签列表
3. 实现爬虫解析与多页翻页(spiders/quotes.py)
在Spider中,我们利用Scrapy内置的高性能CSS选择器抽取内容,并通过response.follow实现自动化多页跟踪:
import scrapy
from quotes_project.items import QuoteItem

class QuotesSpider(scrapy.Spider):
    name = "quotes"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["https://quotes.toscrape.com/"]

    def parse(self, response):
        # 遍历当前页所有名言卡片
        for quote_node in response.css("div.quote"):
            item = QuoteItem()
            item["quote"] = quote_node.css("span.text::text").get(default="").strip()
            item["author"] = quote_node.css("small.author::text").get(default="").strip()
            item["tags"] = quote_node.css("div.tags a.tag::text").getall()
            yield item

        # 提取下一页按钮链接
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            # response.follow 自动拼接相对路径并保留请求上下文
            yield response.follow(next_page, callback=self.parse)
4. 数据清洗与落盘管道(pipelines.py)
通过Pipeline实现关注点分离。我们在这里进行数据校验,并将格式化后的数据持续追加至JSON Lines文件中:
import json
from scrapy.exceptions import DropItem

class CleanAndSavePipeline:
    def open_spider(self, spider):
        self.file = open("scraped_quotes.jsonl", "w", encoding="utf-8")
        self.total_count = 0

    def close_spider(self, spider):
        self.file.close()
        spider.logger.info(f"爬虫已停止,共计持久化处理 {self.total_count} 条有效数据。")

    def process_item(self, item, spider):
        # 过滤无效空数据
        if not item.get("quote"):
            raise DropItem("名言字段为空,放弃该条记录")

        # 数据清洗:修剪特殊引号
        clean_text = item["quote"].replace("“", "").replace("”", "").strip()
        item["quote"] = clean_text

        # 写入文件
        line = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(line)
        self.total_count += 1
        return item
5. 关键运行配置(settings.py)
在配置文件中激活数据管道,并配置对目标站点友好的并发与下载延迟:
BOT_NAME = "quotes_project"
SPIDER_MODULES = ["quotes_project.spiders"]
NEWSPIDER_MODULE = ["quotes_project.spiders"]

# 遵守 robots.txt 规范(按需配置)
ROBOTSTXT_OBEY = True

# 并发与请求延迟控制(防止对目标服务器造成冲击)
CONCURRENT_REQUESTS = 8
DOWNLOAD_DELAY = 0.5
COOKIES_ENABLED = False

# 请求头配置
DEFAULT_REQUEST_HEADERS = {
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
}

# 启用数据管道(数值越小优先级越高)
ITEM_PIPELINES = {
    "quotes_project.pipelines.CleanAndSavePipeline": 300,
}
在项目根目录下执行爬虫启动命令:
scrapy crawl quotes
执行后终端将输出完整的引擎运行指标日志,包含请求成功数、下载字节数、Pipeline处理条数等统计信息,数据自动完成翻页直至最后一页。
五、技术选型与适用场景决策矩阵
在实际企业业务或个人项目中,选择Requests还是Scrapy并非“谁替代谁”的单选,而是取决于任务规模、开发周期和团队维护成本。
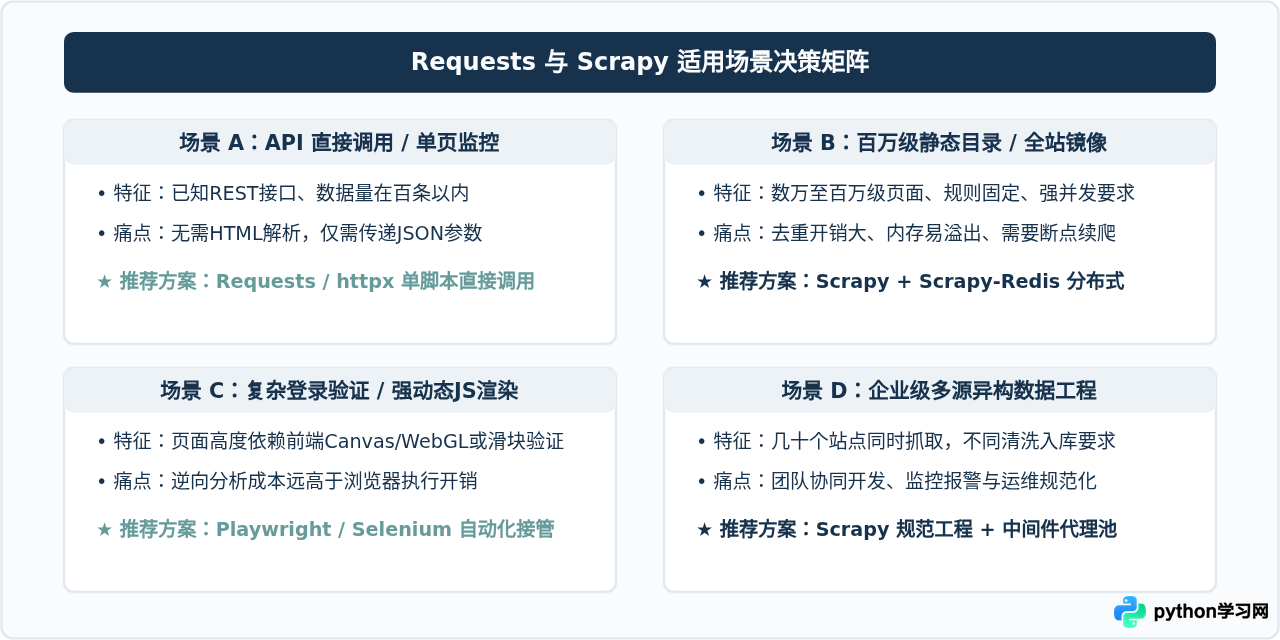
| 对比维度 | Requests + BeautifulSoup | Scrapy 框架 |
|---|---|---|
| 学习与上手曲线 | 极低,5分钟即可写出运行原型 | 中等,需理解组件流转与面向对象规范 |
| 并发与吞吐能力 | 同步阻塞(需自建线程池/进程池) | 基于Twisted异步事件循环,极高并发 |
| 代码结构与解耦 | 单文件脚本,容易造成逻辑混乱 | 严格分层(Spider、Item、Pipeline、Middleware) |
| 内置支持能力 | 仅基础网络请求与响应封装 | 内置选择器、指纹去重、Feed导出、Telnet监控 |
| 分布式扩展 | 需自行实现消息队列与锁控制 | 成熟生态(如直接挂载 scrapy-redis) |
六、总结与实战建议
从Requests到Scrapy,本质上是从“功能实现”向“工程治理”的思维跃迁。在日常开发中,建议遵循以下实践策略:
先用Requests快速摸清目标网站的接口规则、请求头特征和反爬机制。如果数据量有限且是一次性任务,直接完成落盘即可;若采集目标涉及多层翻页、百万级体量、长效定时更新或多源入库,应果断采用Scrapy组织项目结构。合理配置下载延迟与并发限制,在高效获取公开数据的同时,保证爬虫程序的健壮性与合规性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









