

Python中list去重为什么推荐用set?性能对比与适用场景分析
深度解析Python中列表去重为什么优先推荐使用set。通过底层哈希表原理、时间复杂度推导、多种去重方案性能实测对比,系统梳理保持原有顺序与处理不可哈希对象时的最佳实践方案。
在 Python 日常开发中,对列表(list)去除重复元素是一项非常高频的操作。当开发者询问如何去重时,绝大多数经验丰富的工程师和教程都会优先推荐 list(set(raw_list)) 这一简洁写法。其核心优势在于:集合(set)底层基于高效的哈希表结构实现,去重整体时间复杂度仅为 O(N),在大数据量下相比列表循环遍历的 O(N²) 具有数百甚至上万倍的性能提升。然而,set 去重并不是万能的银弹,它具有“无序性”以及“要求元素必须可哈希”两大关键限制。本文将从底层底层原理、执行流程、性能压测对比及实际业务选型四个维度展开深度分析。
一、为什么推荐用 set?底层机制与复杂度剖析
为了理解为什么优先推荐 set,我们需要对比列表与集合在底层查找元素时的机制差异。
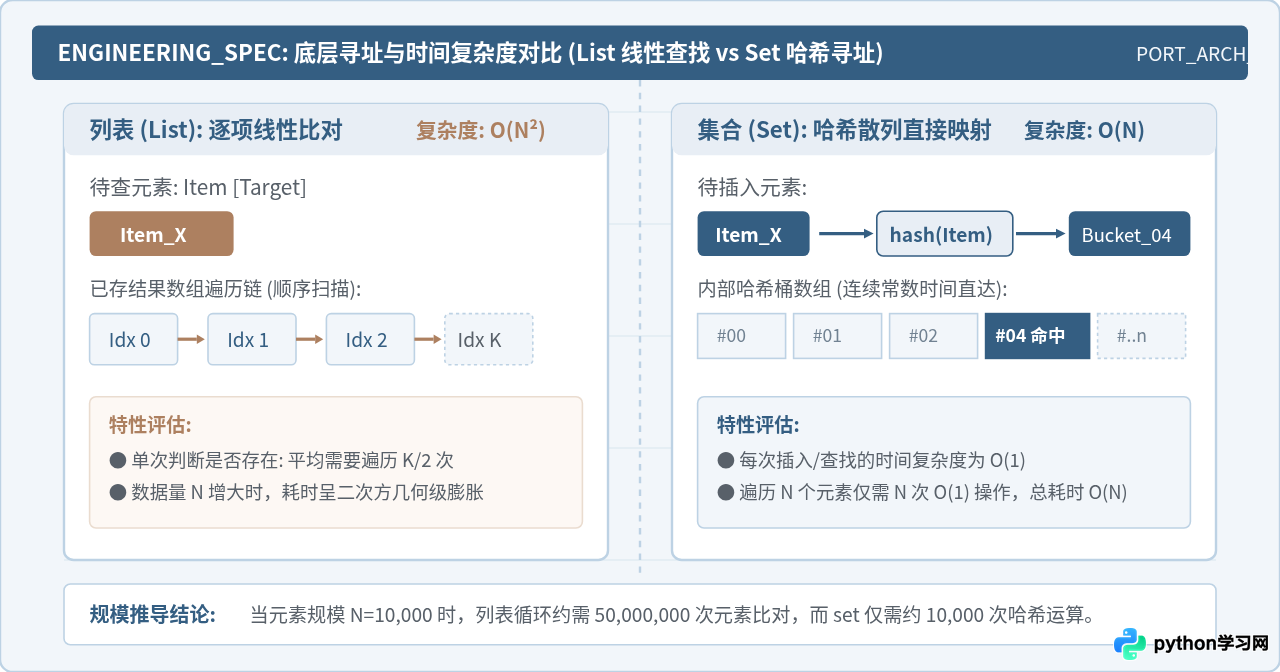
如果使用传统的列表遍历方式去重,常规思路是建立一个新列表,依次遍历原列表中的每个元素,并通过 if item not in unique_list: 判断是否追加。在 Python 中,列表的底层是连续内存数组,item in unique_list 的本质是从头到尾的线性遍历(Linear Search),单次查找的时间复杂度是 O(K)(K 为当前结果列表长度)。当处理规模为 N 的列表时,嵌套遍历的总比对次数约为 N*(N-1)/2,整体时间复杂度为 O(N²)。
与之相反,Python 的 set 是基于开放寻址法的哈希表(Hash Table)实现的。向集合中插入元素时,解释器会先调用元素的 __hash__() 方法计算出哈希值,再映射到对应的哈希桶(Bucket)索引中。因此,集合判断一个元素是否已经存在的平均时间复杂度仅为 O(1)。利用 set() 构造集合时,遍历原列表插入集合耗时 O(N),再用 list() 将集合转回列表也是 O(N),整体时间复杂度稳稳保持在 O(N)。
二、使用 set 去重的标准操作流程与步骤拆解
在 Python 中,通过 set 进行去重仅需一行代码,其标准调用形式如下:
# 原始带有重复元素的列表
raw_data = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]

# 执行 set 去重并重新转为列表
unique_data = list(set(raw_data))

print("去重前元素个数:", len(raw_data))
print("去重后元素结果:", unique_data)
# 示例输出(注意元素顺序可能被重排):
# 去重前元素个数: 11
# 去重后元素结果: [1, 2, 3, 4, 5, 6, 9]
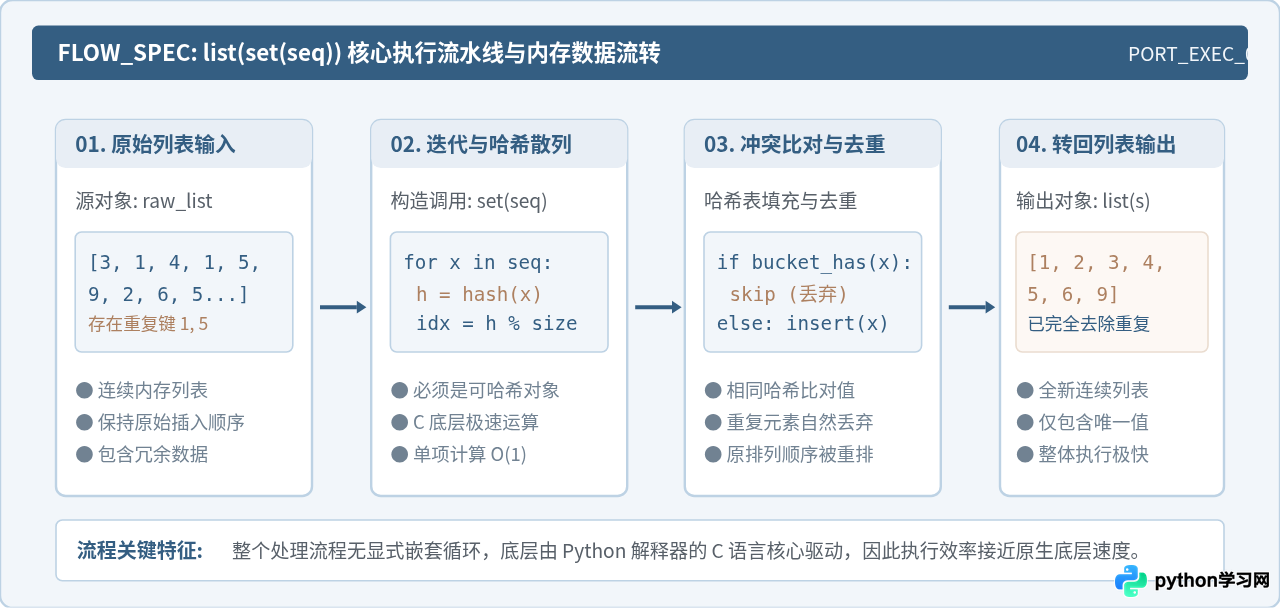
虽然这行代码非常简短,但在 Python 虚拟机底层完整经历了四个清晰的执行阶段:
- 输入解析与内存分配:读取原始
raw_data列表指针,根据其长度预估初始集合哈希表的大小。 - 迭代计算与散列寻址:底层循环遍历列表。针对每一个元素,调用
hash()计算哈希值并定位哈希桶。 - 冲突判定与去重过滤:如果哈希桶为空,则直接写入;如果已有元素,则调用
__eq__()比对是否相等。相等则直接忽略该元素,达成去重;若不相等则通过二次探测法解决哈希冲突。 - 迭代导出并封装为 List:调用
list()构造器,遍历集合中的已存储项,顺序打包写入全新的列表对象并返回。
三、常见去重方法与性能深度对比
为了全面评估性能,除了 list(set(x)),日常开发中还有另外三种常见的去重方式:
- 方法 1:遍历 + 列表检查(朴素法)
通过res = []; [res.append(i) for i in seq if i not in res]实现。优点是天然保持原始顺序,但由于not in res为列表线性查找,整体时间复杂度为O(N²)。 - 方法 2:集合去重(推荐法)
即list(set(seq))。时间复杂度为O(N),代码量最少,运行速度最快,但会打乱原有顺序。 - 方法 3:字典键去重(保序推荐法)
即list(dict.fromkeys(seq))。在 Python 3.7+ 中,语言官方规范正式保证字典维持插入顺序。由于字典底层同样基于哈希表,其去重时间复杂度也是O(N),且能完美保留原始顺序。 - 方法 4:列表推导结合 set 标记(兼容保序法)
利用辅助 set:seen = set(); [x for x in seq if not (x in seen or seen.add(x))]。时间复杂度同样为O(N),保持顺序,常用于对早期 Python 版本的向后兼容。
不同数据规模下的耗时实测对比
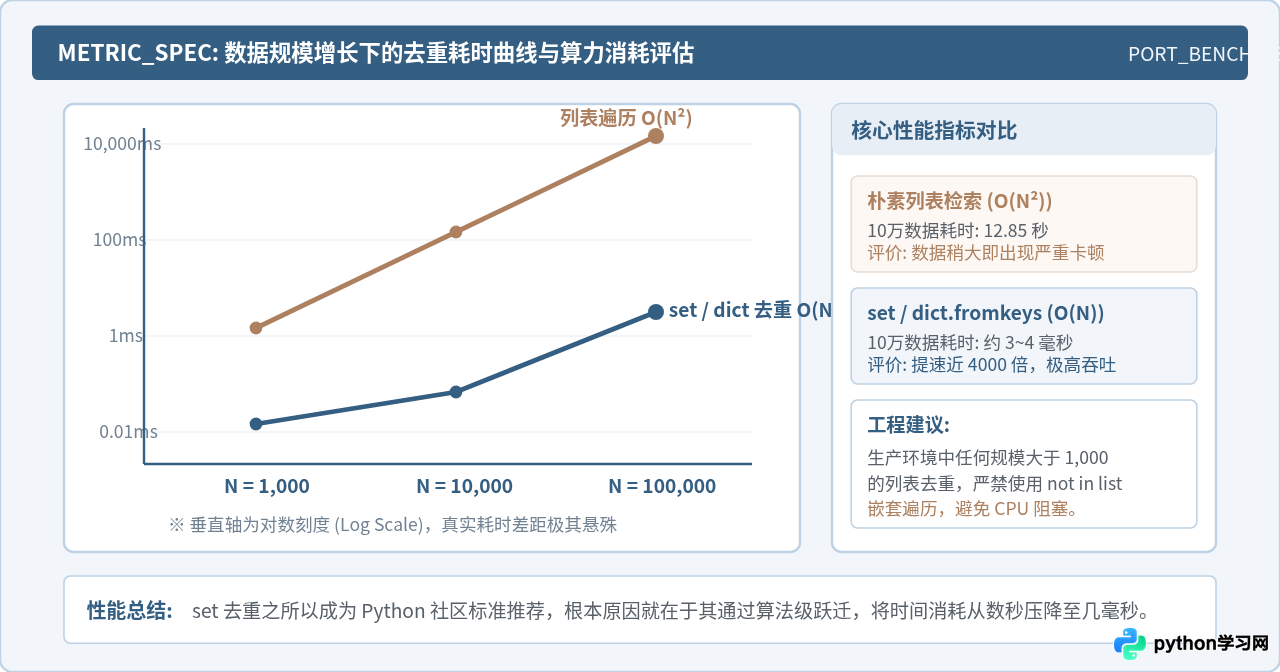
以下为在典型 64 位 Python 3 环境下,对包含约 20% 重复率的整数列表进行 100 次基准测试所得的平均耗时统计:
| 去重方法 | 底层时间复杂度 | 1,000 条数据 | 10,000 条数据 | 100,000 条数据 | 是否保持原顺序 |
|---|---|---|---|---|---|
| 朴素列表循环 (for + not in list) | O(N²) | 1.25 ms | 116.4 ms | 12.85 s (暴增) | 保持顺序 |
| list(set(seq)) 集合法 | O(N) | 0.021 ms | 0.24 ms | 3.12 ms | 不保持顺序 |
| list(dict.fromkeys(seq)) 字典法 | O(N) | 0.034 ms | 0.38 ms | 4.45 ms | 保持顺序 (Python 3.7+) |
| 列表推导 + seen.add 辅助 | O(N) | 0.062 ms | 0.72 ms | 8.90 ms | 保持顺序 |
四、set 去重的局限性与四大典型场景选型
尽管 list(set(seq)) 速度极致,但并非所有场景都能无脑套用。在实际工程落地时,需要重点审查以下两大限制:
1. 不保留原有顺序:集合是根据哈希桶分布存储元素的,转回列表后,元素的索引顺序很可能与原始列表截然不同。
2. 元素必须可哈希(Hashable):如果列表中包含字典
dict、列表 list 或集合 set,调用 set() 会直接触发 TypeError: unhashable type: 'dict'。
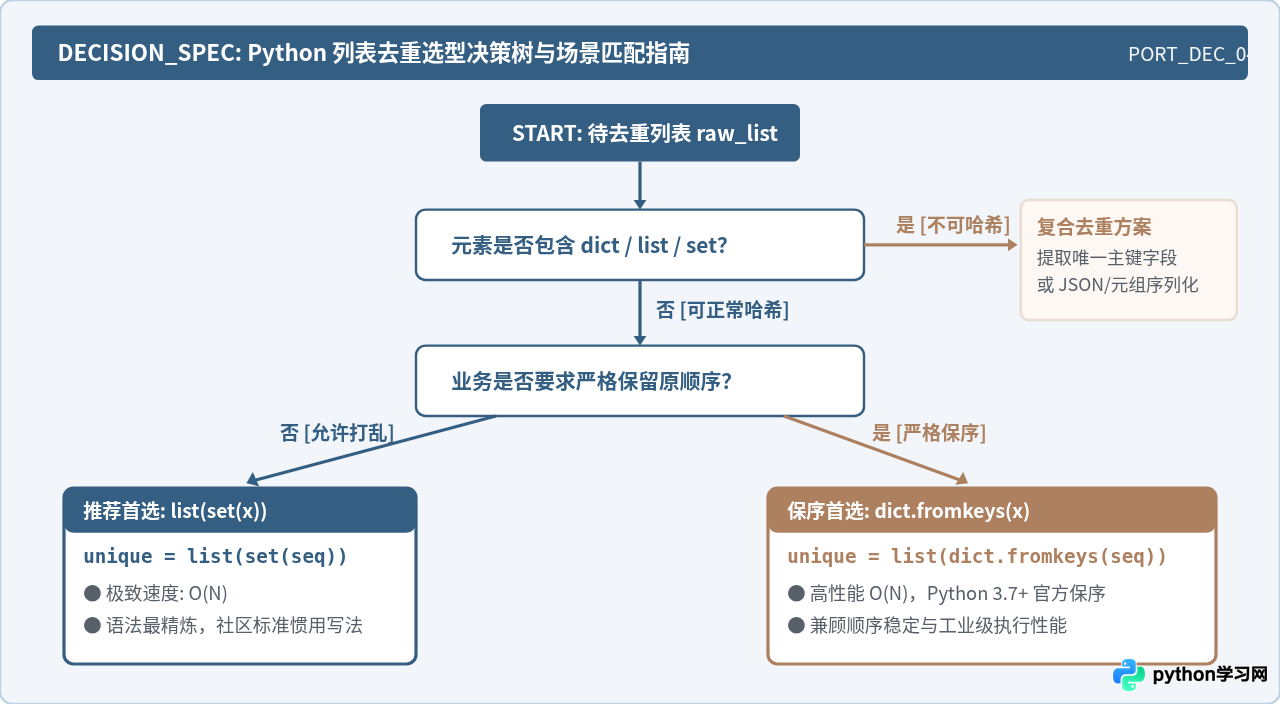
场景 1:无序要求的高性能去重(推荐 set)
当业务对列表元素的前后顺序毫无依赖时(例如:获取已注册用户 ID 集合、统计涉及的唯一标签、集合论运算),list(set(raw_list)) 是无可争议的最优解,代码简短且执行速度最快。
场景 2:必须严格保持原有顺序(推荐 dict.fromkeys)
如果业务要求去重后必须保留元素首次出现的先后顺序(例如:日志时间线去重、搜索推荐候选集排序),切勿使用 set。此时最推荐使用 dict.fromkeys():
raw_tags = ['python', 'golang', 'python', 'rust', 'golang', 'java']

# 保持顺序去重 (Python 3.7+ 官方保序)
ordered_tags = list(dict.fromkeys(raw_tags))

print(ordered_tags)
# 稳定输出: ['python', 'golang', 'rust', 'java']
dict.fromkeys() 底层同样是哈希表,整体时间复杂度为 O(N),耗时仅比 set 多出微乎其微的字典头开销,但能够 100% 确保顺序不变,是目前 Python 中保序去重的事实标准。
场景 3:列表中包含不可哈希对象(如字典列表去重)
如果列表中存放的是字典或复合对象,直接调用 set() 会崩溃。此时应通过提取唯一字段(如 ID),配合辅助 set 进行去重过滤:
user_records = [
    {"id": 101, "name": "Alice"},
    {"id": 102, "name": "Bob"},
    {"id": 101, "name": "Alice_Duplicate"}
]

# 方案:根据唯一键提取并保序去重
seen_ids = set()
unique_users = []
for user in user_records:
    if user["id"] not in seen_ids:
        seen_ids.add(user["id"])
        unique_users.append(user)

print(unique_users)
# 成功按 id 去重,且保持原始输入顺序
场景 4:内存受限场景下的权衡
set 和 dict 属于空间换时间的数据结构。为了保证极低的哈希冲突率,Python 的集合在装载率达到 2/3 左右时就会触发自动扩容,其内存开销通常是紧凑连续列表的 2 到 4 倍。如果运行环境内存极度受限(如嵌入式设备)且数据量极小(N < 50),使用简单的列表遍历也是可以接受的折中方案。
五、全文总结
在 Python 中去除列表重复项时,优先推荐使用 set 的根本原因在于底层算法复杂度的降维:利用哈希表的 O(1) 平均寻址能力,将去重总时间从朴素遍历的 O(N²) 压缩到了线性的 O(N)。这使得在面对成千上万条数据时,程序不会因为简单的去重操作而陷入性能瓶颈。
在实际工程选型中,请记住以下精炼准则:
- 默认首选(无序):直接使用
list(set(seq)),速度最快,书写最自然。 - 保持顺序(有序):在 Python 3.7+ 下直接使用
list(dict.fromkeys(seq)),既拥有O(N)级别高效率,又能保留首次出现的相对顺序。 - 复合类型(不可哈希):针对包含字典或列表的复合数据,结合业务提取唯一键并搭配
seen = set()进行高效筛选。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









