

Python collections模块常用数据结构:deque、Counter与defaultdict用法
深入讲解Python标准库collections模块中最常用的三个数据结构:deque双端队列、Counter计数器以及defaultdict默认字典。涵盖底层原理、核心API、完整代码示例与选型指南。
在日常Python开发中,内置的 list 与 dict 能够应对绝大部分常规需求,但在面对频繁的头部插入弹出、高频词频统计或者多级键分组时,原生容器往往需要编写冗余的防御性代码,甚至引发性能瓶颈。Python标准库中的 collections 模块针对这些常见场景,提供了三个经过底层高度优化的专用数据结构:双端队列 deque、计数器 Counter 与 默认字典 defaultdict。掌握这三个工具不仅能简化代码逻辑,还能直接带来执行效率的成倍提升。
双端队列 collections.deque:高效的两端增删
Python 原生 list 是基于连续内存块的动态数组。当在列表尾部追加或弹出元素时,时间复杂度为 \(O(1)\);但若在列表头部执行 list.insert(0, val) 或 list.pop(0),底层必须移动其后所有元素,导致时间复杂度飙升至 \(O(n)\)。当数据规模达到数十万量级时,头部操作会产生严重的延迟。
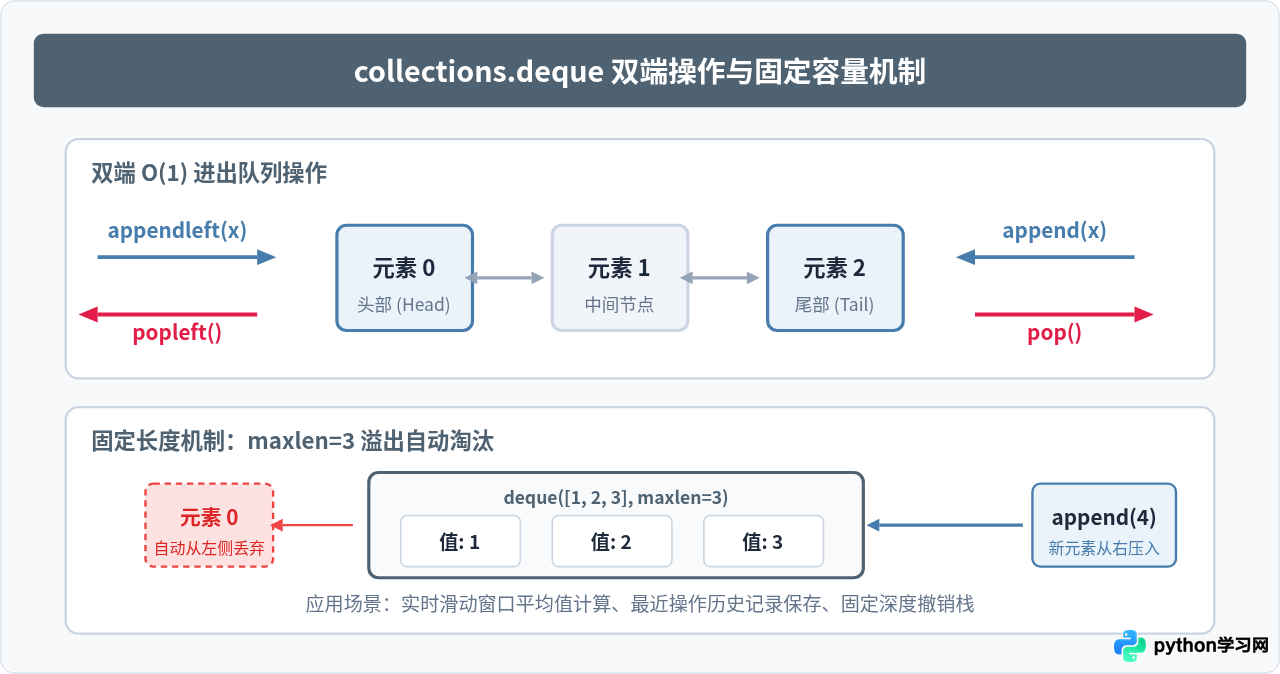
collections.deque(Double-Ended Queue)底层基于双向块列表(B-Tree链表块)构建,专为两端的高效增删而设计。无论在前端还是后端进行插入与弹出,其时间复杂度均为恒定的 \(O(1)\)。
核心方法与代码示例
deque 提供了与 list 对应的双端扩展接口:
append(x)与appendleft(x):分别在右端和左端追加元素。pop()与popleft():分别从右端和左端弹出元素。extend(iterable)与extendleft(iterable):批量扩展元素。注意extendleft会逆序逐个推入左侧。rotate(n):将队列整体向右循环滚动 \(n\) 步;若 \(n\) 为负数则向左滚动。
from collections import deque

# 1. 基础双端操作
d = deque(['b', 'c', 'd'])
d.append('e')          # 右侧追加
d.appendleft('a')      # 左侧头部追加
print("追加后队列:", d)

left_item = d.popleft()  # 头部高效弹出
right_item = d.pop()     # 尾部高效弹出
print("弹出元素:", left_item, right_item)
print("剩余队列:", d)

# 2. 队列旋转与批量扩展
d.rotate(1)            # 向右轮转1位
print("向右旋转1位:", d)

# 3. 固定容量窗口 (maxlen)
window = deque(maxlen=3)
for num in [10, 20, 30, 40, 50]:
    window.append(num)
    print(f"压入 {num} -> 窗口内容: {list(window)}")
弹出元素: a e
剩余队列: deque(['b', 'c', 'd'])
向右旋转1位: deque(['d', 'b', 'c'])
压入 10 -> 窗口内容: [10]
压入 20 -> 窗口内容: [10, 20]
压入 30 -> 窗口内容: [10, 20, 30]
压入 40 -> 窗口内容: [20, 30, 40]
压入 50 -> 窗口内容: [30, 40, 50]
deque 优化的核心在于两端操作(两端为 \(O(1)\))。如果需要对中间元素进行随机查找(例如 d[5000])或切片操作,deque 必须从最近的端点遍历链表节点,时间复杂度退化为 \(O(n)\)。若核心业务是随机索引定位,应继续使用原生 list。
计数器 collections.Counter:频次统计与多重集运算
统计序列中各项出现的频次是极常见的任务。如果使用标准字典,通常需要循环遍历并手动执行 d[item] = d.get(item, 0) + 1。这种写法较为繁杂且未能在底层针对统计过程进行优化。
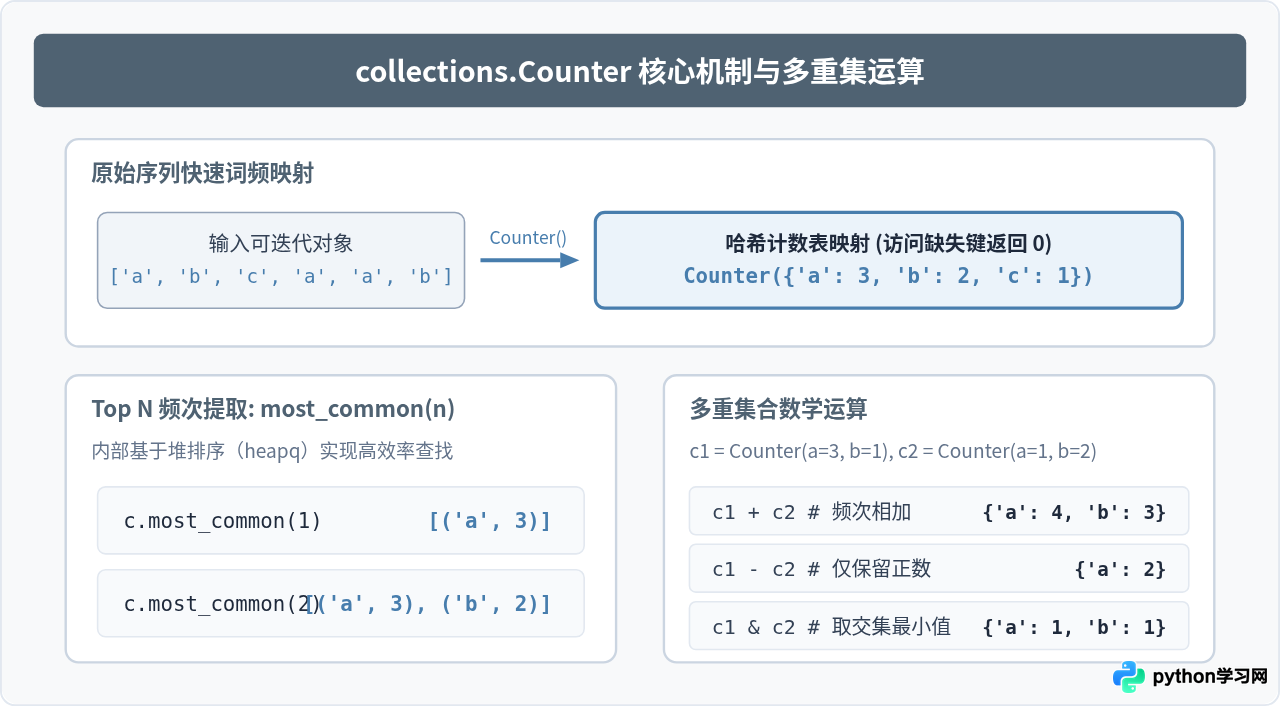
collections.Counter 是 dict 的子类,专门用于跟踪可哈希对象的频次映射。它不仅能一行代码完成统计,还重载了数学运算符以支持多重集合(Multiset)的交集、并集和加减计算。
核心方法与代码示例
Counter 的常用接口与行为特点如下:
- 缺失键默认返回 0:访问不存在的键时,返回
0而非触发KeyError。 most_common(n):按频次从高到低排列,返回前 \(n\) 个(key, count)元组。elements():返回一个迭代器,将每个键按其计数值重复还原展开。update(iterable)与subtract(iterable):对计数值进行原地增量或减量。
from collections import Counter

text = "apple banana apple cherry date banana apple"
words = text.split()

# 1. 快速构建词频映射
counter = Counter(words)
print("各单词频次:", counter)

# 2. 查询缺失键(不报错,返回 0)
print("orange 出现频次:", counter['orange'])

# 3. 提取前两个最高频单词
top_two = counter.most_common(2)
print("频次前二:", top_two)

# 4. 集合运算演示
inventory_a = Counter(apple=10, orange=5, banana=2)
inventory_b = Counter(apple=4, orange=8, pear=3)

# 合并库存
total = inventory_a + inventory_b
print("合并后库存:", total)

# 净剩余(差集:低于或等于0的计数值会被自动剔除)
diff = inventory_a - inventory_b
print("A相对B的富余库存:", diff)
orange 出现频次: 0
频次前二: [('apple', 3), ('banana', 2)]
合并后库存: Counter({'orange': 13, 'apple': 14, 'pear': 3, 'banana': 2})
A相对B的富余库存: Counter({'apple': 6, 'banana': 2})
c1 - c2 运算符时,结果会自动过滤掉计数小于或等于 0 的键;如果你的业务需要保留 0 或负数计数(例如资产盈亏统计),应调用 c1.subtract(c2) 原地方法。
默认字典 collections.defaultdict:杜绝 KeyError 与优雅分组
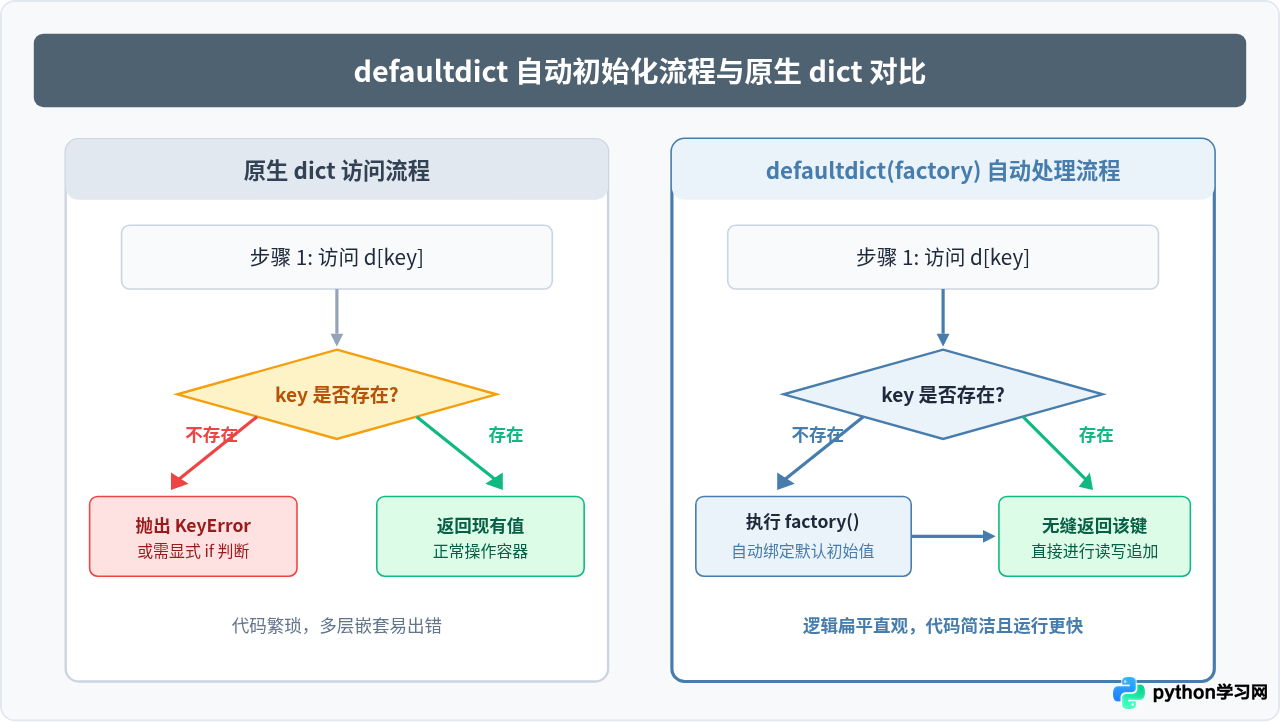
处理数据分组(如按类别归类列表、按部门聚合员工)时,使用普通字典面临经典问题:首次遇到某个键时,必须判断该键是否存在,否则执行 d[key].append(item) 会抛出 KeyError。虽然原生字典提供了 dict.setdefault(),但该方法无论键是否存在都会先对默认值表达式进行求值,且语法在多层嵌套时较为繁琐。
collections.defaultdict 在初始化时接收一个可调用对象(工厂函数 default_factory)。当通过 d[key] 访问一个不存在的键时,它会自动调用该工厂函数生成默认值,将键值对写入字典并直接返回,从而彻底消除分支判断。
常用工厂类型与代码示例
工厂函数可以是任何无需传参即可调用的对象(Callable):
defaultdict(list):默认值为新列表[],是实现一对多分类归纳的最佳方案。defaultdict(int):默认值为整数0,常用于数值累加或计数。defaultdict(set):默认值为新集合set(),用于自动去重归类。- 嵌套字典:
defaultdict(lambda: defaultdict(list))可轻松实现多层自动嵌套结构。
from collections import defaultdict

# 示例 1: 按部门归纳员工名单 (工厂为 list)
employees = [
    ('研发部', '张三'),
    ('市场部', '李四'),
    ('研发部', '王五'),
    ('设计部', '赵六'),
    ('研发部', '钱七')
]

dept_members = defaultdict(list)
for dept, name in employees:
    # 无需判断 dept 是否在字典中,直接 append
    dept_members[dept].append(name)

print("部门成员归纳:")
for dept, names in dept_members.items():
    print(f"  {dept}: {names}")

# 示例 2: 标签去重归纳 (工厂为 set)
post_tags = [
    ('post1', 'python'),
    ('post2', 'web'),
    ('post1', 'python'),  # 重复标签
    ('post1', 'backend')
]

tag_map = defaultdict(set)
for post, tag in post_tags:
    tag_map[post].add(tag)

print("\n文章去重标签:")
for post, tags in tag_map.items():
    print(f"  {post}: {tags}")
研发部: ['张三', '王五', '钱七']
市场部: ['李四']
设计部: ['赵六']
文章去重标签:
post1: {'backend', 'python'}
post2: {'web'}
d[key] 语法读取一个不存在的键时,defaultdict 会隐式向字典中注入该键并赋值。如果你的意图仅仅是“判断某个键是否已经存在”,请使用 key in d;若只想在键不存在时返回默认值而不写入字典,请使用 d.get(key, default)。
综合实战与选型指南
为了让知识能够直接转化为生产力,我们来看一个综合实战案例:在处理服务器实时日志时,同时应用这三种容器。
- 使用
deque(maxlen=3)保留系统最新的 3 条告警日志。 - 使用
Counter统计各类 HTTP 响应状态码的分布。 - 使用
defaultdict(list)按 IP 地址归纳其所有的请求路径。
from collections import deque, Counter, defaultdict

raw_logs = [
    {"ip": "192.168.1.10", "path": "/login", "status": 200, "level": "INFO"},
    {"ip": "192.168.1.11", "path": "/api/pay", "status": 500, "level": "ERROR"},
    {"ip": "192.168.1.10", "path": "/index", "status": 200, "level": "INFO"},
    {"ip": "192.168.1.12", "path": "/admin", "status": 403, "level": "WARN"},
    {"ip": "192.168.1.11", "path": "/api/retry", "status": 500, "level": "ERROR"},
    {"ip": "192.168.1.13", "path": "/export", "status": 504, "level": "ERROR"},
]

# 1. 初始化容器
recent_errors = deque(maxlen=2)   # 仅保留最近 2 条错误记录
status_counter = Counter()        # 统计状态码频次
ip_routes = defaultdict(list)     # 按 IP 聚合访问路径

# 2. 流水线式处理日志
for log in raw_logs:
    status_counter[log["status"]] += 1
    ip_routes[log["ip"]].append(log["path"])
    if log["level"] == "ERROR":
        recent_errors.append(log)

# 3. 统计结果输出
print("--- HTTP 状态码分布统计 ---")
for status, count in status_counter.items():
    print(f"状态码 {status}: {count} 次")

print("\n--- 最近 2 条错误快照 ---")
for err in recent_errors:
    print(f"[{err['level']}] IP: {err['ip']} 请求 {err['path']} 失败 (状态码 {err['status']})")

print("\n--- 各 IP 访问轨迹 ---")
for ip, paths in ip_routes.items():
    print(f"{ip} -> {paths}")
状态码 200: 2 次
状态码 500: 2 次
状态码 403: 1 次
状态码 504: 1 次
--- 最近 2 条错误快照 ---
[ERROR] IP: 192.168.1.11 请求 /api/retry 失败 (状态码 500)
[ERROR] IP: 192.168.1.13 请求 /export 失败 (状态码 504)
--- 各 IP 访问轨迹 ---
192.168.1.10 -> ['/login', '/index']
192.168.1.11 -> ['/api/pay', '/api/retry']
192.168.1.12 -> ['/admin']
192.168.1.13 -> ['/export']
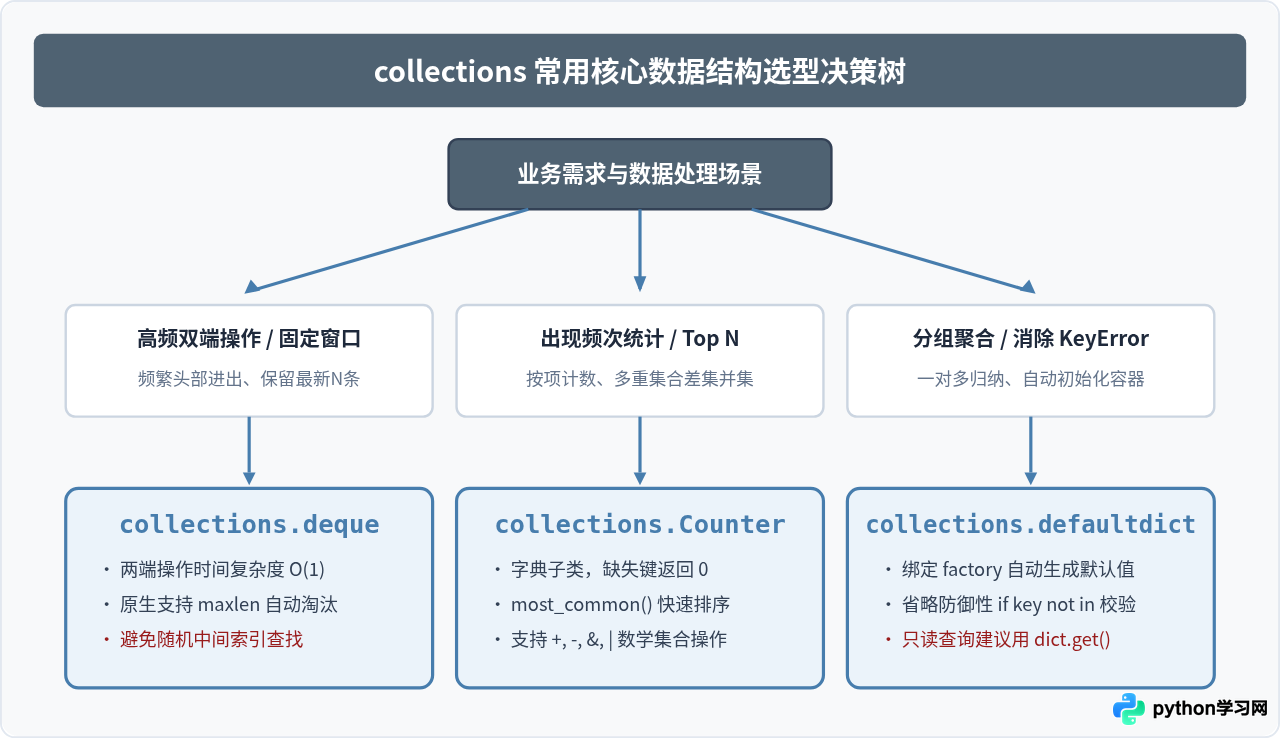
核心特性速查表
| 数据结构 | 底层基础 | 核心优势 | 最佳应用场景 | 主要注意事项 |
|---|---|---|---|---|
| deque | 双向块链表 | 两端入队与出队均为 \(O(1)\),内存局部性良好 | 双端队列、滑动窗口、日志环形缓冲、任务调度 | 中间元素随机索引为 \(O(n)\),不适合高频随机访问 |
| Counter | 哈希字典 | 内置频次统计、堆排取 Top N、多重集合代数运算 | 词频统计、投票聚合、库存比对、差异分析 | - 减法会过滤非正数,保留非正数需用 subtract() |
| defaultdict | 哈希字典 | 按需调用工厂函数自动初始化,消除 KeyError |
一对多数据归类、嵌套配置结构、多级聚合 | 通过 d[key] 查询不存在的键会自动将其存入字典 |
在编写高效Python程序时,合理选用 collections 模块的专用容器,不仅能显著减少重复冗长的样板代码,更能依靠底层C层级的实现优化获得更高的吞吐性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









