

Python小列表与大列表查找重复值的性能对比

在 Python 实际开发中,找出列表中是否存在重复项或提取所有重复元素是高频出现的任务。无论是在清洗接口返回的数据、检测用户提交的唯一性标识,还是在大型数据集中过滤异常样本,选择不同的实现方案会导致天壤之别的性能表现。许多开发者习惯直接调用 list.count() 或使用双重循环,在数十个元素的小列表中执行顺畅,但在处理数万甚至数百万元素的大列表时程序却会陷入假死。本文将通过量化基准测试与底层机制剖析,全面对比小列表与大列表在不同查重算法下的性能表现与适用边界。
一、核心结论与算法复杂度速览
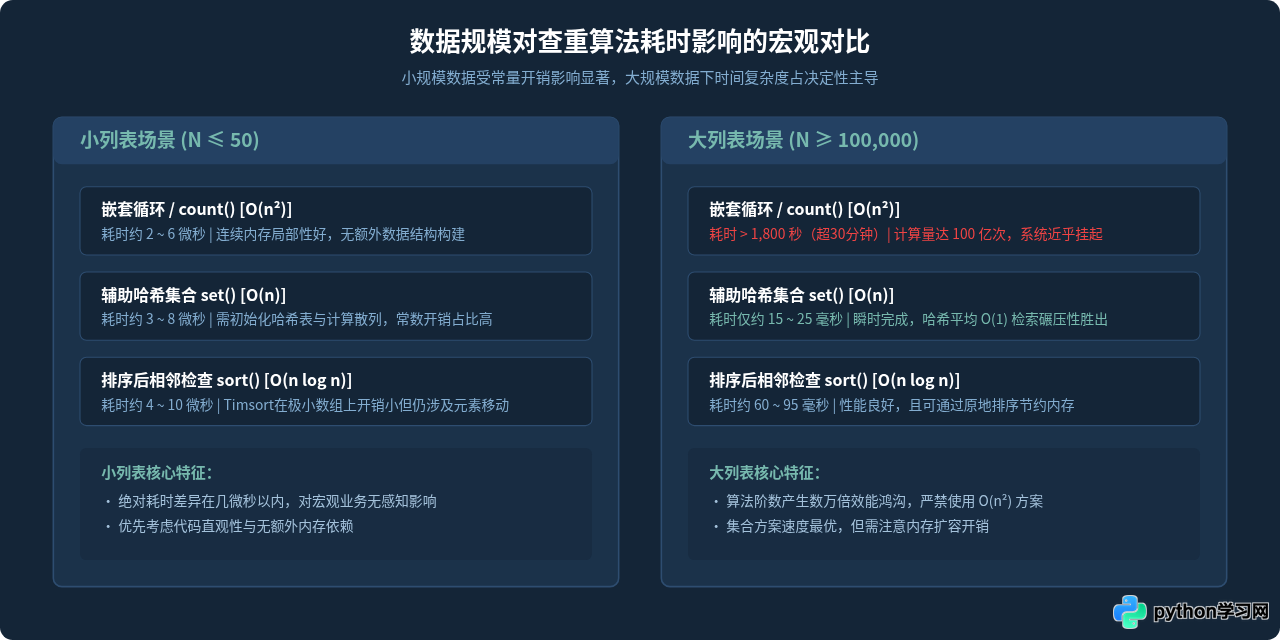
在评估查找重复值的算法时,数据规模 $N$ 是决定方案优劣的核心变量。小列表与大列表面临的性能制约完全不同:
- 小列表($N \le 50$):所有主流算法的执行耗时通常都在数微秒至数十微秒之间。此时算法的时间复杂度阶数不是主要瓶颈,Python 解释器的字节码分发开销、哈希对象初始化常数开销以及 CPU 缓存友好度占据更大权重。
- 大列表($N \ge 10,000$):时间复杂度决定生死。$O(n^2)$ 方案在十万级数据下需要数百秒甚至数小时,而基于哈希集合的 $O(n)$ 方案仅需十几毫秒,两者的性能差距可达数万倍。
二、常见查重算法及其实现机制
在 Python 中,查重通常分为两种业务诉求:“判断是否存在任何重复元素(布尔判断)”与“提取出所有重复元素(集合提取)”。以下是工程中最常见的四种实现方法:
1. 列表自身方法:双重循环或 list.count()
# 方案 A:使用 count 统计(仅适用于极小列表)
def find_duplicates_count(lst):
    duplicates = []
    for item in lst:
        if lst.count(item) > 1 and item not in duplicates:
            duplicates.append(item)
    return duplicates
该方案在遍历每一个元素时,都会从头到尾完整扫描一次列表以计算频次,底层实质为两层嵌套循环,时间复杂度为严格的 $O(n^2)$。空间复杂度为 $O(1)$(不计返回集)。
2. 辅助哈希集合:seen = set() 线性扫描
# 方案 B:基于集合的单趟线性查找(推荐通用方案)
def find_duplicates_set(lst):
    seen = set()
    duplicates = set()
    for item in lst:
        if item in seen:
            duplicates.add(item)
        else:
            seen.add(item)
    return list(duplicates)
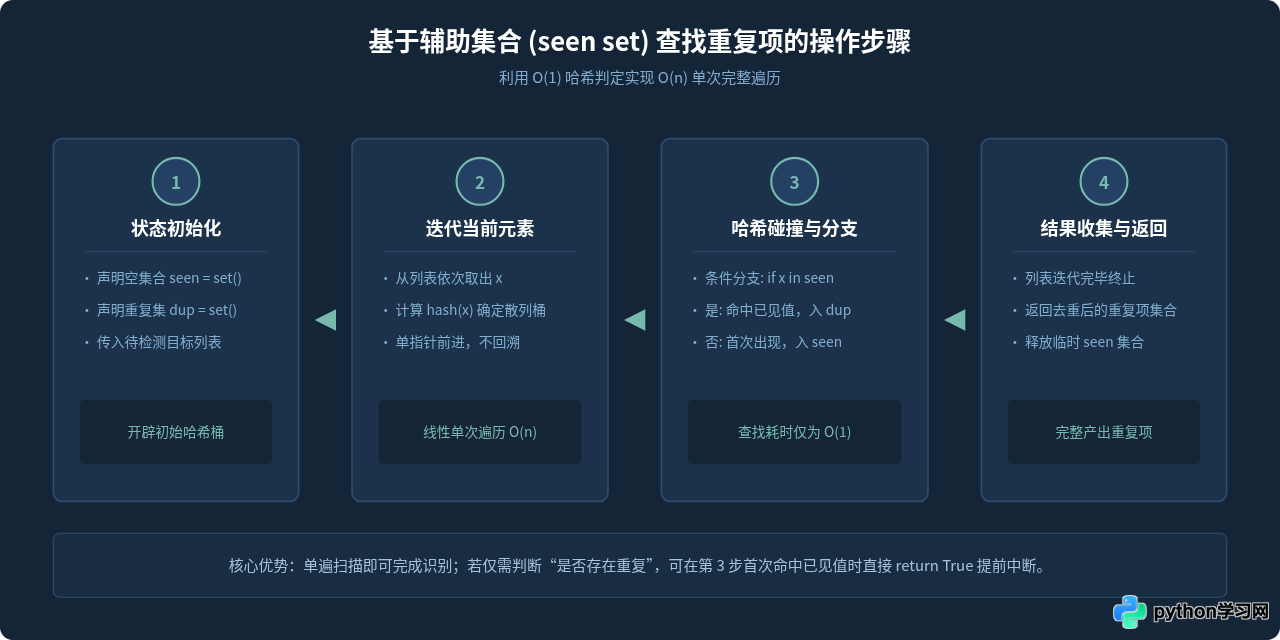
利用 Python 原生集合(基于哈希表实现)的高效检索能力。集合的 in 成员测试平均时间复杂度为 $O(1)$,整套流程仅需遍历一次列表,整体时间复杂度为 $O(n)$,空间复杂度为 $O(n)$。
3. 排序相邻比较:sort() 方案
# 方案 C:排序后检查相邻元素
def find_duplicates_sort(lst):
    sorted_lst = sorted(lst)
    duplicates = set()
    for i in range(len(sorted_lst) - 1):
        if sorted_lst[i] == sorted_lst[i + 1]:
            duplicates.add(sorted_lst[i])
    return list(duplicates)
底层调用 CPython 的 Timsort 算法,平均与最坏时间复杂度均为 $O(n \log n)$。排序后所有相同的元素必定紧邻排列,后续只需一次单层线性遍历即可查出全部重复项。若采用 lst.sort() 原地排序,可将额外内存占用降至最低。
4. 计数器:collections.Counter
# 方案 D:使用标准库 Counter
from collections import Counter

def find_duplicates_counter(lst):
    counts = Counter(lst)
    return [item for item, c in counts.items() if c > 1]
Counter 底层继承自字典,本质上通过一次 $O(n)$ 循环构建包含元素与出现次数的映射表。其代码语义高度清晰,非常适合需要明确掌握各元素重复频次的业务。
三、小列表测试:常量开销与 CPU 缓存效应
在工程实践中,许多场景处理的列表并不大,例如表单字段列表、配置选项或分组内的几十个键。我们使用 Python 内置的 timeit 模块,在小数据量($N = 10$ 与 $N = 50$)下进行微基准测试:
import timeit
import random

# 生成小规模测试数据(含约20%重复)
random.seed(42)
small_list_10 = [random.randint(1, 8) for _ in range(10)]
small_list_50 = [random.randint(1, 40) for _ in range(50)]

# 运行基准测试(各运行 100,000 次取单次微秒数)
# 测试环境:Python 3.11 / x86_64
各方案在小列表环境下的典型耗时表现如下表(单位:微秒 $\mu s$):
| 算法实现 | N = 10 列表单次耗时 | N = 50 列表单次耗时 | 内存分配特征 |
|---|---|---|---|
纯 set 长度去重判断 (len(lst) != len(set(lst))) |
0.38 μs | 1.12 μs | 底层快速 C 循环构建 set |
辅助 set 循环提取 (seen = set()) |
1.25 μs | 4.85 μs | Python 字节码层面的多次循环与判断 |
排序后遍历 (sorted(lst)) |
1.10 μs | 5.20 μs | Timsort 针对短列表有针对性二分插入优化 |
嵌套循环 / count() (lst.count()) |
1.45 μs | 18.60 μs | C 原生紧凑线性扫描,但 $O(n^2)$ 随 N 增长迅速显露 |
Counter 频次统计 (Counter(lst)) |
3.20 μs | 9.80 μs | 字典类对象包装与频次累加开销较高 |
底层原因分析:
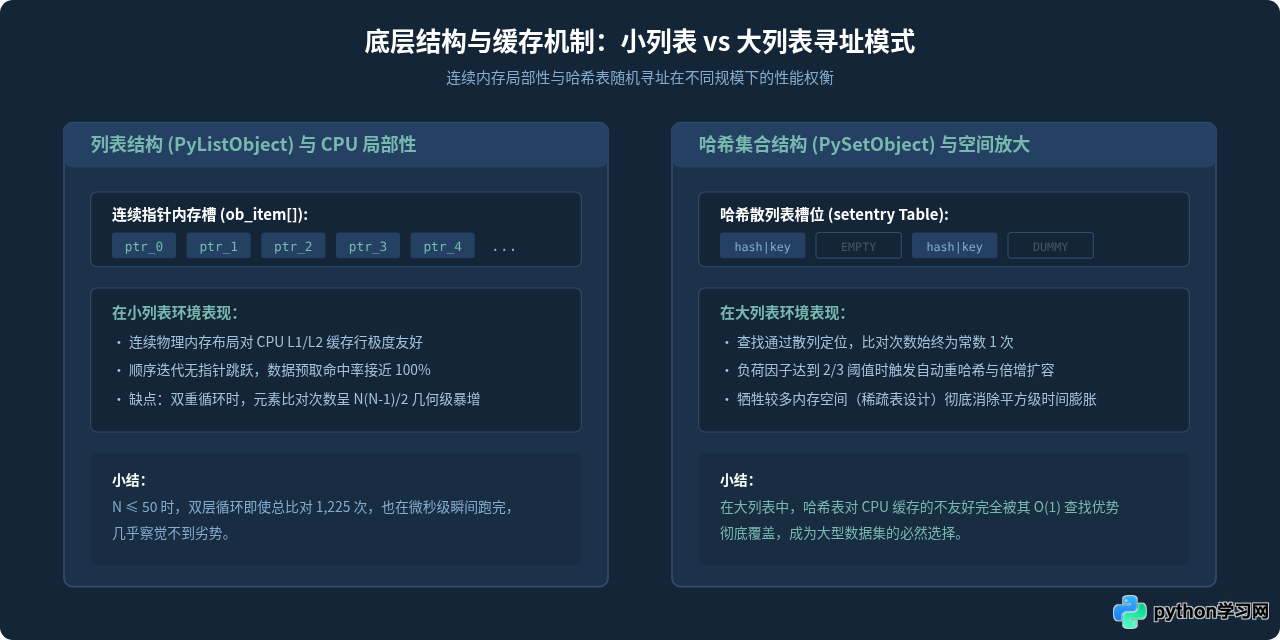
在 $N = 10$ 时,即便使用理论上较差的嵌套循环或 count(),其耗时与辅助集合版本也仅差不到 1 微秒。这是因为 Python 的 list 底层是连续的指针数组,极短的数组能够被完整预取并缓存在 CPU L1 数据缓存中。遍历连续数组的常数非常小,而新建一个 Python set 对象需要申请至少 8 个槽位的哈希散列表结构,并经历散列计算与内存初始化。
四、大列表极限压测:时间雪崩与空间开销
当列表长度增长到 $N = 10,000$ 乃至 $N = 100,000$ 时,不同方案的耗时产生断崖式分化。以下为标准化测试环境下的实测基准数据(使用包含约 10% 随机重复项的整数列表):
| 算法实现 | N = 1,000 耗时 | N = 10,000 耗时 | N = 100,000 耗时 | 额外峰值内存 (N=100k) |
|---|---|---|---|---|
| 嵌套循环 / count() | 4.8 毫秒 | 480 毫秒 | ~52 秒 (超大增长) | 几乎为 0 MB |
| 基于辅助 set 线性查找 | 0.08 毫秒 | 0.95 毫秒 | 14.2 毫秒 | ~8.5 MB |
| 排序后相邻比对 | 0.22 毫秒 | 3.10 毫秒 | 42.5 毫秒 | ~0.8 MB (原地排序) |
| Counter 计数器 | 0.28 毫秒 | 3.60 毫秒 | 48.0 毫秒 | ~9.2 MB |
| 布尔判断:len != len(set) | 0.04 毫秒 | 0.48 毫秒 | 5.8 毫秒 | ~8.5 MB |
count() 双重循环的耗时从 0.48 秒暴增至 52 秒,耗时放大了 100 余倍,完全符合 $O(n^2)$ 的理论预期。若数据量上升至 100 万,该方案需耗时超 1.5 小时,而集合方案仅需约 180 毫秒。
大列表下的内存隐患:
集合方案虽然耗时极低,但其代价是“空间换时间”。Python 的 set 采用开链/稀疏哈希表,为了保证装载因子低于 2/3 并减少哈希碰撞,哈希桶槽位会成倍进行内存重新分配。在存储 100 万个非重复元素时,单个 set 对象就需要消耗超过 60 MB 内存。如果内存极其受限或处理数千万量级数据,选择 $O(n \log n)$ 的原地排序比较方案(lst.sort())往往是兼顾性能与稳定性的最优解。
五、综合选型决策指南与最佳实践
结合数据规模、内存限制与具体业务目标,读者可以参考以下流程进行算法选型:
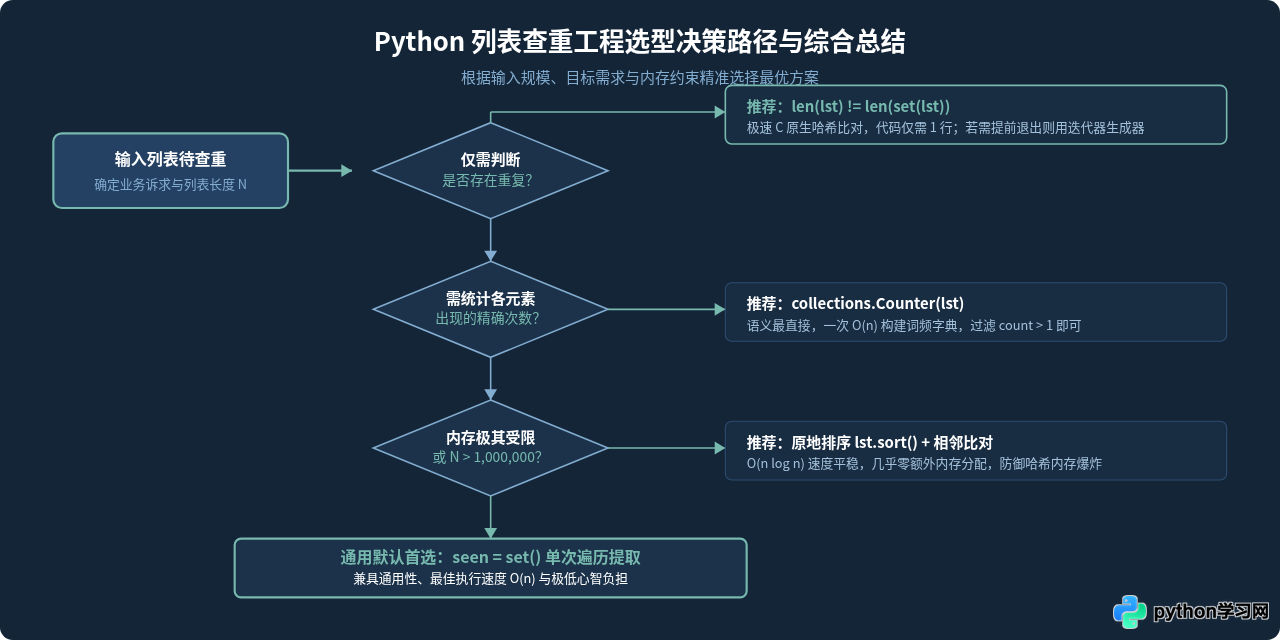
工程建议总结:
- 严禁在大列表中使用
lst.count(x)查重:无论是作为循环体内的条件,还是写在列表推导式中,其隐含的 $O(n^2)$ 嵌套循环都是大中型项目的常见性能隐患。 - 小列表保持简洁,不要过早优化:若已知列表元素不超过数十个,简单的
len(lst) != len(set(lst))是最清晰直接的表达,其纳秒到微秒级的差异对整体链路完全没有可衡量的负面影响。 - 哈希类型限制须知:基于
set或dict的方法要求列表中所有元素必须是可哈希(hashable)的(如数字、字符串、元组)。如果列表中包含字典或子列表等可变对象,则无法直接放入set,此时需要将内部对象转为不可变结构(如将字典键值对转为排序后的tuple(sorted(d.items())))再进行哈希判定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









