

为什么Python字典的键推荐使用元组
深入解析为什么在Python中推荐使用元组作为字典的复合键:从哈希表底层寻址、不可变性保障、字符串拼接陷阱辨析到多维坐标与记忆化缓存的实战选型指南。
一、核心要求:字典键为什么必须“可哈希”?
要理解为什么推荐使用元组,首先需要明确 Python 字典(dict)对键的严格限制。Python 字典并不是通过有序数组遍历来查找元素的,而是基于开地址探测法(Open Addressing)的散列表(Hash Table)实现的。其平均查找与插入复杂度能够达到近乎常数级的 O(1),完全依赖于键对象的哈希稳定性。
一个对象要作为字典的键,必须在 Python 中被定义为可哈希(Hashable)。在底层协议中,这意味着它必须同时满足以下三个硬性条件:
- 生命周期内哈希值恒定:对象必须实现
__hash__()方法,且在对象的生命周期内,其返回的整数哈希值绝不可发生改变。 - 支持相等性比对:对象必须实现
__eq__()方法,用于在发生哈希碰撞时比对内容是否完全一致。 - 一致性传递原则:若两个对象相等(即
a == b为真),则它们的哈希值必须完全相同(即hash(a) == hash(b))。
正因为如此,Python 中所有的可变容器(如列表 list、集合 set、字典 dict)都被显式去除了哈希能力。如果允许列表作为键,当列表执行 append() 增加元素后其哈希值改变,字典将再也无法通过初始槽位定位到该条目,导致数据凭空“丢失”并引发哈希表逻辑崩溃。尝试使用列表作为键会立即抛出异常:
# 尝试将可变列表作为字典键
lookup = {}
coordinates = [10, 20]
lookup[coordinates] = "Target Base"
而元组(tuple)是 Python 最核心的内置不可变序列类型。一旦创建,其内部的指针槽位与长度即告固化。当需要把多个维度组合成一个键时,元组便成为了首要候选者。
二、复合键方案对比:元组相比字符串拼接的压倒性优势
在实际业务开发中,开发者经常需要将多个属性组合成一个唯一标识。例如在电商或权限系统中,我们经常需要基于用户 ID 与角色标签确定权限,或者基于经纬度记录地理数据。很多初学者在初次面对这种“复合键(Composite Key)”诉求时,第一反应往往是使用字符串拼接:
# 初学者常见的字符串拼接写法
cache = {}
key = f"{user_id}_{group_id}"
cache[key] = permission_data
这种做法看似简单直观,但隐藏着三大严重的系统性缺陷:
1. 分隔符歧义冲突(Delimiter Collision)导致静默数据覆盖
当业务数据中天然包含所选的分隔符(例如下划线、冒号或逗号)时,不同的多维组合会意外映射为完全相同的字符串键,从而造成极其隐蔽的数据覆写故障。
例如:用户 A 的 ID 为 "admin",群组为 "1_2";用户 B 的 ID 为 "admin_1",群组为 "2"。
使用 f"{user}_{group}" 拼接后,两者生成的字符串均为 "admin_1_2"!后者会毫无预警地直接冲刷掉前者的字典值。
2. 类型信息完全退化(Type Erasure)
通过字符串拼接后,数字、布尔值或特殊对象都会被强制转为纯文本字符串。例如整数 100 与字符串 "100" 在拼接后没有任何区别;而浮点数在转为字符串时可能遭遇精度微小抖动,引发预期之外的未命中现象。
3. 频繁字符串序列化与内存分配开销
每一次构造字符串键,解释器都要开辟全新的堆内存空间进行文本格式化拼接,随后由垃圾回收机制进行清理。更繁琐的是,当程序后续需要从键中重新提取原本的维度时,还必须调用 split() 进行二次解析,不仅性能损耗显著,而且一旦数据本身含有分隔符还会解析崩溃。
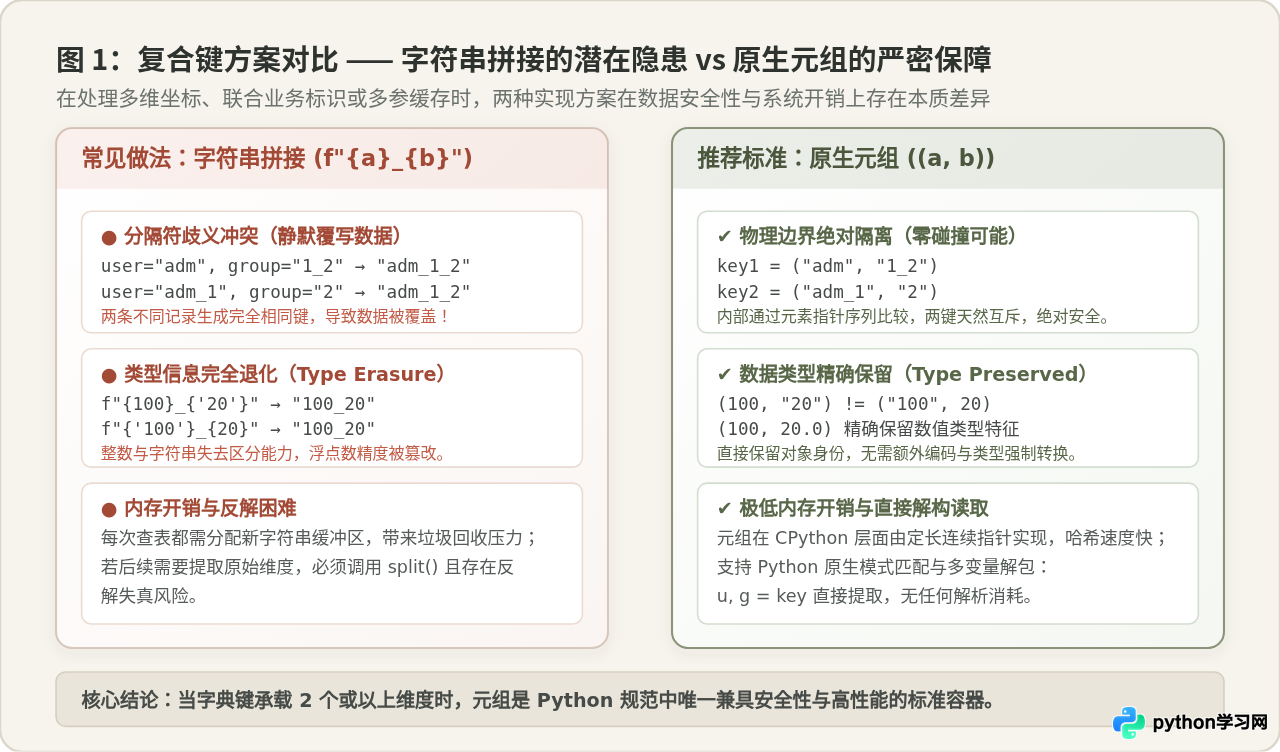
而使用原生元组 (user_id, group_id) 则可以彻底终结这些顾虑:
- 物理边界严格隔离:元组内部维护的是离散的对象指针序列。
("admin", "1_2")与("admin_1", "2")在内存中是完全互斥的两组指针序列,绝对不可能发生混淆。 - 数据类型完美保真:
(100, "20")与("100", 20)在比较时不仅比对值,也比对类型标识,不会产生任何语义歧义。 - 原生解构与零额外开销:元组创建在 C 级别极其轻量,支持直接多变量解包
uid, gid = key,代码整洁度与执行效率均处于最优状态。
三、底层运作机理:元组在字典中是如何寻址的?
要充分信任元组作为字典键的推荐做法,我们需要看一看 Python 解释器在执行 dict[(x, y)] = val 时内部到底发生了什么。
CPython 内部对元组的哈希计算采用了严密的级联扰动算法(Tuple Hash Algorithm)。当调用 hash((a, b)) 时,底层 C 函数 tuplehash() 会遍历元组内每一个元素,依次调用各个元素的哈希函数,并结合固定的加权质数乘数与位移扰动常数对分量哈希进行混合。
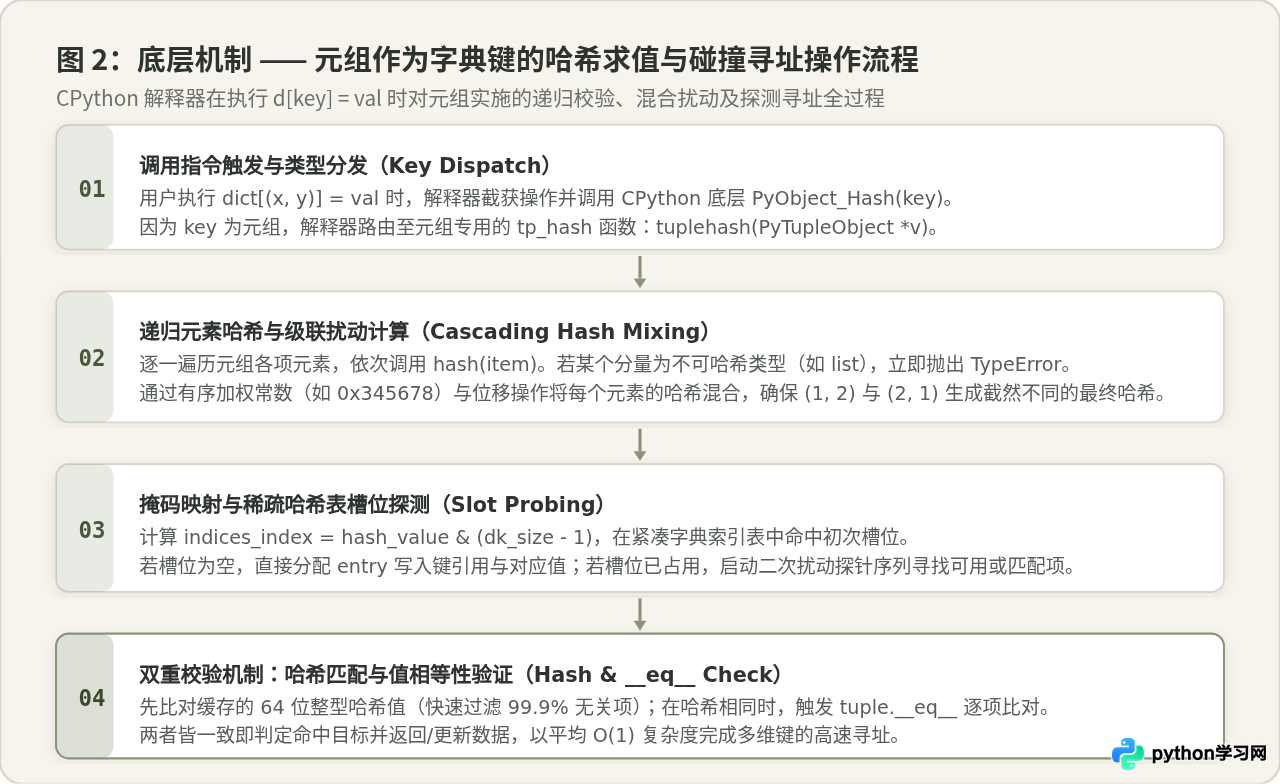
整个存取生命周期包含清晰的四个执行步骤:
- 指令截获与类型分发:解释器在接收到字典索引指令时,将元组指针传入
PyObject_Hash。由于对象类型为元组,自动路由至tuplehash处理。 - 元素级递归校验与哈希扰动:元组按序循环遍历。对每一项计算其
hash(),若发现任何一项不可哈希,立即打断并报出TypeError;通过有序累乘(含位移扰动),确保元素顺序敏感性,即hash((1, 2)) != hash((2, 1))。 - 索引槽位掩码映射:将计算出的 64 位整数哈希值与字典当前哈希表掩码进行按位与运算(
hash & mask),直接定位到紧凑数组索引。 - 双重校验(Fast Path + Slow Path):
- 快速路径(Fast Path):先比对已缓存的 64 位整型哈希值。若哈希值不同,则百分之百不是同一个键,直接跳过。
- 慢速路径(Slow Path):若哈希值相同(大概率命中或极小概率碰撞),则调用
tuple.__eq__()逐项比较元组元素。只有哈希相同且内容相等时,才确认命中并返回数值。
四、典型实践场景:元组作为键的四大高效范式
元组作为字典键在 Python 标准库以及日常工业开发中无处不在,以下是四个最典型的应用场景及完整示例代码。
场景 1:二维网格、棋盘与稀疏矩阵(Sparse Matrix)
在处理二维地图、棋盘状态或超大网格时,如果使用嵌套列表(如 matrix[row][col]),对于大多数位置为默认值(如空白、零)的稀疏场景,会浪费海量内存。使用坐标元组作为字典键,只存储有实际有效数据的坐标点,能够大幅节约内存:
# 使用坐标元组表达稀疏网格
sparse_grid = {}

# 仅记录非空阻挡物或有效网格
sparse_grid[(0, 0)] = "Start_Point"
sparse_grid[(150, 320)] = "Obstacle_Wall"
sparse_grid[(999, 999)] = "Destination"

def get_tile(row: int, col: int) -> str:
    # 查找指定坐标,若未显式记录则返回默认空地
    return sparse_grid.get((row, col), "Empty_Ground")

print("位置 (150, 320):", get_tile(150, 320))
print("位置 (5, 5):", get_tile(5, 5))场景 2:记忆化搜索与多参数函数缓存(Memoization)
在编写动态规划算法、组合数学或复杂递归运算时,我们经常需要缓存多参数调用的中间结果以避免重复计算。Python 标准库的 functools.lru_cache 内部正是通过构建以参数元组为键的字典来实现全局极速查表的:
# 手动实现多维状态记忆化搜索(网格不同路径问题)
memo = {}

def unique_paths(m: int, n: int) -> int:
    # 边界条件
    if m == 1 or n == 1:
        return 1

    # 状态键:使用当前坐标 (m, n) 元组
    state = (m, n)
    if state in memo:
        return memo[state]

    # 状态转移方程并将结果缓存至字典
    result = unique_paths(m - 1, n) + unique_paths(m, n - 1)
    memo[state] = result
    return result

print("从 (3, 7) 出发到达终点的唯一路径数:", unique_paths(3, 7))
print("缓存字典中的复合状态键示例:", list(memo.keys())[:3])场景 3:多字段联合索引与分组聚合统计
在数据清洗与统计汇总任务中,经常需要按照多个离散维度(如部门、季度、销售状态)进行多维计数或累加:
from collections import defaultdict

# 统计不同部门在不同季度的绩效总分
sales_summary = defaultdict(float)

records = [
    ("Dev", "2026-Q1", 94.5),
    ("Sales", "2026-Q1", 88.0),
    ("Dev", "2026-Q2", 96.0),
    ("Dev", "2026-Q1", 85.5),
]

for dept, quarter, score in records:
    # 复合维度作为键,天然隔离且可解构
    sales_summary[(dept, quarter)] += score

for (dept, quarter), total_score in sales_summary.items():
print(f"部门: {dept:<6} 季度: {quarter} -> 累加得分: {total_score}")场景 4:图结构中的边权重与有向关系映射
在图论算法(如 Dijkstra 或 Bellman-Ford)中,两点之间的连通边通常由起点和终点共同唯一确定:
# 图的邻接边权映射
edge_weights = {}

# 边 (u, v) 的权重为 w
edge_weights[("A", "B")] = 4.5
edge_weights[("B", "C")] = 2.1
edge_weights[("A", "C")] = 8.0

def get_edge_cost(source: str, target: str) -> float:
    return edge_weights.get((source, target), float("inf"))

print("边 A -> B 的权重为:", get_edge_cost("A", "B"))
print("反向边 B -> A 的权重为:", get_edge_cost("B", "A")) # 有向图区分顺序五、关键细节辨析:元组就一定能作为字典键吗?
在 Python 面试和实际工程排错中,有一个极为高频的混淆概念:“既然元组是不可变类型,那么所有的元组都可以作为字典的键吗?”
答案是否定的。
元组的不可变性是浅层不可变(Shallow Immutability)。元组本身所承载的槽位引用列表(即指向各个对象的内部指针数组)确实是固定的,无法增加、删除或重新指向;但是,指针所指向的具体对象本身可能是可变的。
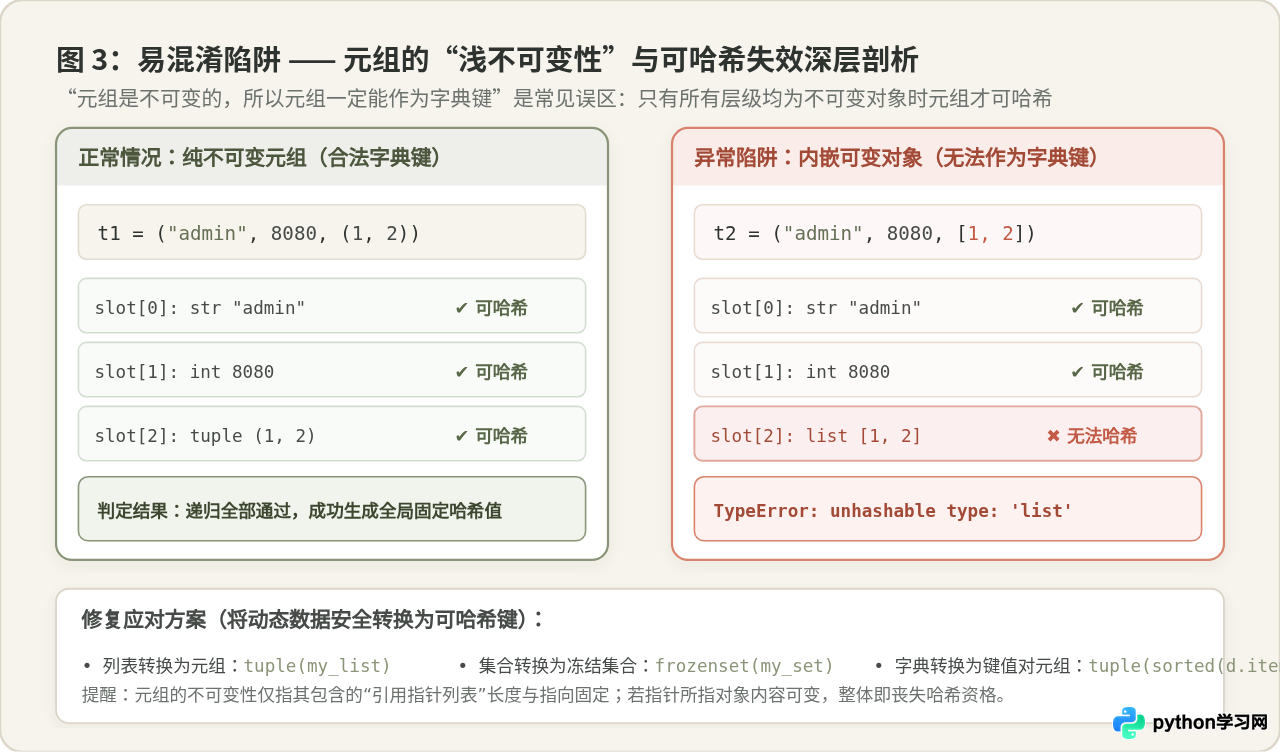
我们可以通过以下代码进行验证:
# 合法元组:所有分量元素皆为不可变对象
valid_tuple = ("user_1001", 2026, (1, 2))
d1 = {valid_tuple: "Success"}
print("合法元组成功加入字典,哈希值为:", hash(valid_tuple))

# 异常元组:第 3 个元素包含了可变列表 [1, 2]
invalid_tuple = ("user_1001", 2026, [1, 2])
try:
    d2 = {invalid_tuple: "Fail"}
except TypeError as e:
print("抛出异常:", repr(e))成立条件:一个元组当且仅当其包含的所有元素本身全部是可哈希对象时,该元组才具备哈希能力并允许作为字典的键。如果元组内嵌套了任何列表、集合或普通字典,整体元组都将丧失可哈希资格。
工程规范修复方案:
- 若元素是列表,在构建键之前转换为元组:
tuple(my_list); - 若元素是集合,转换为不可变冻结集合:
frozenset(my_set); - 若元素是普通字典,转换为键值对排序元组:
tuple(sorted(my_dict.items()))。
六、工程进阶:普通元组、NamedTuple 与 Frozen Dataclass 的选型对比
虽然原生元组性能极高且开箱即用,但在复杂的多人协作大型工程项目中,如果元组的维度超过 3 个(例如包含 5 个属性的复合业务键),仅凭位置索引 key[0]、key[3] 会导致代码可读性急剧恶化,维护者很难立刻理解每个位置的具体含义。
此时,Python 提供了兼顾“元组不可变哈希特性”与“语义字段自解释”的高级演进方案:
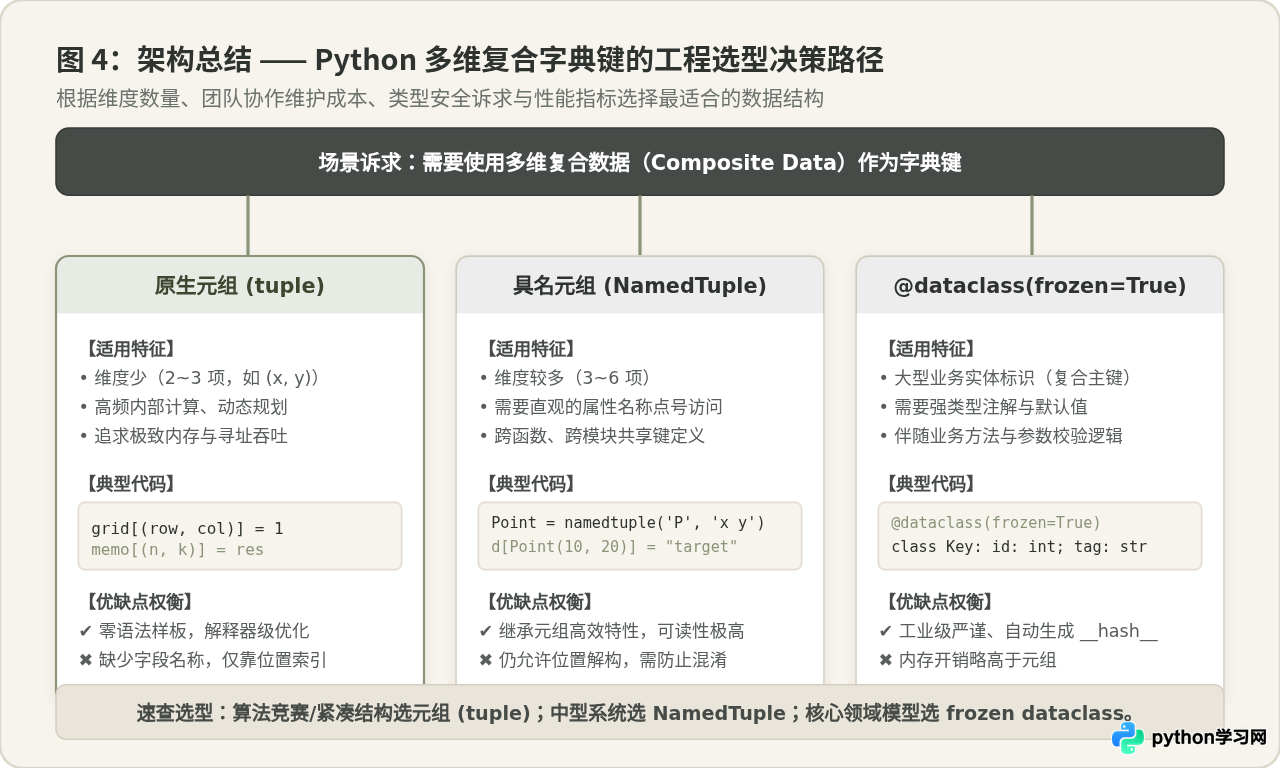
| 方案类型 | 不可变与可哈希 | 字段访问方式 | 类型注解支持 | 最佳适用场景 |
|---|---|---|---|---|
| 原生元组 (tuple) | ✔ 是(只要分量元素可哈希) | 位置索引 t[0] 或解包 |
弱(仅 Tuple[int, str]) |
坐标计算、动态规划、算法紧凑缓存 |
| 具名元组 (NamedTuple) | ✔ 是(底层就是元组子类) | 属性点号访问 t.user_id |
强(支持 typing.NamedTuple) |
跨函数业务标识、轻量数据传输对象 |
| @dataclass(frozen=True) | ✔ 是(必须显式设为 frozen) | 属性点号访问 obj.key |
极强(现代 Python 工业级标准) | 核心业务领域模型、含默认值与业务方法校验 |
工程进阶代码示例:三种方案在字典中的一致表现
from typing import NamedTuple
from dataclasses import dataclass

# 1. 原生元组:最简写法
cache_plain = {}
cache_plain[(101, "admin")] = "Perm_Full"

# 2. typing.NamedTuple:具名字段,继承元组零额外开销
class SessionKey(NamedTuple):
    user_id: int
    role: str

cache_named = {}
s_key = SessionKey(user_id=101, role="admin")
cache_named[s_key] = "Perm_Full"

# 3. @dataclass(frozen=True):现代化领域对象
@dataclass(frozen=True)
class TenantKey:
    tenant_id: int
    service_code: str
    is_sandbox: bool = False

cache_dataclass = {}
t_key = TenantKey(tenant_id=5001, service_code="payment")
cache_dataclass[t_key] = "Active_Config"

print("NamedTuple 键检索结果:", cache_named[s_key])
print("Frozen Dataclass 键检索结果:", cache_dataclass[t_key])七、总结与实践速查清单
在 Python 字典的设计哲学中,“元组作为键”不仅是一项语法特性的运用,更是处理多维复合数据时保障安全性与性能的标准实践。
- 为什么是元组? 字典键要求必须可哈希(不可变)。元组是唯一内置的固定序列容器,天然适合将离散多变量打包为单一实体。
- 为什么不用字符串拼接? 字符串拼接存在严重的分隔符冲突覆写隐患、丢弃原始数据类型、伴随昂贵的序列化与反解成本。
- 底层如何保障? CPython 通过 C 级
tuplehash进行分量哈希级联扰动,兼顾顺序敏感性与均匀分布,配合双重校验实现近O(1)检索。 - 必须避开的陷阱: 元组只具备“浅层不可变性”。若元组内含有列表、集合或字典等可变元素,将导致全局哈希失败抛出
TypeError。 - 何时升级选型? 2~3 个维度的局部计算首选原生元组;需要良好团队维护可读性时选用
NamedTuple;严谨业务实体使用@dataclass(frozen=True)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









