

怎么利用Python集合快速去除列表中的重复元素
详细讲解如何在Python中使用集合(set)快速去除列表中的重复元素,涵盖核心一行代码、底层哈希原理、顺序丢失问题、元素可哈希限制及保序替代方案。
在Python中去除列表重复元素最直接、速度最快的方法,是将列表直接转换为集合(set),再转回列表结构:unique_list = list(set(original_list))。这行代码利用了集合元素天然不可重复的特性,能够在毫秒级内完成成千上万个元素的去重任务。本文将详细讲解这一方法的使用步骤、底层去重机制、注意事项以及保序替代方案。
一、核心操作:一行代码完成去重
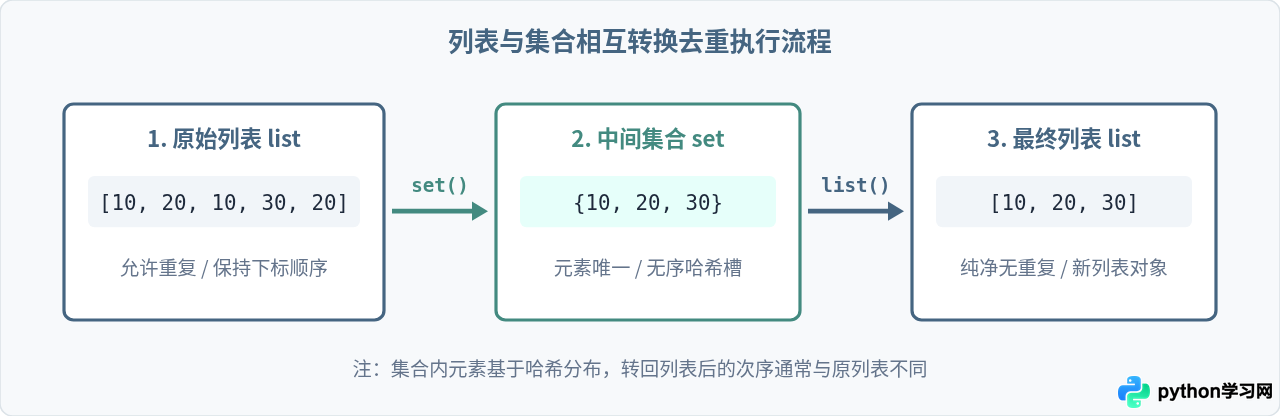
在Python交互环境或脚本中,我们可以直接调用内置函数 set() 构造集合,再使用 list() 函数还原。整个过程无需显式编写 for 循环或条件判断语句。
# 原始列表(包含多组重复数字与字符串)
raw_data = [10, 20, 10, 30, 20, 40, 50, 10]

# 利用集合快速去重
result = list(set(raw_data))

print("去重后的结果:", result)
# 示例输出:去重后的结果: [40, 10, 20, 50, 30]执行逻辑非常直观:set(raw_data) 遍历列表并将每个元素放入集合容器中,遇到已经存在的元素直接丢弃;随后 list() 将去重后的集合重新包装为普通的列表对象供后续业务使用。
二、为什么集合去重极快?底层哈希机制剖析
许多初学者会习惯通过循环遍历判断列表:for item in original_list: if item not in new_list: new_list.append(item)。这种传统双重循环的做法在大数据量下会极度缓慢。
在普通列表中,查找操作 item in new_list 需要从头到尾逐个比对元素,时间复杂度为 \(O(N)\)。当循环 \(N\) 次时,整个去重过程的时间复杂度高达 \(O(N^2)\)。如果列表有 50,000 个元素,比对次数可能达到数十亿次。
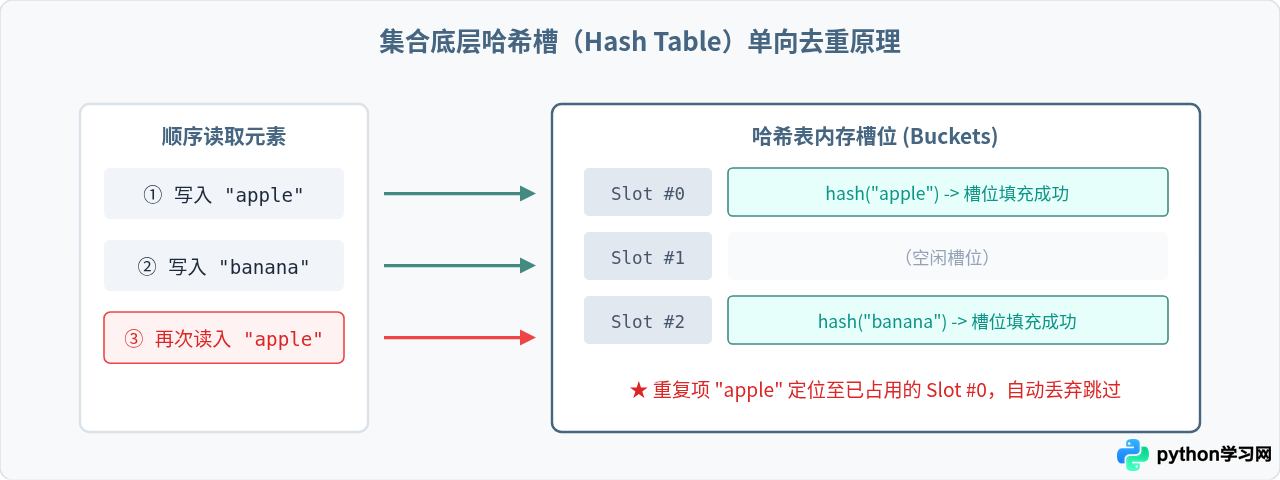
而 Python 的集合(set)底层完全基于哈希表(Hash Table)构建:
- 当向集合存入元素时,Python 会调用内置的
hash()函数计算元素的哈希值。 - 通过哈希值直接定位到内存底层的哈希槽(Bucket)。
- 判断该槽位是否已经存在相同哈希与数值的项。如果存在则视为重复并忽略;若为空则直接填入。
因为哈希查找与插入的平均时间复杂度为 \(O(1)\),整个去重过程只需遍历一次列表,总时间复杂度仅为 \(O(N)\)。处理数万级数据时,耗时从几分钟缩短至几毫秒。
三、使用集合去重的两大注意事项与限制
虽然 list(set(x)) 极其高效,但在实际工程中必须注意以下两个重要限制,否则可能导致程序逻辑异常或运行时报错:
1. 原始列表的排列顺序会被打乱
Python 列表是有序序列,而集合(set)在概念上是无序散列的。当列表被转为集合时,元素会根据其哈希值分布在底层的不同存储桶中,原本的输入顺序不再保留。
# 示例:原本严格按先后顺序排列的数据
ordered_list = ["B", "A", "C", "B", "A"]

# 去重后
shuffled_result = list(set(ordered_list))
print(shuffled_result)
# 输出结果可能是 ['A', 'C', 'B'] 或 ['B', 'A', 'C'],顺序不可预测
2. 列表元素必须是“可哈希”(Hashable)对象
集合的底层依赖哈希计算,因此只有不可变类型(例如:整数、浮点数、字符串、元组)才能放入集合。如果列表中包含可变类型(例如:子列表、字典、其他集合),程序会直接抛出 TypeError。
# 列表中包含嵌套列表(可变对象)
nested_list = [[1, 2], [3, 4], [1, 2]]

# 尝试利用 set 去重会直接报错:
# list(set(nested_list))
# 报错信息:TypeError: unhashable type: 'list'list(set())。
四、进阶场景:既要高效去重,又要保留原有顺序
当业务明确要求去除重复项且保持第一次出现的顺序时,推荐采用以下两种方案:
方案一(推荐):利用字典 dict.fromkeys()(Python 3.7+ 原生支持)
自 Python 3.7 起,内置字典(dict)保证按照键的插入顺序进行存储。利用字典的键同样不可重复这一特性,使用 dict.fromkeys() 是目前保序去重最优雅、速度最快的方案。
items = ["banana", "apple", "orange", "apple", "banana"]

# 保留插入顺序的极速去重
ordered_unique = list(dict.fromkeys(items))

print("保序去重结果:", ordered_unique)
# 稳定输出:['banana', 'apple', 'orange']
该方法与 set() 一样具备 \(O(N)\) 的高效性能,且代码极其简短,是现代 Python 开发中的最佳实践。
方案二:列表推导式配合集合辅助记录(兼顾兼容与自定义过滤)
如果需要在去重过程中执行额外判定(例如忽略大小写、仅记录特定属性),可以借助一个独立的辅助集合 seen = set() 来实现:
items = ["apple", "Banana", "APPLE", "orange", "banana"]

seen = set()
# 忽略大小写并保持原有第一次出现的顺序
result = []
for x in items:
    lower_x = x.lower()
    if lower_x not in seen:
        seen.add(lower_x)
        result.append(x)

print(result)
# 稳定输出:['apple', 'Banana', 'orange']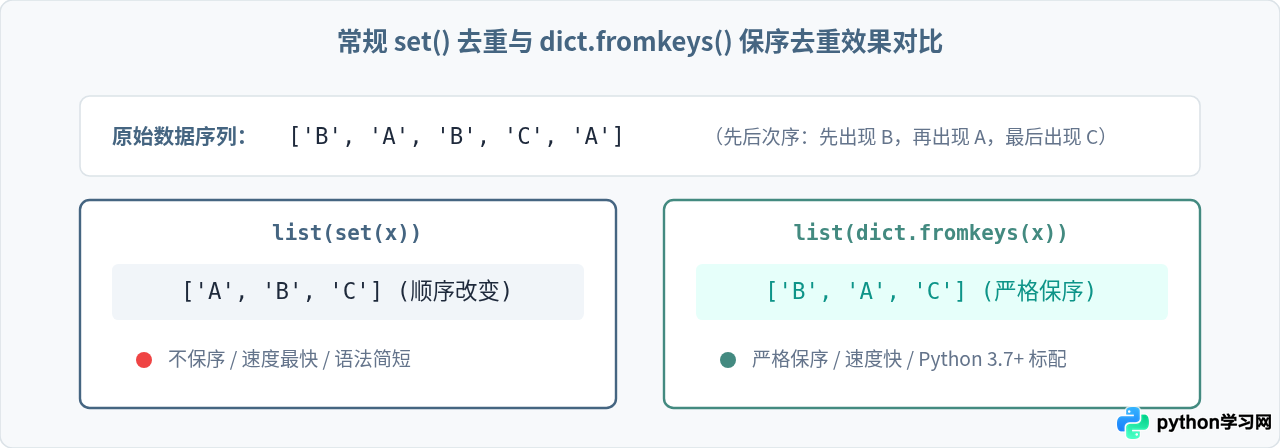
五、遇到不可哈希元素(如字典、列表)怎么去重?
在实际开发中,经常会遇到从数据库或网络接口中提取出的字典列表(如用户数据列表)。因为字典本身不可哈希,直接传给 set() 会失败。
场景:根据特定字段(如主键 ID)去重
对于对象或字典列表,通常只需要依据某一关键字段去重。此时可以将字段 ID 放入集合进行标记:
users = [
    {"id": 101, "name": "张三"},
    {"id": 102, "name": "李四"},
    {"id": 101, "name": "张三(重复)"},
]

seen_ids = set()
unique_users = []

for u in users:
    if u["id"] not in seen_ids:
        seen_ids.add(u["id"])
        unique_users.append(u)

print(unique_users)
# 输出:[{'id': 101, 'name': '张三'}, {'id': 102, 'name': '李四'}]
六、去重方案技术选型总结
为了帮助读者在不同开发场景下快速作出最佳选择,下表总结了 Python 中最常见的去重实现方式及优劣对比:
| 去重方式 | 时间复杂度 | 是否保留原顺序 | 支持不可哈希元素 | 适用场景与推荐度 |
|---|---|---|---|---|
list(set(x)) |
\(O(N)\) | 否 | 否 | 仅需简单去重、无序数据处理(强烈推荐) |
list(dict.fromkeys(x)) |
\(O(N)\) | 是 | 否 | 既要极速去重又要求保留原有顺序(强烈推荐) |
列表推导式 + set() 辅助 |
\(O(N)\) | 是 | 可通过映射支持 | 字典列表去重、特定属性筛选去重(工程常用) |
双重循环 / not in 逐项判断 |
\(O(N^2)\) | 是 | 是 | 仅适合少于100项的小规模列表,规模稍大即严重卡顿 |
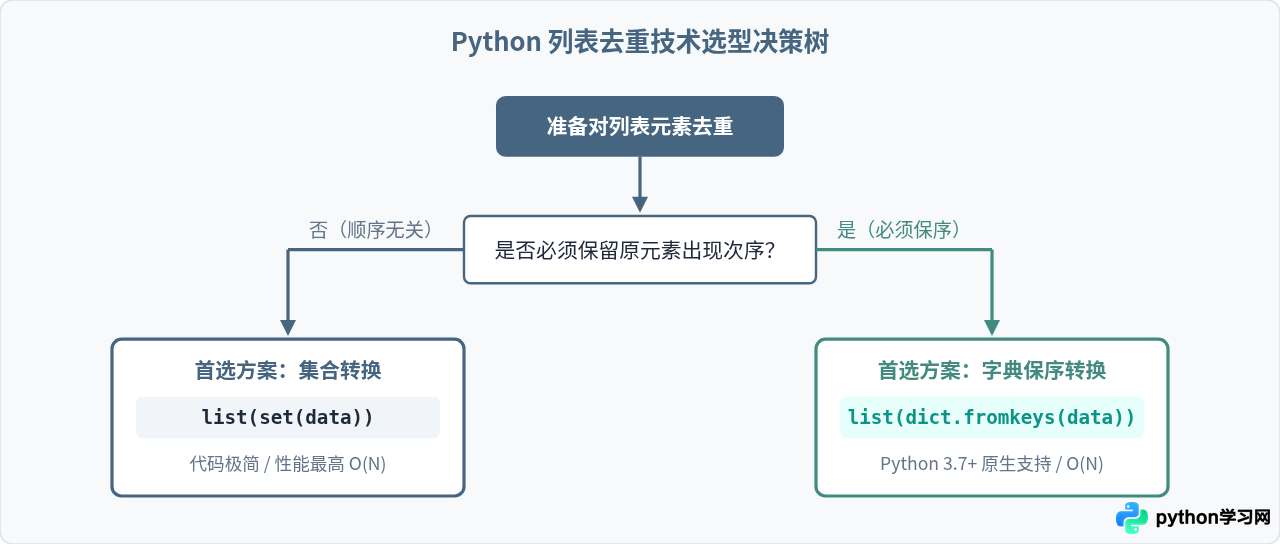
list(set(data));如果需要原封不动保持出现顺序,首选 list(dict.fromkeys(data))。两者均基于哈希机制,执行时间均处于最高效的 \(O(N)\) 水平。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









