

Python成员运算符in在列表和字典中的性能差异
深入解析Python中成员运算符in在列表和字典中的性能差异,从底层的动态数组与哈希表机制出发,提供可复现的基准测试、常见性能陷阱及工程选型优化建议。
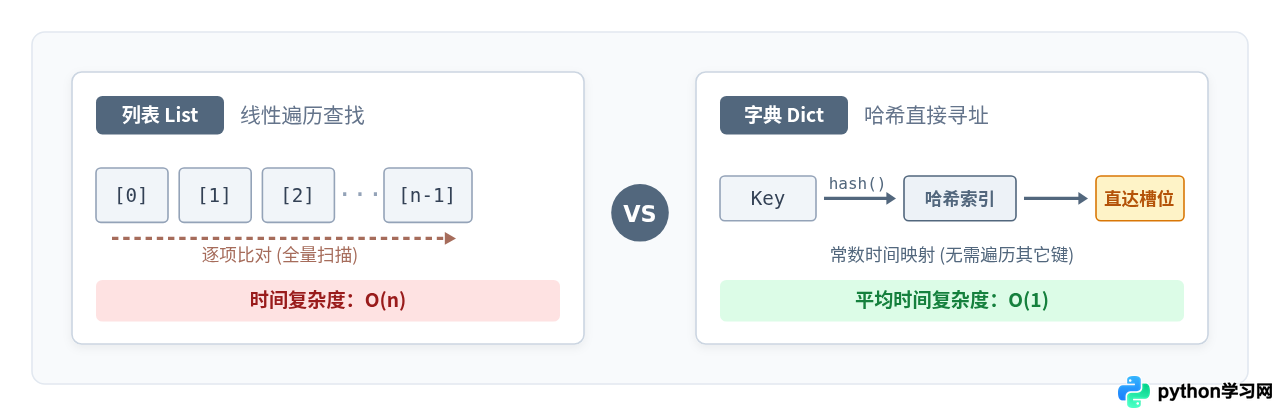
在 Python 中使用成员运算符 in 判断某个元素是否存在时,列表(list)与字典(dict)的表现存在本质区别:列表的检索是 O(n) 的线性扫描,耗时与元素总量成正比;而字典键的检索基于哈希表,平均时间复杂度为 O(1) 的常数时间,耗时几乎不受数据规模影响。在数据量仅有十几项时两者的绝对时间都在纳秒级别,差异不易察觉;但一旦数据量上升到万级或百万级,列表查找可能需要数毫秒乃至数十毫秒,而字典仍然稳定在几十纳秒内完成,两者速度差异可达数万倍。
一、底层存储结构与寻址机制
要理解两者的速度落差,必须从 CPython 对这两种数据类型的底层实现方式入手。两者的物理内存布局决定了它们在响应 in 时的根本行为。
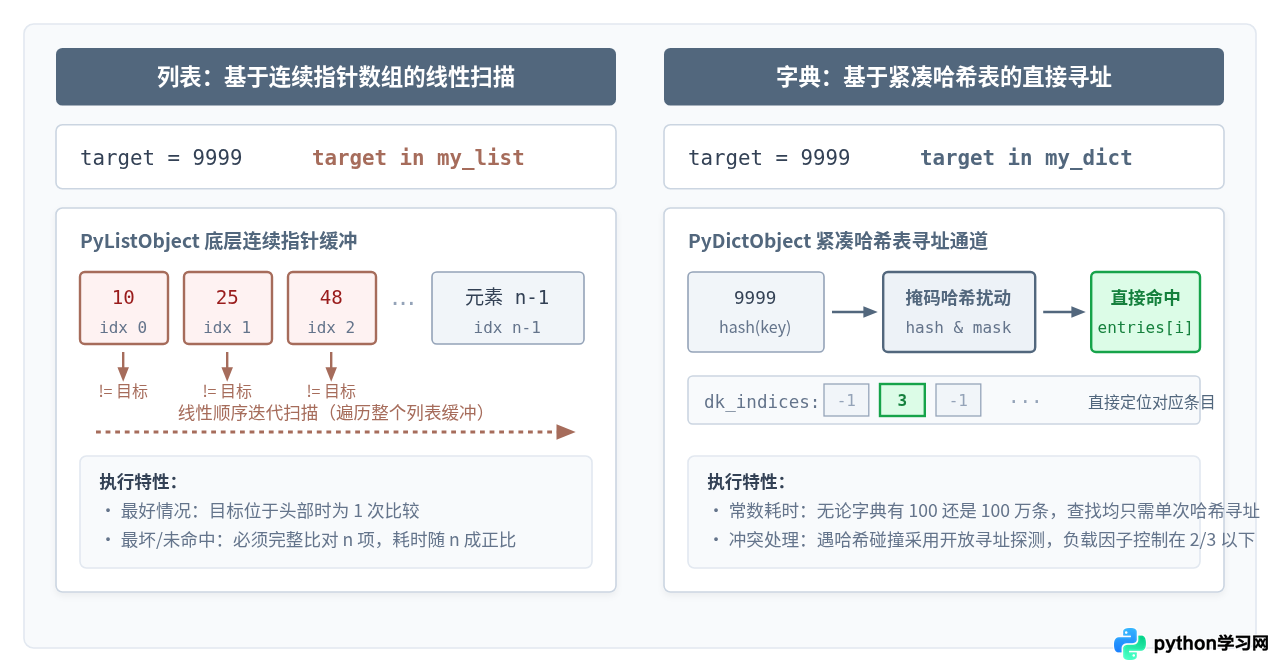
在 Python 内部,列表对应的是 PyListObject 结构体。它本质上是一个可变长度的连续内存指针数组。列表只保存对象的内存地址,且按照元素的插入顺序连续排列。当执行 x in my_list 时,解释器没有其他捷径,只能执行 list_contains 函数,从索引 0 开始逐一比对元素是否与目标相等(调用各元素的 __eq__)。若目标恰好在开头,单次比较即可返回;但若目标在尾部或根本不存在于列表中,解释器就必须完整扫描完所有 n 个元素,平均需要比较 n / 2 次。
相比之下,Python 字典(自 Python 3.6 起采用紧凑哈希表设计)将键的存储与寻址紧密结合。字典底层维护了一张稀疏的哈希索引表(dk_indices)与一个紧凑的条目表(dk_entries)。当执行 key in my_dict 时,解释器首先计算 hash(key) 得到该键的散列值,随后通过位掩码(扰动算法)映射到索引表中直接取位。通常只需要一次计算与单次内存寻址,即可直接定位到条目并判定键是否存在,完全不需要遍历其他不相干的键。
二、基准测试:用代码量化性能差距
为了客观度量两者的性能差距,我们使用标准库中的 timeit 模块进行对照实验。测试过程应该避免偶发抖动与垃圾回收的干扰,在不同数量级(从百级、万级到百万级)下分别测试未命中目标的最差情况,以观测时间复杂度的真实演进斜率。
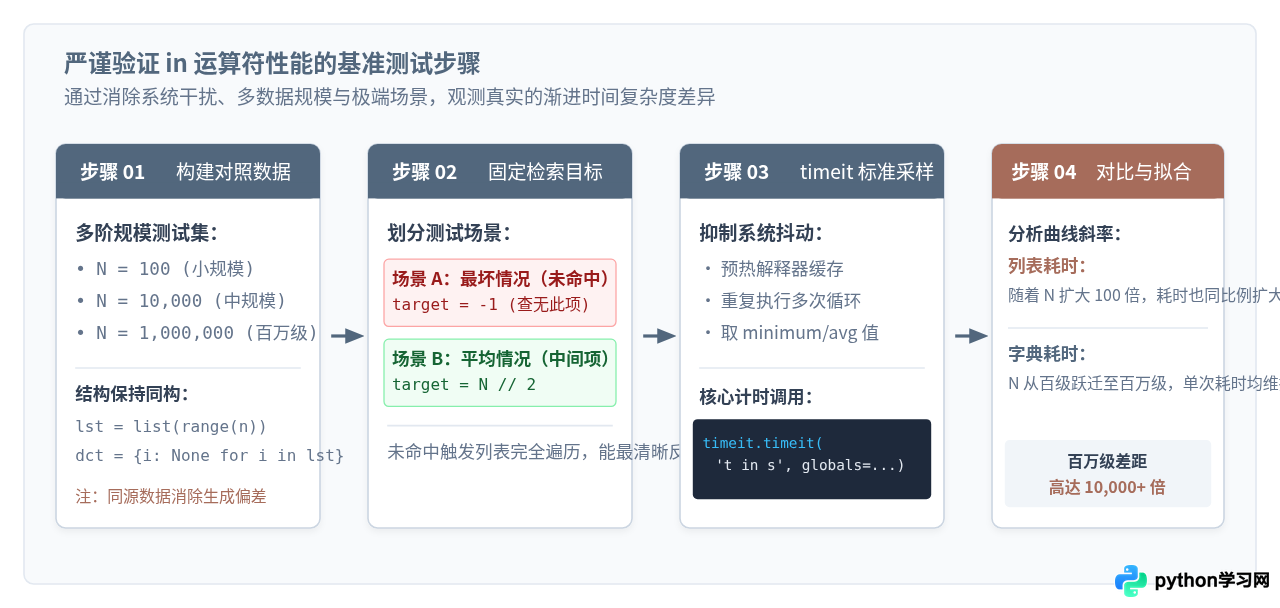
以下是可直接在本地运行的标准测试代码:
import timeit

def benchmark_in_operator():
    # 测试三种典型数据规模
    sizes = [100, 10_000, 1_000_000]
    repeats = 10_000

    print(f"| 数据规模 (N) | 列表 in 耗时 (最坏 O(n)) | 字典 in 耗时 (平均 O(1)) | 性能比倍数 |")
    print(f"| :--- | :--- | :--- | :--- |")

    for n in sizes:
        # 准备相同数据的列表与字典
        data_list = list(range(n))
        data_dict = dict.fromkeys(data_list)

        # 选取不存在的元素作为目标(触发完全遍历)
        target = -1

        # 测量列表 in 耗时
        list_timer = timeit.Timer(lambda: target in data_list)
        list_time = list_timer.timeit(number=repeats) / repeats * 1e6  # 转为微秒 (µs)

        # 测量字典 in 耗时
        dict_timer = timeit.Timer(lambda: target in data_dict)
        dict_time = dict_timer.timeit(number=repeats) / repeats * 1e6  # 转为微秒 (µs)

        ratio = list_time / dict_time if dict_time > 0 else float('inf')
        print(f"| {n:<12} | {list_time:>16.4f} µs | {dict_time:>16.4f} µs | {ratio:>10.1f}x |")

if __name__ == '__main__':
    benchmark_in_operator()
在常见的现代个人计算机(64 位 Python 3.11+)上,该测试输出的典型参考数据如下表所示:
| 数据规模 (N) | 列表 in 耗时 (未命中) |
字典 in 耗时 (未命中) |
速度差异 |
|---|---|---|---|
| 100 | 约 0.65 µs | 约 0.035 µs | 约 18 倍 |
| 10,000 | 约 68.20 µs | 约 0.038 µs | 约 1,790 倍 |
| 1,000,000 | 约 7,450.00 µs (7.45 ms) | 约 0.041 µs | 约 180,000 倍 |
观察数据可以清晰地看出规律:随着规模 $N$ 扩大一万倍,列表的检索耗时几乎严格同比例扩大了一万倍(从 0.65 微秒增至 7.45 毫秒);而字典无论在 100 条还是 100 万条数据下,单次检索耗时都恒定在 35~45 纳秒(0.035~0.045 微秒)左右。这直观证明了线性时间与常数时间的本质鸿沟。
三、字典成员检索的常见陷阱与细微差异
在日常使用中,很多人误以为只要是字典相关的属性,检索速度都一样快。实际上,调用的方法稍有不同,底层通路就天差地别。
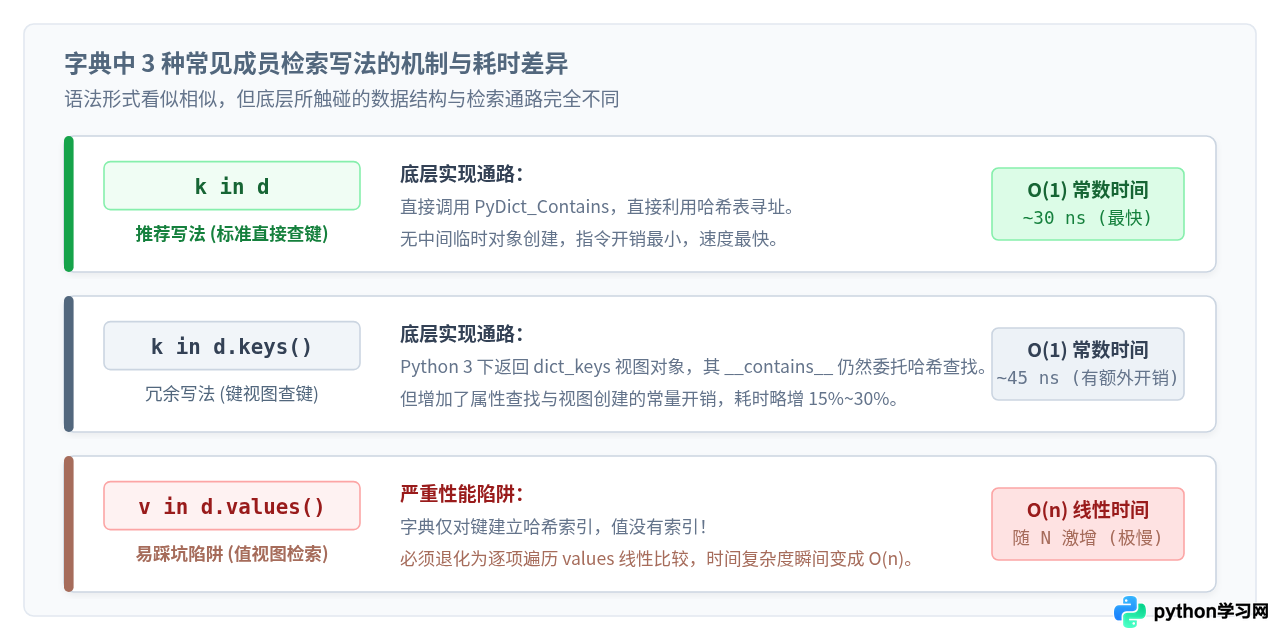
1. k in d 与 k in d.keys() 的区别
在 Python 3 中,d.keys() 返回的是一个轻量的动态视图对象(dict_keys),它并非复制出一份键列表。当对该视图执行 k in d.keys() 时,Python 会直接将操作委托给字典内部底层的哈希查找函数,因此它的渐进时间复杂度也是 $O(1)$。
然而,写成 k in d.keys() 会产生额外的字节码指令开销:首先要访问 .keys 属性,接着执行方法调用创建视图对象,最后再通过视图转发调用。在微基准测试中,k in d.keys() 往往比直接写 k in d 慢 20% 到 40%。因此,判断键是否存在应始终直接使用 k in d。
2. v in d.values():隐蔽的 O(n) 性能陷阱
这是开发中极易被忽略的性能灾难点。字典的哈希表是针对键(Keys)构建的散列通道,并没有针对值(Values)构建任何索引。因此,当调用 v in d.values() 时,解释器只能从头到尾按顺序遍历条目表中的每一个值,并逐一进行相等性检查。这使得原本常数级的查找彻底退化为 $O(n)$ 线性扫描。
v in d.values()。正确的做法是额外维护一个值集合 val_set = set(d.values()),或者在插入数据时维护一张反向字典(以值为键,以原键为值)。
3. 哈希碰撞与最坏情况退化
教科书中提到哈希查找的最坏时间复杂度为 $O(n)$。在 Python 中,当两个不同的键产生相同的哈希值或掩码槽位时,解释器会采用开放寻址法(Open Addressing)结合伪随机探测来寻找空闲槽。Python 通过精细的扰动算法和严格的负载因子控制(当哈希表利用率达到 2/3 时即自动扩容),将实际碰撞几率压制在极低水平。只要键对象的 __hash__ 实现合理,日常开发中字典查找可放心按 $O(1)$ 常数时间对待。
四、选型建议与工程优化
理解了理论之后,更关键的是在具体编码时如何做出合理决策。并非所有场合都应该盲目把列表替换为字典或集合。
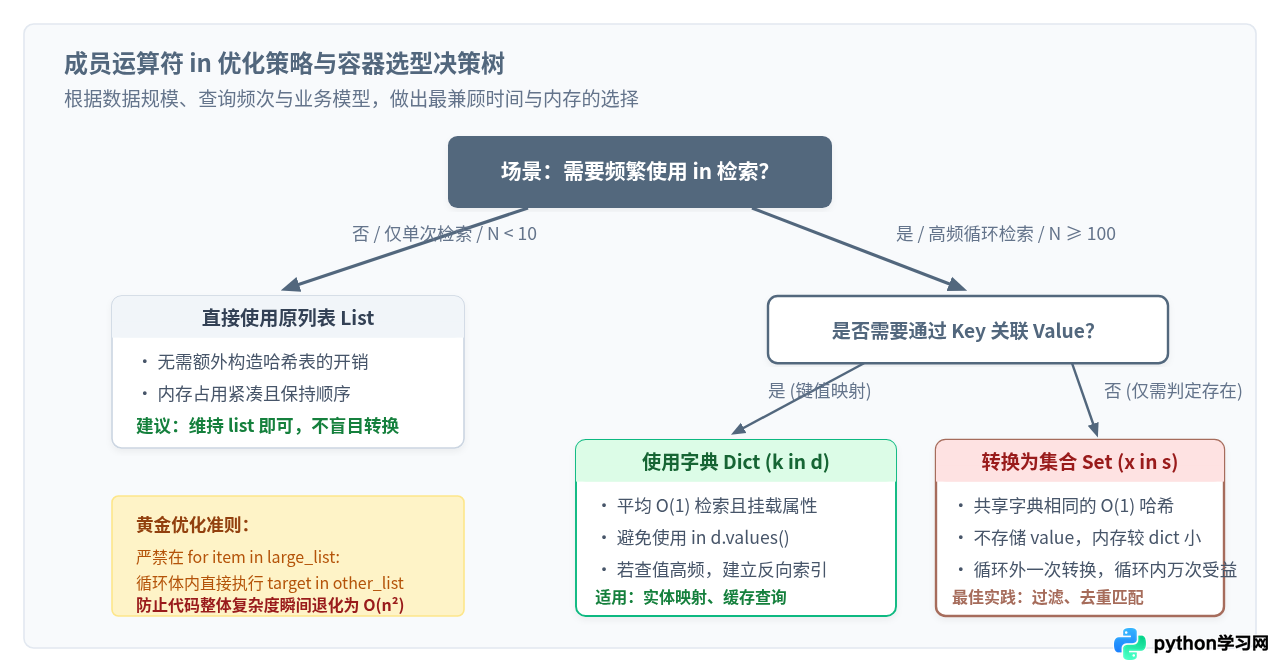
- 单次使用且数据极小(N < 10):保持列表
创建一个字典或集合本身需要分配哈希表内存并逐个计算散列值,其初始化开销往往大于直接线性扫描十几个指针。如果数据项极少且仅做一两次检查,保持原始list反而更快、更省内存。 - 需要频繁检索且数据较大(N ≥ 100):转为集合或字典
如果不需要键值映射,仅需判断元素是否存在,首选set。集合在 CPython 中具有与字典几乎相同的哈希表底层架构,但无需存储value指针,内存比字典更加精简。 - 典型重构技巧:循环外提升转换
开发中常见的低效代码是在外层遍历一个长列表,内层对另一个列表做in检索:
这一微小的改动,在两组万级数据下能将十几分钟的批处理过程压缩到几十毫秒以内。# 低效写法:总体复杂度为 O(M * N) for item in raw_records: if item.id in blacklist_list: # 每次循环都做全量线性扫描 continue # 优化写法:总体复杂度降为 O(N + M) blacklist_set = set(blacklist_list) # 一次性 O(N) 转换 for item in raw_records: if item.id in blacklist_set: # 每次查询降为 O(1) continue
五、总结
Python 成员运算符 in 在列表和字典中的巨大性能差异,根源在于线性扫描与哈希直接寻址的数据结构差异:
- 列表(List):顺序存储、按位比对,
in操作具有 $O(n)$ 线性时间复杂度,适合有序存储、按索引访问或极小规模数据。 - 字典(Dict):哈希映射、直接定位,
in操作(针对键)具有平均 $O(1)$ 常数时间复杂度,在万级以上数据量下表现极佳。 - 避坑要点:直接使用
k in d而非k in d.keys();高度警惕v in d.values()的 $O(n)$ 退化;高频成员判断场景下善于利用set进行预构建。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









