

Python set常用方法详解:add、remove与discard的区别及使用场景
深入解析 Python set(集合)的核心修改方法,详细对比 add、remove 与 discard 的底层机制、异常行为、幂等性与时间复杂度,并提供最佳实践与选型指南。
set(集合)是基于哈希表实现的无序且不重复的元素容器。向集合中添加元素使用 add(),其在元素已存在时会静默去重;从集合中移除特定元素时,remove() 与 discard() 都能在元素存在时将其删除,两者的根本区别在于当目标元素不存在时:remove() 会主动抛出 KeyError 异常中断程序,而 discard() 则静默忽略并安全返回 None。掌握这一关键机制,能够帮助开发者写出更安全、更具幂等性且更高性能的集合操作代码。
一、Python set 的底层哈希机制与 add() 方法
Python 的 set 底层本质上是一个经过高度优化的紧凑型哈希表(Hash Table)。与字典(dict)存储键值对不同,集合只存储哈希键(Key)。这决定了存入集合中的每个元素都必须是可哈希对象(Hashable),即对象必须实现 __hash__() 和 __eq__() 方法,且在生命周期内哈希值保持恒定。
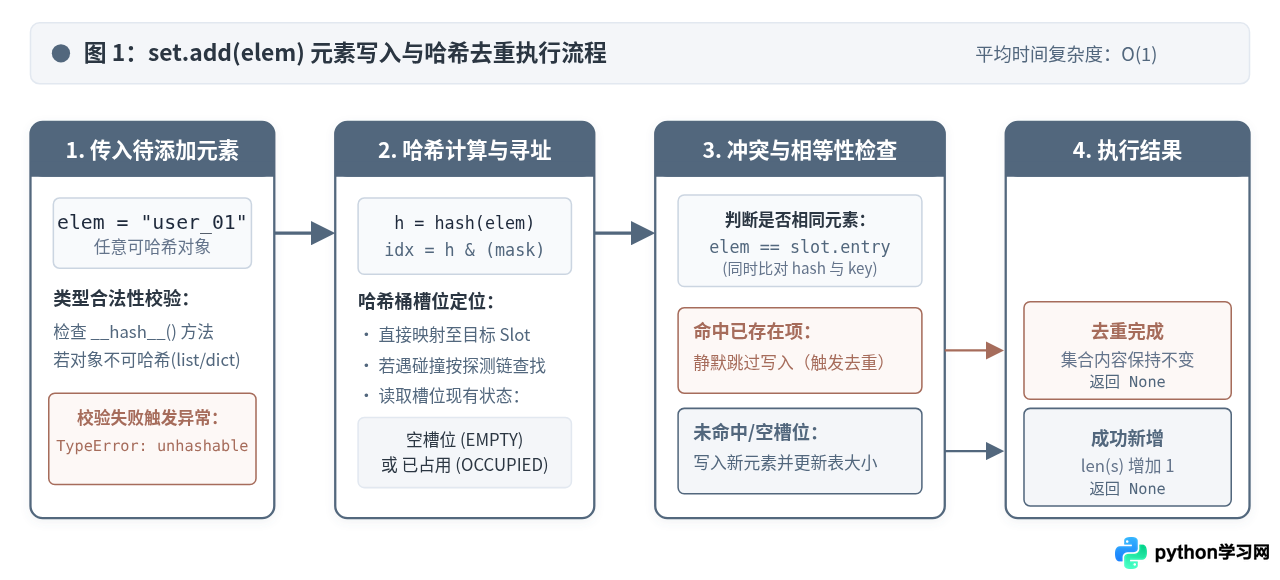
当调用 s.add(elem) 时,Python 会首先计算目标对象的哈希值,通过哈希掩码寻址到底层哈希桶(Bucket)。如果该槽位为空,则将元素直接写入;如果槽位已被占用,则通过相等性校验(elem == slot.entry)检查是否为重复项。若确认已存在相同元素,Python 会直接放弃写入并返回 None,这一过程即实现了集合天然的幂等去重机制。
1. add() 基础用法与去重示例
# 初始化一个包含基础标签的集合
tags = {"python", "backend"}

# 添加全新元素
tags.add("docker")
print("添加新元素后:", tags)

# 添加已存在的元素(静默去重,不报错)
tags.add("python")
print("再次添加已有元素后:", tags)再次添加已有元素后: {'backend', 'docker', 'python'}
2. add() 的入参约束与常见陷阱
add() 仅接受单个元素作为参数,且该元素必须是可哈希的不可变类型(例如整数、浮点数、字符串、元组或 frozenset)。如果试图将列表(list)、字典(dict)或其他集合传入 add(),解释器将在哈希阶段直接抛出 TypeError:
numbers = {1, 2, 3}

try:
    # 错误尝试:将可变对象列表作为元素存入集合
    numbers.add([4, 5])
except TypeError as err:
print("捕获类型异常:", err)s.add([1, 2]) 批量添加元素。若需要将一个可迭代对象(列表、元组等)中的全部元素逐一合并到集合中,应该使用 s.update(iterable) 而非 add()。
二、核心对比:remove() 与 discard() 的本质区别
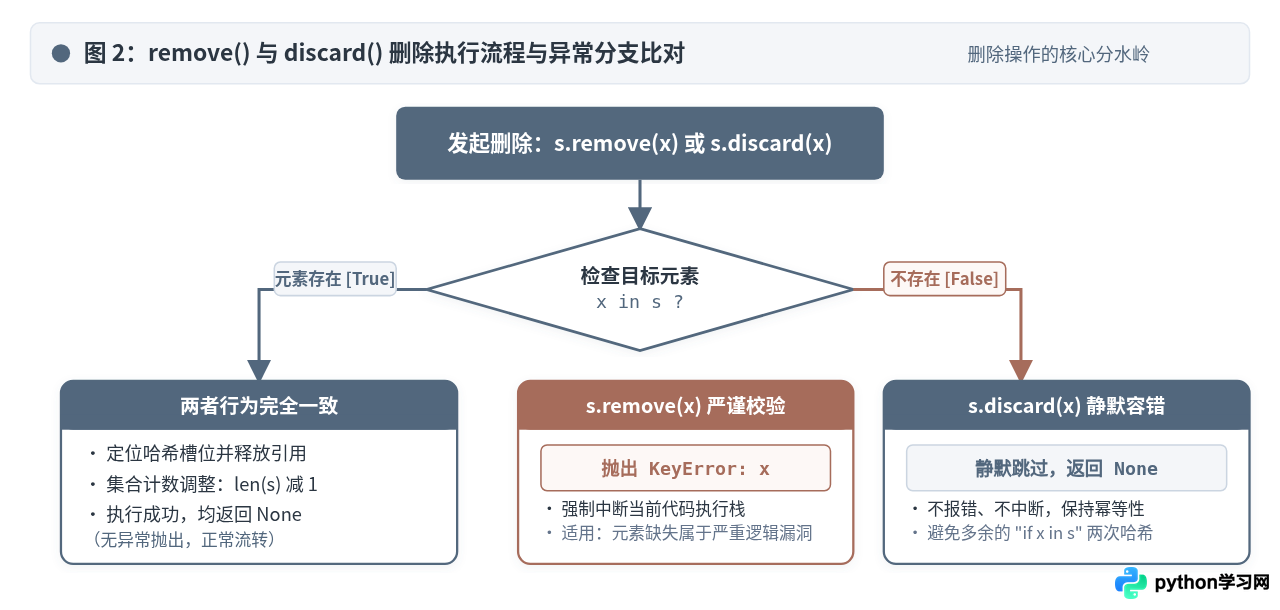
在日常开发中,从集合中删除指定元素最常用的方法是 remove() 和 discard()。从调用语法上看,两者的签名几乎完全一样(均接收一个待删除的元素对象),在目标元素确实存在于集合中时,它们的执行效率和最终结果完全一致——均从底层哈希表中抹除该元素引用,集合长度减 1,并返回 None。
然而,当待删除的目标元素在集合中不存在时,两者的设计哲学发生了决定性分流:
s.remove(elem):严格契约模式。当元素不存在时,立即抛出KeyError: elem异常,强行中断当前线程代码的向下执行。s.discard(elem):安全容错模式。当元素不存在时,直接静默略过,不产生任何异常,正常返回None,保证操作的幂等性。
1. 元素存在时的正常删除比对
s1 = {"apple", "banana", "cherry"}
s2 = {"apple", "banana", "cherry"}

# 元素存在时,两者表现一致
s1.remove("banana")
s2.discard("banana")

print("s1.remove('banana') 结果:", s1)
print("s2.discard('banana') 结果:", s2)s2.discard('banana') 结果: {'apple', 'cherry'}
2. 元素不存在时的分支差异代码验证
fruits = {"apple", "cherry"}

# 1. 使用 discard 删除不存在的项:安全跳过
print("准备执行 discard('orange')...")
fruits.discard("orange")
print("discard 顺利完成,集合状态保持:", fruits)

# 2. 使用 remove 删除不存在的项:触发 KeyError
print("准备执行 remove('orange')...")
try:
    fruits.remove("orange")
except KeyError as err:
print(f"捕获到预期的 KeyError 异常: 找不到键 {err}")discard 顺利完成,集合状态保持: {'apple', 'cherry'}
准备执行 remove('orange')...
捕获到预期的 KeyError 异常: 找不到键 'orange'
3. 警惕性能反模式:避免冗余的 if x in s 预检
在很多初学者的业务代码中,经常能看到如下写法的防御性删除:
# 反模式写法(低效):进行了两次哈希查找
if item in active_users:
    active_users.remove(item)

# 规范高效写法(推荐):仅需一次哈希查找
active_users.discard(item)
在反模式写法中,item in active_users 会先计算一次哈希并进行槽位探测;紧接着 active_users.remove(item) 又重新计算一次哈希并再次寻址。而直接调用 discard(item),Python 底层在一次寻址流程中就能顺理成章地“查找到则删、查找不到则退出”,不仅代码精炼,更直接将哈希开销减少了一半。
三、常用扩展方法横向全景比对
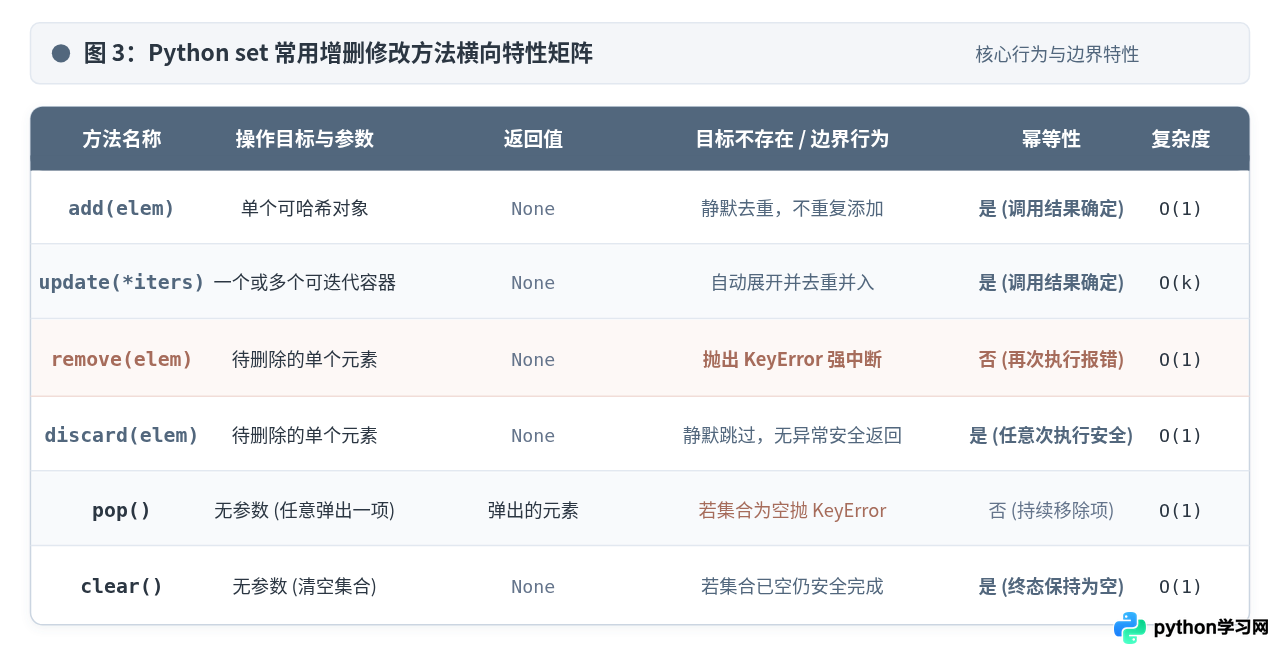
为了在工程开发中做出最优的选型,除了 add()、remove() 和 discard() 之外,集合还提供了批量合并 update()、随机弹出 pop() 以及全局重置 clear()。下表清晰列出了这六个核心修改方法的行为矩阵:
| 方法名称 | 操作类型 | 接收参数 | 元素不存在 / 边界行为 | 幂等性 | 平均时间复杂度 |
|---|---|---|---|---|---|
add(elem) |
单元素添加 | 单个可哈希对象 | 已存在时静默去重 | 是 | O(1) |
update(*iterables) |
批量合并 | 一个或多个可迭代对象 | 批量展开并去重并入 | 是 | O(k),k 为容器元素总数 |
remove(elem) |
严格单元素删除 | 单个待删除元素 | 抛出 KeyError 异常 | 否(再次调用崩溃) | O(1) |
discard(elem) |
容错单元素删除 | 单个待删除元素 | 静默忽略,安全返回 | 是(多次调用安全) | O(1) |
pop() |
随机元素弹出 | 无入参 | 集合为空时抛出 KeyError | 否(持续改变集合) | O(1) |
clear() |
全量清空 | 无入参 | 集合已空时依旧安全完成 | 是 | O(1) |
四、实际业务场景与工程选型指南
在实际编写业务逻辑或基础库时,该如何权衡选择 remove() 还是 discard()?这并不是个人喜好问题,而是取决于代码对状态一致性契约的要求。
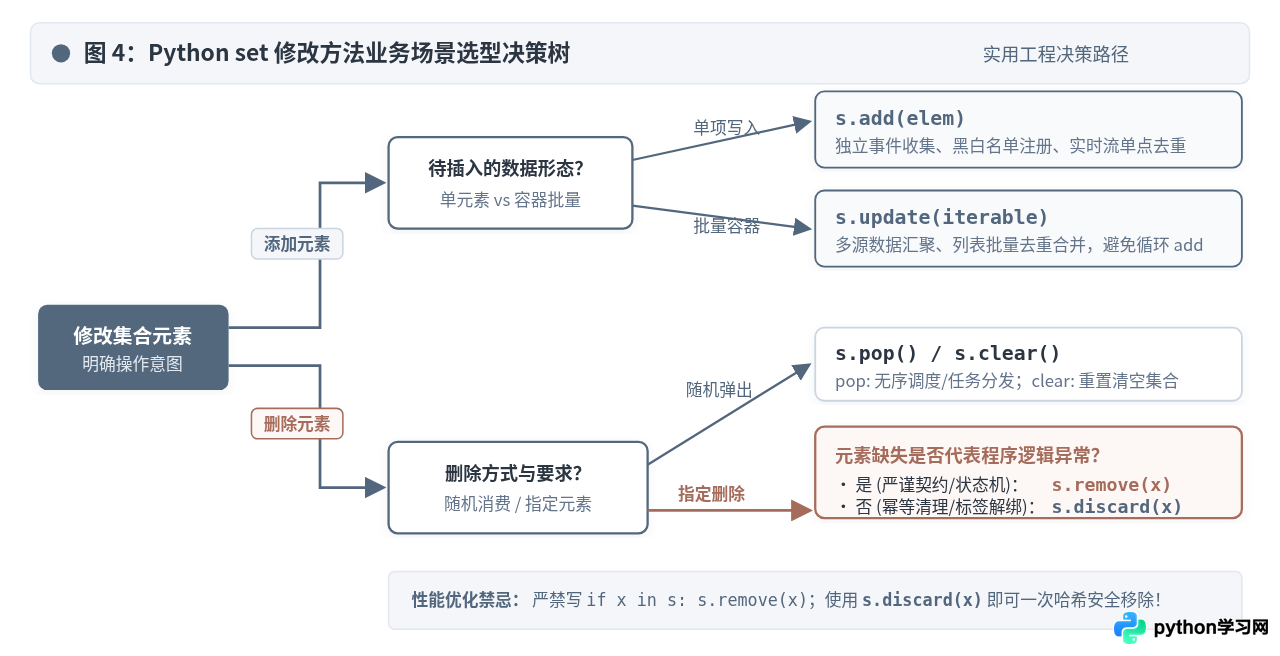
场景 1:状态同步与幂等性清理 —— 首选 discard()
在分布式系统、Web 服务或事件驱动架构中,很多操作需要具备幂等性(Idempotency)。例如:用户的在线状态移除、标签解绑、缓存键淘汰、事件取消订阅等。在这些场景下,业务的核心诉求是“确保该元素不在集合中即可”,至于它在被清理前是否存在,往往无关紧要。
class ConnectionManager:
    def __init__(self):
        self.active_connections = set()

    def disconnect(self, client_id: str):
        # 客户端断开连接时,可能因网络波动产生重复触发
        # 使用 discard 确保多次调用不会引发 KeyError 崩溃
        self.active_connections.discard(client_id)
        print(f"已清理客户端连接: {client_id}")

manager = ConnectionManager()
manager.active_connections.add("conn_8801")

manager.disconnect("conn_8801")  # 正常移除
manager.disconnect("conn_8801") # 重复调用,依然平稳运行已清理客户端连接: conn_8801
场景 2:严格契约与断言式状态机 —— 首选 remove()
如果你的程序在执行到某一行代码时,从逻辑设计上认定该元素必然存在,若不存在则说明前置事务产生了严重脏数据、状态机被非法篡改或出现了竞态条件,此时应当果断使用 remove()。
remove() 能够像断言(Assert)一样让异常在第一时间暴露,避免脏数据在静默中向下传递,导致更隐蔽、更难以排查的生产故障:
class TaskStateMachine:
    def __init__(self):
        self.running_tasks = {"task_101", "task_102"}

    def complete_task(self, task_id: str):
        # 任务完成前必须处于 running 集合中
        # 若不在,说明状态机发生非法调用或并发重复结算,立即报错阻断
        try:
            self.running_tasks.remove(task_id)
            print(f"任务 {task_id} 状态结算完毕并移出运行队列")
        except KeyError:
            print(f"[严重告警] 非法结算:任务 {task_id} 未在运行队列中!")

machine = TaskStateMachine()
machine.complete_task("task_101")
machine.complete_task("task_999") # 非法任务 ID[严重告警] 非法结算:任务 task_999 未在运行队列中!
场景 3:大批量数据导入与吞吐优化 —— 首选 update()
当需要将数以万计的数据并入集合时,使用 for item in data_list: s.add(item) 会产生显著的 Python 虚拟机指令循环开销。而直接调用 s.update(data_list) 会将整个循环交由 CPython 内部底层的 C 语言循环处理,在大数据量下通常能获得 2 到 4 倍的性能提升。
五、总结与编码规范建议
回顾 Python 集合的核心修改操作,掌握以下三条工程准则即可应对绝大部分场景:
- 添加元素:单元素无脑使用
add(elem);批量元素优先使用update(iterable),同时牢记集合只能存入可哈希对象。 - 删除元素:需要保证重复调用安全、幂等清理或不关心历史状态时,坚决使用
discard(elem),杜绝冗余的if x in s双重寻址;在状态机闭环、强一致性校验等要求元素必存的场景下,使用remove(elem)尽早暴露异常。 - 消费与重置:需要实现类似任务分发器随机取出工作项时,使用
pop()(注意捕获空集异常);需要循环复用集合实例时,使用clear()原地清空,保留原对象引用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









