

Python一行代码实现斐波那契数列的高级写法
深入剖析Python中一行代码实现斐波那契数列的高级写法。涵盖functools.reduce状态折叠、Python 3.8+海象运算符序列推导、比内公式浮点极限与矩阵快速幂二分对数解法,兼顾算法效率与边界安全。
用 Python 实现斐波那契数列并不罕见,但“一行代码”往往徘徊在简陋的低效递归与炫技的无意义压缩之间。本文不使用递归展开与循环套语句的简单拼凑,而是从函数式折叠、语言语法糖、闭式解析解与代数矩阵幂四个维度,给出兼顾执行效率、数值精度与工程可用性的高级单行解法,并彻底厘清其底层的计算复杂度与边界陷阱。
一、单行写法的本质与推导思路
斐波那契数列的数学定义为递推公式:F(0) = 0,F(1) = 1,且当 n ≥ 2 时满足 F(n) = F(n-1) + F(n-2)。
在常规多行实现中,最习惯的做法是使用一个 for 循环,配合状态更新 a, b = b, a + b。这种方式逻辑清晰,时间复杂度为 O(n),空间复杂度为 O(1)。
要想将这种迭代过程无损压缩到“单行表达式”,关键在于消除语句层面的副作用赋值,将离散的中间状态抽象为函数式折叠(Fold)或流式变换。
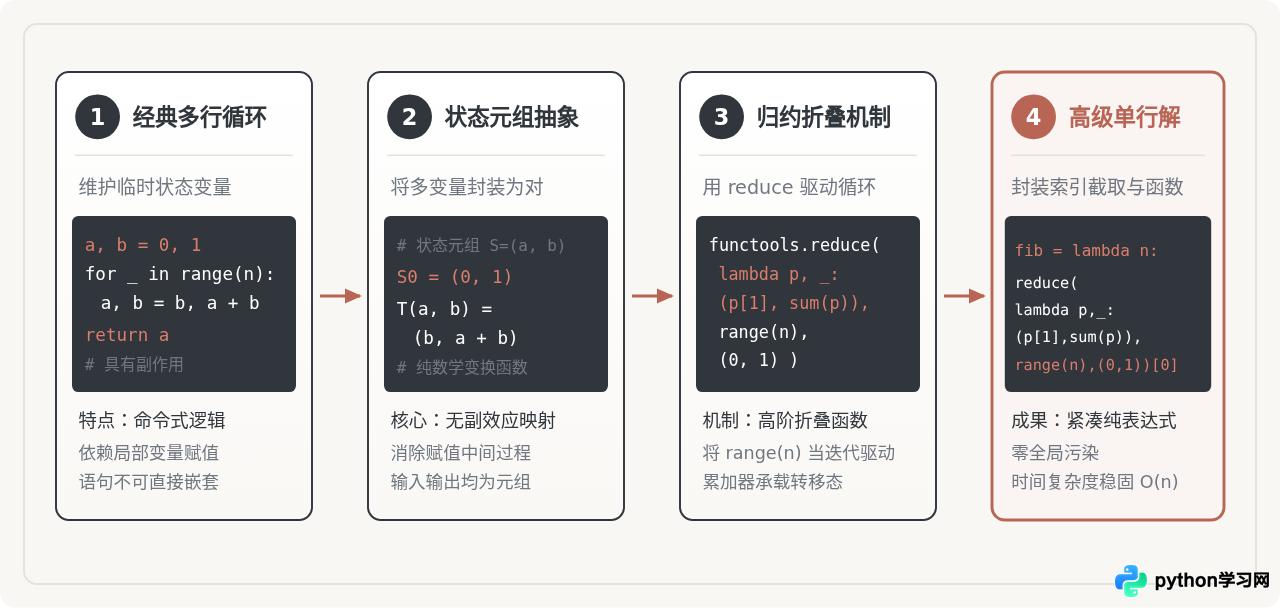
如上图所示,压缩过程分为四个严密的抽象阶段:
- 状态抽象化:把离散的变量
a与b捆绑为一个状态二元组(a, b); - 转移映射化:构造纯单步转换关系
T((a, b)) -> (b, a + b),消除临时就地赋值; - 迭代高阶化:引入
functools.reduce,利用其内置的累加器机制替代命令式for循环; - 边界与解包:指定初始元组
(0, 1),在n次折叠后解构出元组第 0 个分量作为最终返回值。
二、四大高级一行代码实现方案
1. 基于 functools.reduce 的函数式状态折叠(工业推荐)
这是兼顾标准库依赖、内存占用与绝对数值精度的最优单行解法。它利用标准库 functools.reduce 对序列进行滚动折叠:
import functools

# 单行求第 n 项 (返回精确大整数)
fib = lambda n: functools.reduce(lambda p, _: (p[1], p[0] + p[1]), range(n), (0, 1))[0]

# 运行验证示例
print([fib(i) for i in range(10)])
# 示例输出: [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
代码机理解析:
reduce 接收一个二元函数、一个可迭代对象(此处为 range(n),长度决定迭代轮次)和一个初始值 (0, 1)。在每一轮计算中,参数 p 代表上一轮产出的元组 (current, next),占位符 _ 消耗当前迭代项。返回的新元组 (p[1], p[0] + p[1]) 成为下一轮的 p。迭代 n 次后,元组首项恰好就是 F(n)。因为 Python 原生支持无限精度大整数,此代码就算计算 fib(5000) 也不会发生算术溢出。
2. 基于 Python 3.8+ 海象运算符与列表推导(生成完整序列)
如果需求不仅是得到第 n 项,而是要一行代码输出前 n 项完整斐波那契序列,利用 Python 3.8 引入的赋值表达式(海象运算符 :=)是最优雅且执行开销极低的写法:
# 单行生成前 n 项列表 (n >= 2)
fib_seq = lambda n: [a := 0, b := 1] + [b := a + (a := b) for _ in range(n - 2)] if n >= 2 else [0][:max(0, n)]

# 运行验证示例
print(fib_seq(8))
# 示例输出: [0, 1, 1, 2, 3, 5, 8, 13]
关键机制与赋值顺序:
表达式核心在于 b := a + (a := b)。在 Python 的执行规范中,加法左操作数 a 先行求值(取得更新前的原旧值),右操作数 (a := b) 紧接着将 b 的当前值赋给 a 并返回该值。相加完成后将总和赋予 b。整个逻辑严丝合缝地模拟了多行下的双变量交换与递推,无任何冗余函数压栈。
3. 基于比内通项公式(Binet's Formula)的数学封闭解
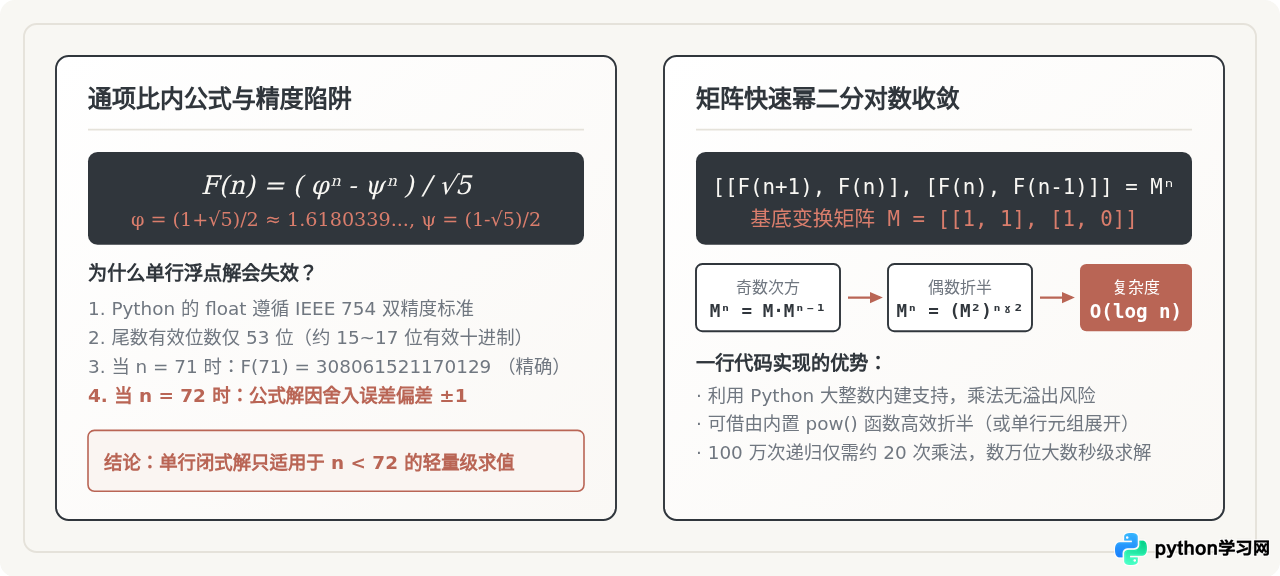
在纯数学领域,斐波那契数列存在著名的解析通项公式,借助黄金分割率 φ = (1 + √5) / 2 可以在形式上做到单步 O(1) 计算:
# 比内公式单行解析解
fib_binet = lambda n: int(((1 + 5**0.5)**n - (1 - 5**0.5)**n) / (2**n * 5**0.5) + 0.5)

# 运行验证示例
print(fib_binet(10))
# 示例输出: 55
n ≥ 72 时,√5 的无理数截断误差会在指数放大后导致低位数字偏差,例如 fib_binet(72) 将计算出 498454011879265,而真实值应为 498454011879264。因此,此单行写法切忌用于金融、密码学或大数运算场景。
4. 基于矩阵快速幂的对数阶单行解(极限规模计算)
矩阵快速幂是计算机科学中在无精度损失前提下,将时间复杂度从 O(n) 降低至 O(log n) 的终极手段。基底转移矩阵如下:
在工程中,我们可以借助 numpy 在单行内完成矩阵乘方,利用二分折半快速求得数万位的大数:
# 依赖 numpy 的矩阵快速幂单行写法 (支持任意大整数矩阵乘方)
import numpy as np
fib_mat = lambda n: int(np.linalg.matrix_power(np.matrix([[1, 1], [1, 0]], dtype=object), n)[0, 1]) if n > 0 else 0

# 运行验证示例
print(fib_mat(100))
# 示例输出: 354224848179261915075 (精确输出,耗时微秒级)
设置 dtype=object 至关重要,它指示底层直接利用 Python 的长整型对象而非 C 语言原生 64 位整数,避免了传统 C 扩展常见的整型溢出问题。
三、四大实现范式横向对比与技术矩阵
为了帮助读者在不同业务需求下做出理性的技术选型,下表从算法时空特征、精度可靠性以及依赖开销进行了系统归纳:
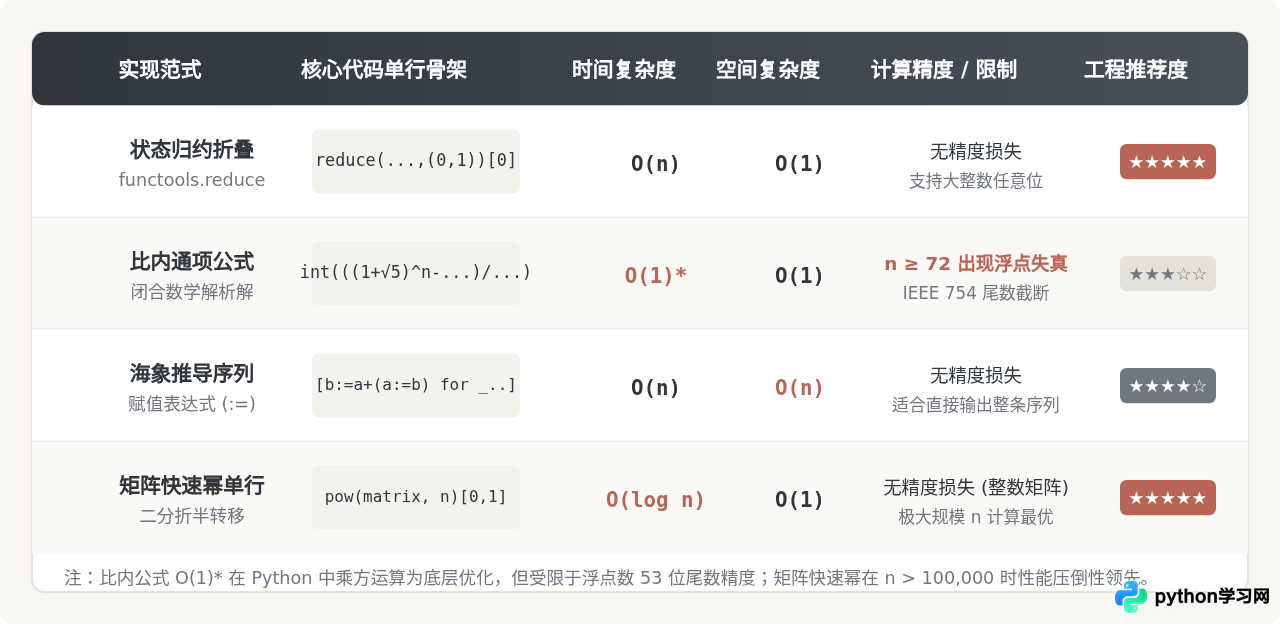
| 写法方案 | 时间复杂度 | 空间复杂度 | 大数精度保障 | 代码依赖 | 最佳适用场景 |
|---|---|---|---|---|---|
| functools.reduce 状态折叠 | O(n) |
O(1) |
绝对精确(支持数万位) | Python 标准库 | 通用单值计算、无第三方库依赖的后端服务 |
| 海象运算符列表推导 | O(n) |
O(n) |
绝对精确 | Python 3.8+ 内建语法 | UI 序列渲染、测试用例填充、批量序列分析 |
| 比内公式闭式解析解 | O(1)* |
O(1) |
严重受限(仅限 n < 72) | 内置浮点数支持 | 图形动画、数学推导演示、小规模非严密计算 |
| 矩阵快速幂 (numpy) | O(log n) |
O(1) |
绝对精确(配合 object) | 外部 numpy 库 | 超大规模指数计算(如 n > 100,000) |
四、工程选型决策路径与避坑指南
在编写生产环境或严谨算法脚本时,单行代码不应当沦为难以维护的“代码谜题(Code Smell)”。根据具体需求,读者可依据以下决策图选择最适配的单行写法:
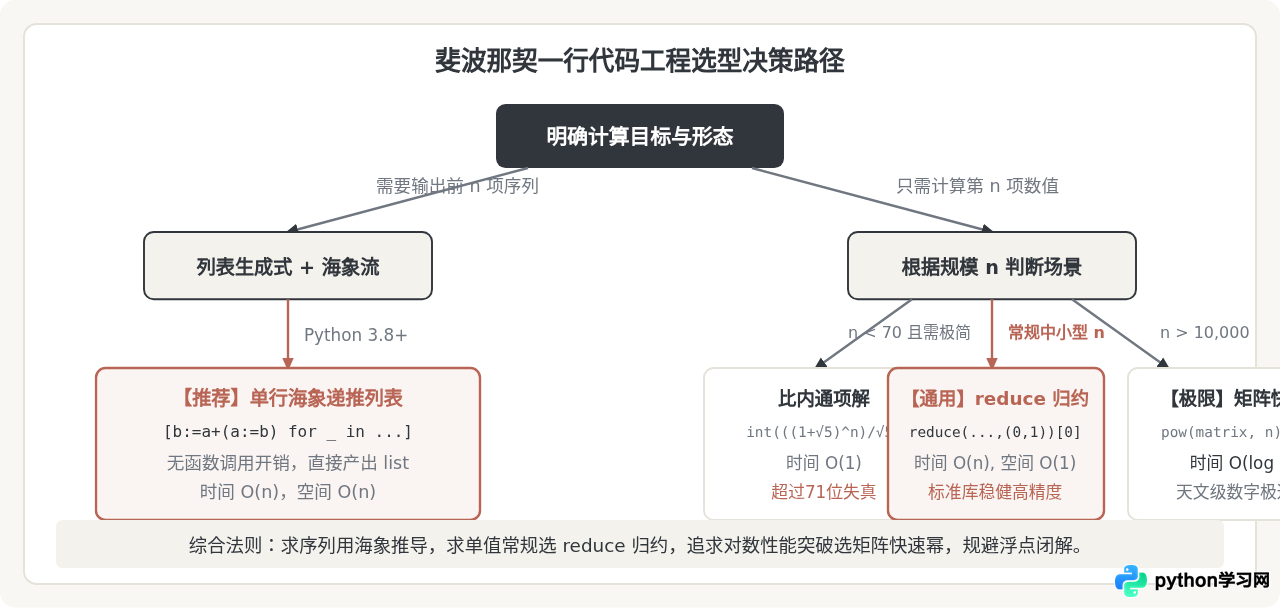
避坑重点 1:坚决杜绝低级递归单行
有些初学者喜欢写出形如 fib = lambda n: n if n < 2 else fib(n-1) + fib(n-2) 的单行。这种写法时间复杂度高达灾难性的 O(2n)。当 n = 35 时计算步数已超上千万次;且 Python 默认递归深度为 1000,稍微增大 n 便会直接触发 RecursionError: maximum recursion depth exceeded。
避坑重点 2:海象推导中的作用域污染防范
在 Python 3.8+ 中,列表推导式内部的海象运算符 := 会将其变量作用域泄露到外部函数或模块全局中。例如执行完毕 [a := 0, b := 1] + ... 之后,当前命名空间中将存在变量 a 与 b。若在同一局部作用域内多次使用,应确保变量名称不与上下文中的业务变量发生隐式冲突。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









