

Python读取Excel指定列名不存在时怎么避免程序崩溃

在利用 Python 处理业务 Excel 文件时,最常见的致命异常莫过于 KeyError: '指定列名'。当上游业务人员导出表头发生微调、列名包含隐蔽的前后空格、或者版本迭代删除了某些列时,硬编码的列切片操作(例如 df['用户手机号'] 或 pd.read_excel(..., usecols=['列名']))会直接中断整个批处理任务。避免程序崩溃的核心在于确立明确的防御性机制:在读取阶段通过清洗排除空格等格式假缺失,在提取前通过集合运算区分必须列与可选列,并利用 reindex 或默认值映射进行平滑回退,从而保证批处理流水线持续稳健运行。
一、Excel列名缺失导致崩溃的触发链路与根因剖析
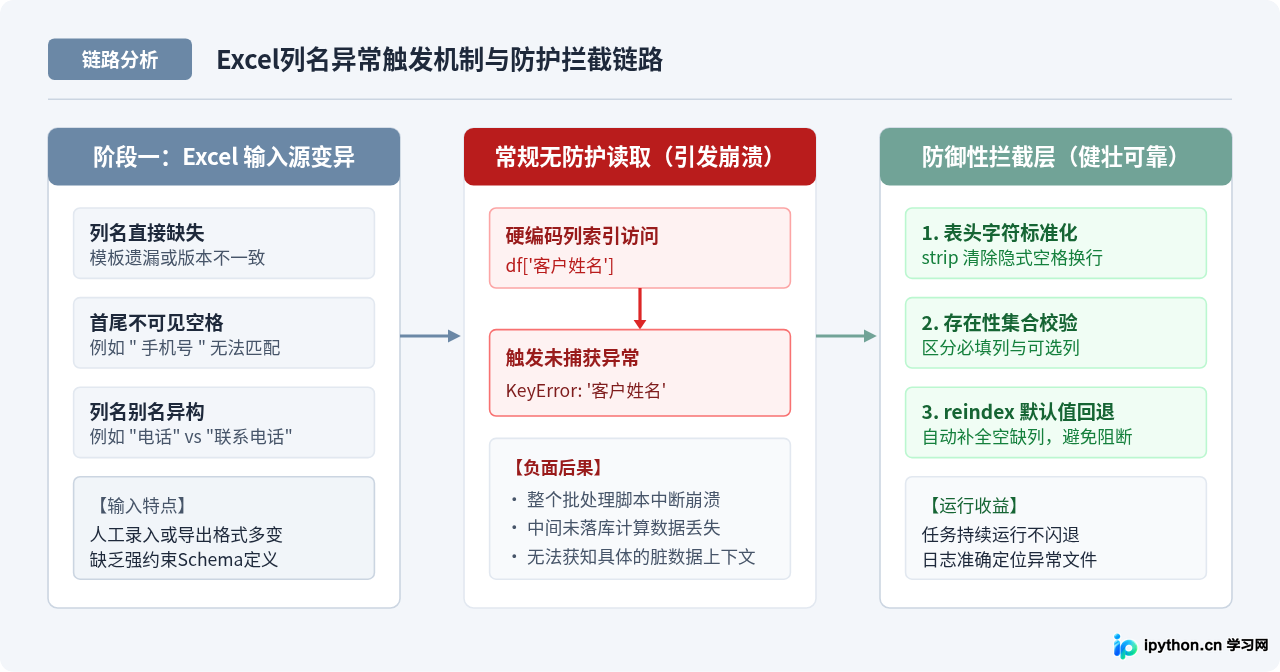
在数据处理脚本中,开发者通常假设 Excel 表格具备完全固定的数据结构。然而现实业务场景中,Excel 文件往往由人工填写、不同第三方系统导出或历史多版本脚本生成。未做防御措施的代码在遇到列名异常时,通常会经历以下崩溃链路:
- 硬编码索引崩溃:使用 pandas 加载表格后,直接执行
df[['订单号', '客户名称', '联系电话']]。一旦表格中缺少任何一列,pandas 内部的索引器会立刻抛出KeyError,未捕获时主进程直接闪退; - 隐式格式失配:肉眼在 Excel 界面中看到的列名是“客户姓名”,但单元格实际存储的是
"客户姓名 "(包含尾随空格)或"客户\n姓名"。程序字面查找失败,引发等同于列缺失的假性报错; - usecols 预加载报错:为了节约内存,开发者常在
read_excel中指定usecols=['列A', '列B']。当 Excel 文件内不存在列表中的某一列时,pandas 会直接抛出ValueError,阻止整个工作表的加载。
为了直观展现传统无防护读取与防御性读取之间的架构差异,下图详细梳理了从 Excel 输入变异到防护层拦截的完整链路:
二、容错策略选型与技术路径对比
面对列名缺失时,不同的业务场景对容错的要求并不一致。例如,财务计算中的“交易金额”列缺失与问卷中的“用户备注”列缺失具有完全不同的严重程度。在实际工程落地中,应根据业务属性选择匹配的技术策略:
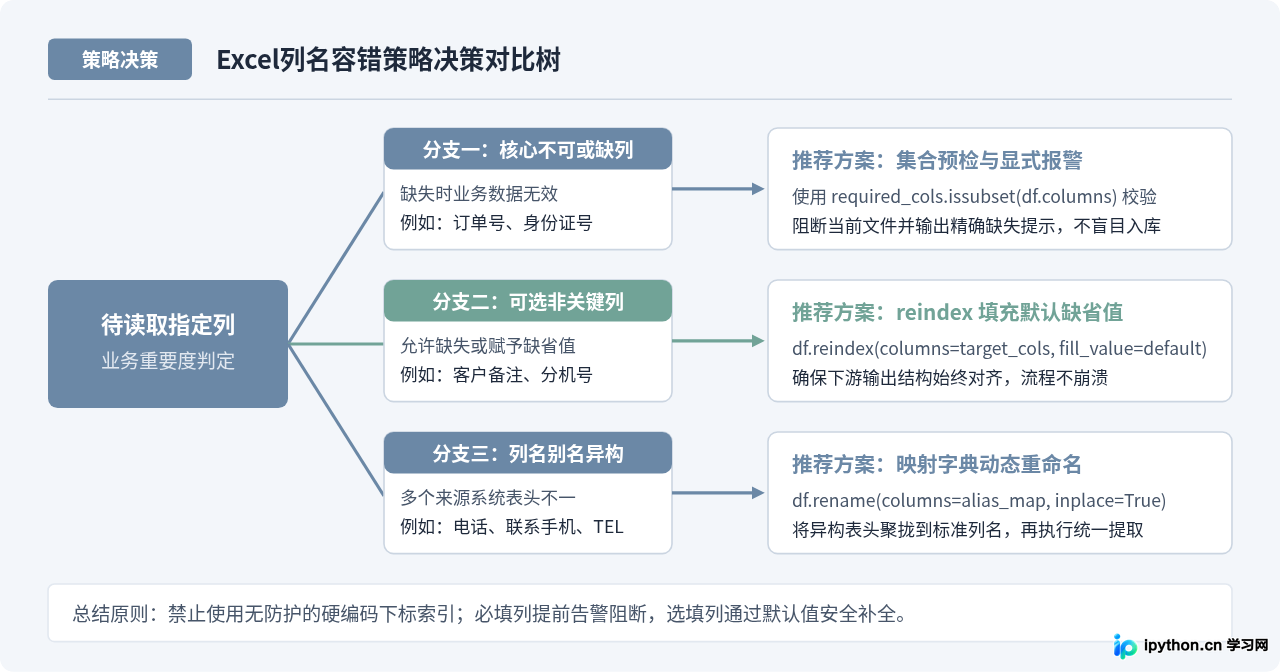
三、四步实操:构建防御性读取操作流水线
在实际代码编写中,建议将对 Excel 的读取过程拆分为四个独立的防御阶段。各阶段环环相扣,彻底杜绝意外崩溃。
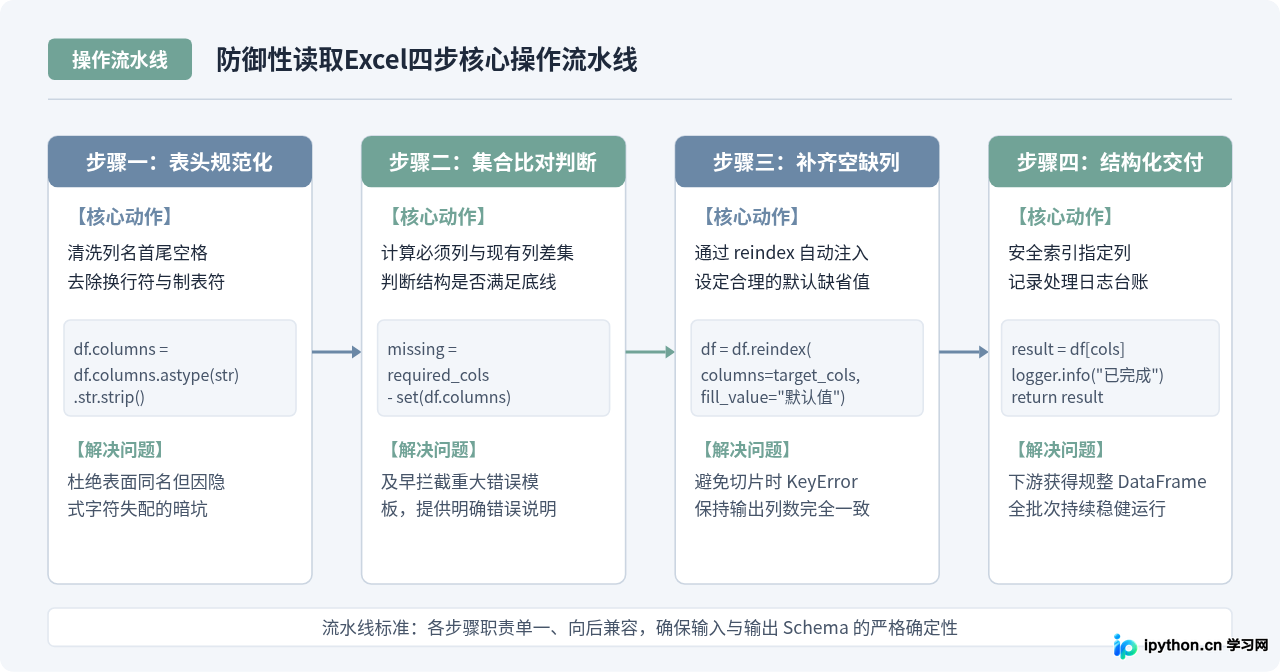
步骤一:表头清洗与格式标准化
在加载 DataFrame 后,第一步不要直接访问列,而是立即对 df.columns 进行规范化处理。通过转为字符串并剔除首尾空白字符,可以解决大部分因人为失误导致的假缺失:
import pandas as pd

# 读取原始表格(默认以第一行作为表头)
df = pd.read_excel('sales_data.xlsx')

# 统一清理列名:转为字符串,并去除首尾空格、制表符
df.columns = df.columns.astype(str).str.strip()
步骤二:区分必须列与可选列,利用集合比对
明确区分哪些列是后续业务处理必须具备的核心数据,哪些是允许缺省的辅助信息。通过 Python 原生的 set 集合运算,可以瞬间找出当前表格缺少的关键列:
# 业务必须列(缺失则该记录无意义)
required_columns = {'订单编号', '客户姓名', '实收金额'}

# 当前表格中实际缺失的必要列
missing_required = required_columns - set(df.columns)

if missing_required:
    # 显式抛出业务层异常或记入日志,阻断该文件并明确告知具体原因
    raise ValueError(f"Excel文件缺少必要列: {missing_required},已跳过该文件处理")
步骤三:使用 reindex 安全对齐结构并补齐缺省值
如果希望提取一组固定列,而某些可选列在部分旧文件中可能不存在,最优雅的方法不是写循环判断 if col in df: df[col] = '',而是使用 pandas 内置的 reindex 方法:
# 下游处理所需的标准字段顺序
target_columns = ['订单编号', '客户姓名', '实收金额', '客户备注', '推荐人']

# reindex 会自动保留已存在列,为不存在的列自动创建并填充指定值
df_standardized = df.reindex(columns=target_columns, fill_value='未填写')
通过该操作,即使某些文件中没有“客户备注”或“推荐人”,生成的 df_standardized 依然严格具备全部 5 列,且缺失位置会自动填入 '未填写',避免下游计算逻辑抛错。
步骤四:安全切片与下游交付
经过前三步的处理,此时直接使用 df_standardized[target_columns] 已经是百分之百安全的操作。整个流水线不仅杜绝了未捕获异常的崩溃风险,同时保证了多文件合并时列维度完全对齐。
四、工程化实战:可复用的安全读取封装函数
在生产环境中批量导入大量 Excel 时,往往需要将上述逻辑整合为一个高度复用、自带异常审计的通用工具函数。以下提供可以直接用于生产项目的安全封装代码:
import os
import logging
from typing import List, Optional, Dict
import pandas as pd

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger(__name__)

def safe_read_excel(
    file_path: str,
    required_cols: Optional[List[str]] = None,
    optional_cols: Optional[Dict[str, object]] = None,
    alias_map: Optional[Dict[str, str]] = None,
    sheet_name: object = 0
) -> Optional[pd.DataFrame]:
    """
    安全读取Excel文件指定列,避免列缺失崩溃。

    :param file_path: Excel文件路径
    :param required_cols: 必须存在的关键列列表,缺失则返回None并记录错误
    :param optional_cols: 可选列字典,key为列名,value为该列不存在时的默认填充值
    :param alias_map: 列名同义词映射字典,例如 {"手机号": "联系电话"}
    :param sheet_name: 工作表名称或索引
    :return: 规范化对齐后的 DataFrame,若严重缺失则返回 None
    """
    if not os.path.exists(file_path):
        logger.error(f"文件不存在: {file_path}")
        return None

    try:
        # 1. 加载文件
        df = pd.read_excel(file_path, sheet_name=sheet_name)

        # 2. 规范化清洗表头
        df.columns = df.columns.astype(str).str.strip()

        # 3. 处理列名别名替换
        if alias_map:
            df.rename(columns=alias_map, inplace=True)

        current_cols = set(df.columns)

        # 4. 校验必须列
        req_set = set(required_cols or [])
        missing_req = req_set - current_cols
        if missing_req:
            logger.error(f"文件 [{os.path.basename(file_path)}] 缺失必须列: {missing_req},放弃本次导入")
            return None

        # 5. 组合目标列并使用 reindex 兜底补齐
        opt_dict = optional_cols or {}
        all_target_cols = list(required_cols or []) + list(opt_dict.keys())

        # 先以空值整体对齐字段结构
        df_result = df.reindex(columns=all_target_cols)

        # 针对各个可选列填充对应的独立缺省值
        for col_name, default_val in opt_dict.items():
            if col_name not in current_cols:
                df_result[col_name] = default_val
            else:
                # 若原本存在但单元格为空,也可选择性补齐
                df_result[col_name] = df_result[col_name].fillna(default_val)

        logger.info(f"文件 [{os.path.basename(file_path)}] 安全读取成功,记录数: {len(df_result)}")
        return df_result[all_target_cols]

    except Exception as exc:
        logger.exception(f"读取Excel过程发生意外故障: {file_path}, 详情: {exc}")
        return None
read_excel 中传入可调用函数作为 usecols 参数:usecols=lambda col: str(col).strip() in expected_set。这样即使目标列不存在,也不会触发 ValueError,pandas 仅会加载与预期集合交集的列,随后再结合 reindex 补齐缺失列即可。
五、总结与生产级容错全景
避免 Python 读取 Excel 时因列名不存在而崩溃,本质上是一个关于输入契约管理与系统健壮性的工程课题。通过在数据流入口处实施多层防御,可以在不可控的外部业务数据与严苛的下游计算程序之间建立坚固的隔离缓冲:
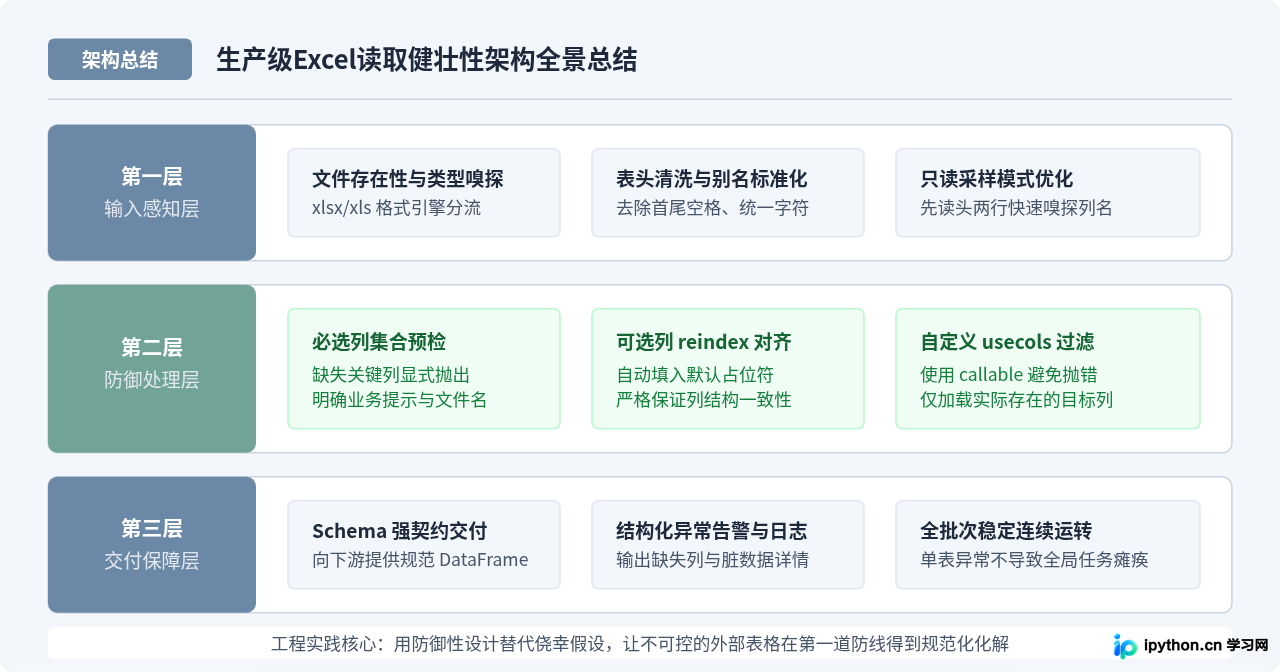
在日常开发中,牢记以下三条黄金准则:
- 绝不裸读:加载表格后,第一时间运行
df.columns = df.columns.astype(str).str.strip()消除隐式空白字符; - 分类处理:核心不可替代列采用集合比对并主动阻断记录告警;可选非关键列采用
df.reindex(columns=..., fill_value=...)进行优雅补齐; - 保留现场:在捕获异常时,记录具体发生故障的文件名、当前表格已有的实际列清单以及缺失列名称,以便上游业务快速修正表格模板。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









