

Python数据科学常用库详解:NumPy、Pandas与Matplotlib
深入详解 Python 数据科学核心三大库 NumPy、Pandas 与 Matplotlib 的底层架构、核心数据结构、协同运作机制、关键 API 实践及高频避坑指南。
一、核心定位与协同协作架构
在现代 Python 数据处理体系中,没有孤立运行的库。任何涉及统计分析、特征工程或建模的任务,实质上都是数据在这三个核心库之间流转并逐级升维的过程:
- NumPy(底层数值基石):提供基于 C 连续内存存储的
ndarray(N 维多维数组)结构。NumPy 剥离了 Python 原生对象的动态类型装箱与内存指针间接开销,利用 CPU 的 SIMD 矢量化指令集提供高速的线性代数与数值计算能力。 - Pandas(业务数据引擎):建立在 NumPy 之上,其核心容器
DataFrame与Series在内部将多个同构 ndarray 封装在BlockManager中,同时引入两层语义维度——行索引(Index)与列名称(Columns),赋予数据对齐、缺失值填充、分组聚合与多表连接能力。 - Matplotlib(出版级绘图底座):作为整个生态的最终视觉呈现接口,Matplotlib 不依赖特定业务结构,可直接接收 ndarray 或 Series 序列,借助其严格的
Figure ➔ Axes ➔ Axis ➔ Artist树形层次模型,精确控制画布上每个刻度、线条与注记。
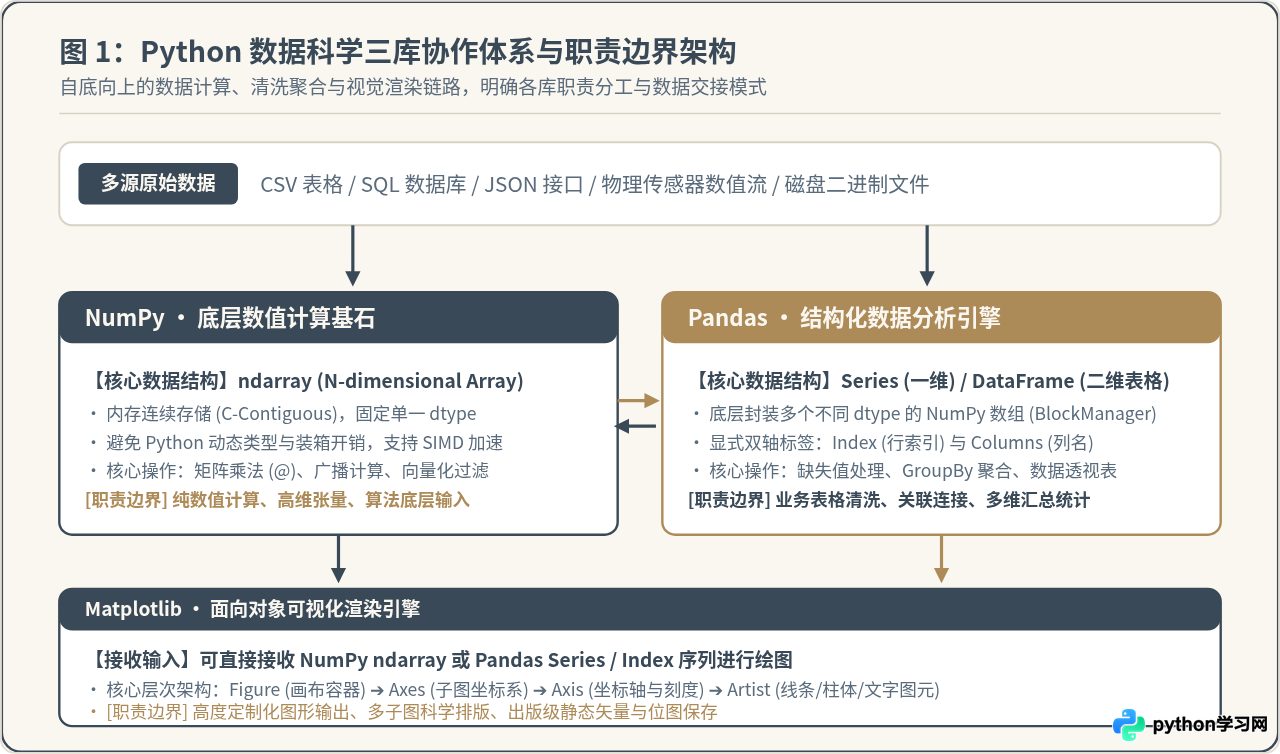
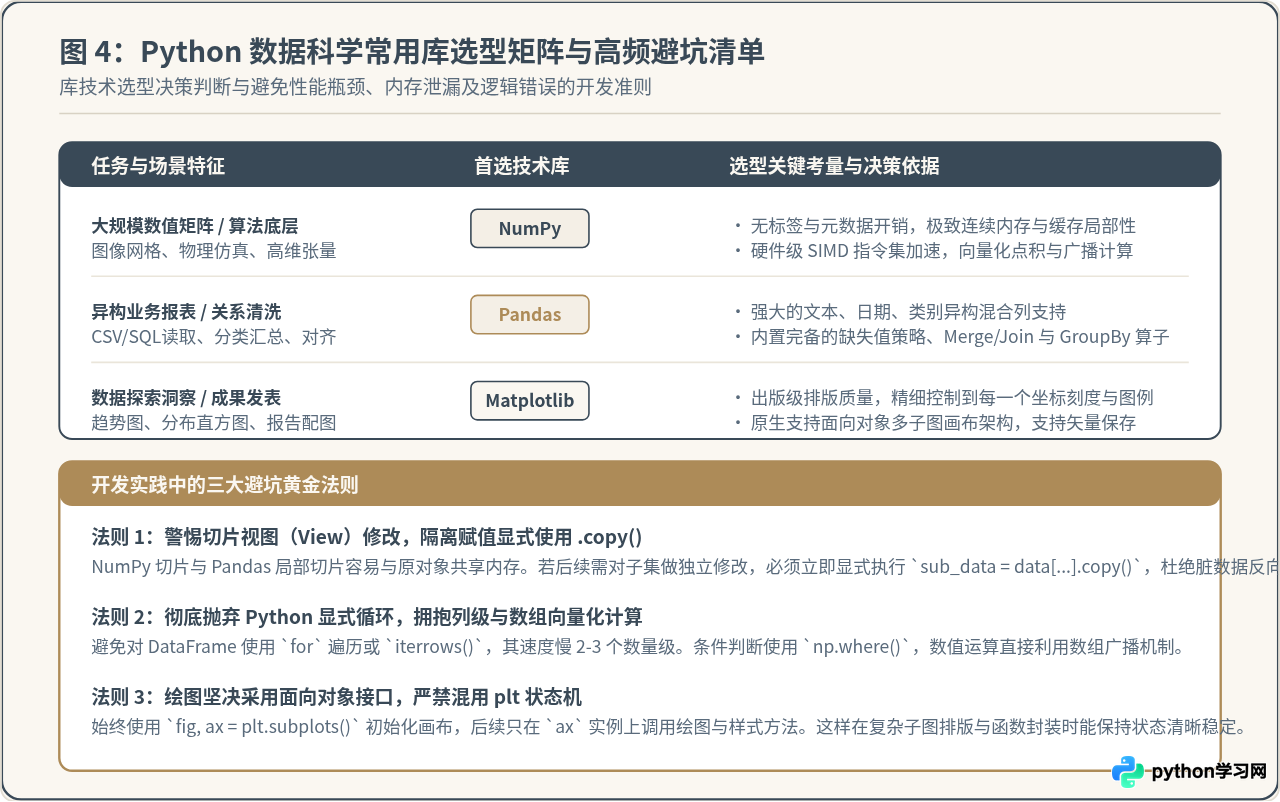
如上图所示,当面对高维度同构浮点数(如图像像素矩阵、声学信号、算法权重)时,应直接选用 NumPy;当面对混杂着文本、日期、浮点与空值的业务交易明细时,首选 Pandas 进行规范化重构;而当需要向业务团队或科研论文输出精准图表时,则由 Matplotlib 承担最后的视觉渲染工作。
二、NumPy:高性能多维数组与向量化计算
NumPy 之所以成为一切科学计算库的底层标准,根本原因在于其 ndarray 对计算机物理内存的组织方式以及向量化运算规则。
1. 内存模型与 ndarray 核心属性
Python 原生列表(list)本质上是一个存放对象指针的动态数组,每个元素在内存中离散分布,导致严重的缓存未命中(Cache Miss)。相比之下,NumPy 的 ndarray 在内存中开辟一段连续空间(C-Contiguous),所有元素必须具有相同的单一类型(dtype)。
import numpy as np

# 创建二维数组并查看底层关键属性
arr = np.array([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]], dtype=np.float64)

print("数组形状 (shape):", arr.shape)    # 示例输出: (2, 3)
print("元素类型 (dtype):", arr.dtype)    # 示例输出: float64
print("维度步长 (strides):", arr.strides)  # 示例输出: (24, 8) -> 沿第0轴移动需24字节,第1轴需8字节
2. 视图(View)机制与切片陷阱
理解 ndarray 切片机制是避免逻辑错误的前提。对 NumPy 数组进行基本切片(如 arr[0:2, :])时,NumPy 默认返回原数组的一个视图(View),而非深拷贝。视图只拥有独立的形状元数据,底层数据指针完全与原数组共享。
如果你从大矩阵中切出一个子矩阵进行归一化或清洗,如果不显式调用 .copy(),对子矩阵的原位修改(如 sub_arr += 10)将直接导致原数组的数据被篡改。
# 视图与副本行为对比验证
orig = np.ones((3, 3))
sub_view = orig[:2, :2]
sub_view[:] = 99.0
print(orig[0, 0])  # 示例输出: 99.0 (原数组已被连带修改!)

# 正确做法:显式复制以获得独立数据块
safe_sub = orig[:2, :2].copy()
safe_sub[:] = 0.0
print(orig[0, 0])  # 示例输出: 99.0 (原数组受保护,未被改动)
3. 广播机制(Broadcasting)的计算规则
广播使得两个形状不同的数组能够进行算术运算,而无需显式复制数据。广播判定遵循严格的从后向前匹配规则:对于每一个末端维度,当两个数组的轴长相等,或者其中一个数组的轴长为 1 时,广播规则成立。轴长为 1 的数组将沿着该维度进行虚拟拉伸。
# 示例:矩阵中心化 (减去每列的均值)
X = np.array([[10.0, 20.0], [30.0, 40.0], [50.0, 60.0]])  # shape: (3, 2)
col_means = X.mean(axis=0)                                   # shape: (2,)
# (3, 2) 与 (2,) 进行广播相减,(2,) 沿第 0 轴虚拟扩展为 (3, 2)
X_centered = X - col_means
print(X_centered)
# 示例输出:
# [[-20. -20.]
#  [  0.   0.]
#  [ 20.  20.]]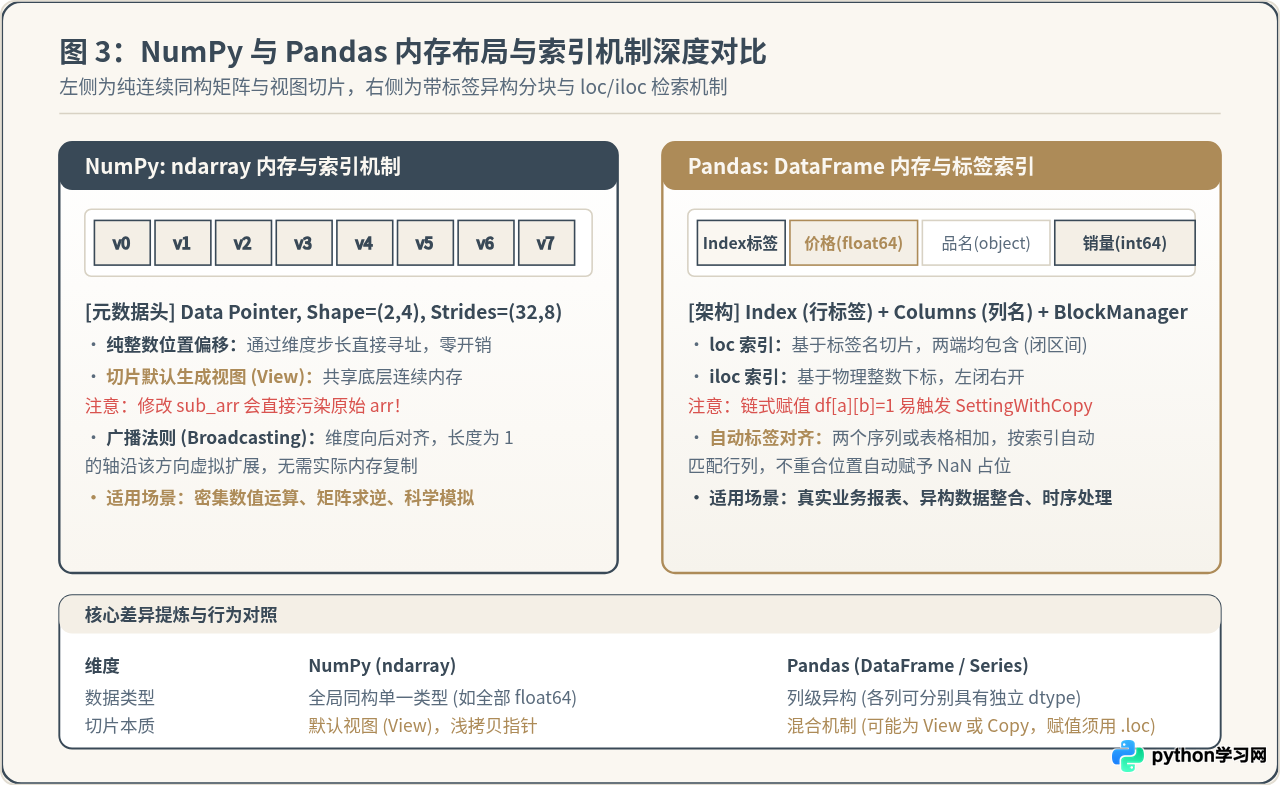
三、Pandas:结构化数据清洗、转换与聚合
当分析任务引入现实业务语义时,单纯依赖数字索引的 NumPy 显得脆弱易错。Pandas 通过在矩阵之上构建显式的标签体系(Index),为复杂异构数据提供高鲁棒性的处理接口。
1. 核心容器:Series 与 DataFrame
Series 是带索引标签的一维同构序列,而 DataFrame 是共享相同行索引(Index)的 Series 集合。由于每列由独立的内存块承载,DataFrame 能够原生支持列与列之间拥有不同的数据类型(如第一列为整数用户 ID,第二列为浮点金额,第三列为时间戳)。
2. 索引机制的精确使用:loc 与 iloc
在工程项目中,严禁随意使用直接下标 df[...] 进行混淆检索,必须明确区分两种索引操作符:
| 操作符 | 检索机制 | 切片边界规则 | 适用场景 |
|---|---|---|---|
loc |
基于显式标签名称(Label-based) | 闭区间:两端标签均包含在内 ([start, stop]) |
根据业务主键、日期或指定列名进行精确定位 |
iloc |
基于物理整数偏移(Integer position) | 左闭右开区间:包含起点,排除终点 ([start, stop)) |
截取前 N 行样本、固定步长采样或矩阵分块操作 |
3. 核心清洗与重构操作流水线
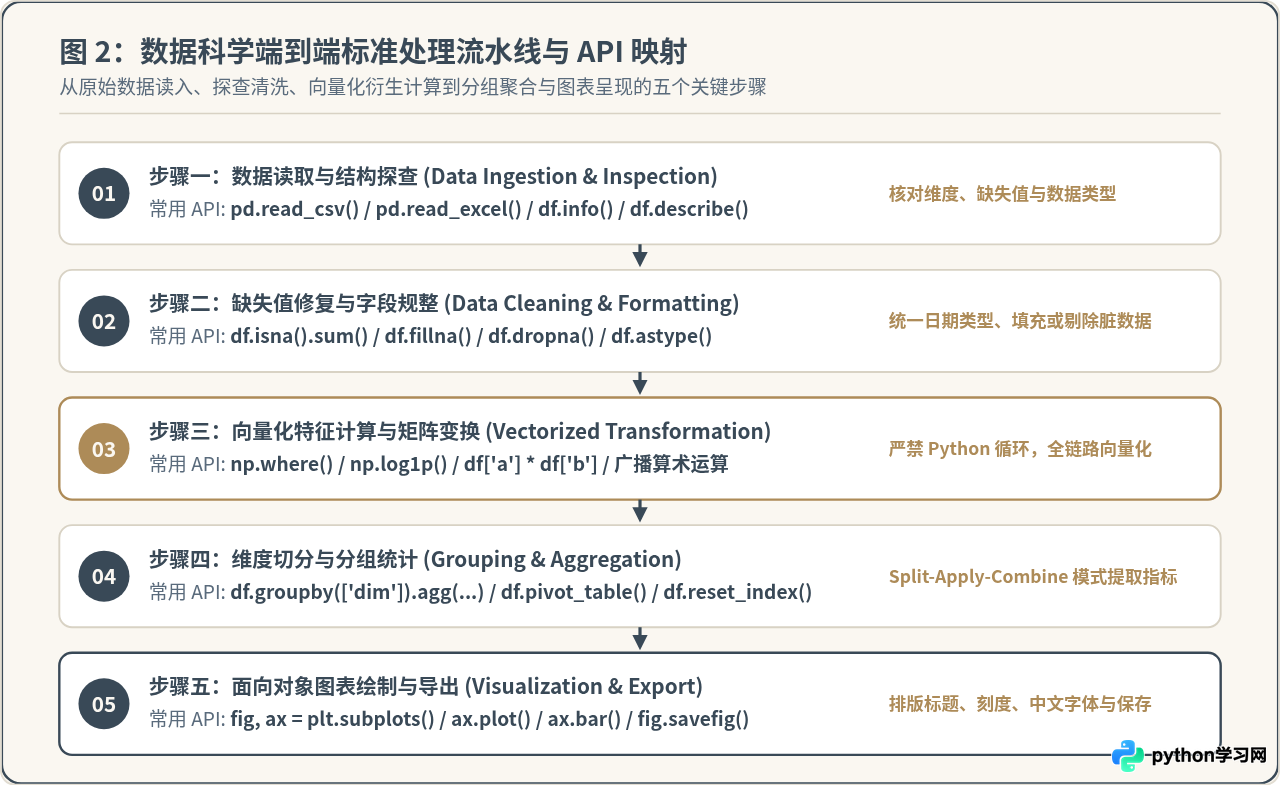
真实数据集往往存在缺失值、脏数据与不合理的类型分布。标准清洗流水线通常包含:检查缺失率 ➔ 策略化填补 ➔ 类型断言 ➔ 分组汇总。
import pandas as pd

# 构造含缺失值的业务示例表格
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "channel": ["线上", "门店", "线上", "线上", "门店"],
    "amount": [250.0, np.nan, 180.0, 320.0, np.nan],
    "discount": [0.9, 0.8, 1.0, 0.85, 0.95]
}
df = pd.DataFrame(raw_data)

# 1. 缺失值填充:按渠道均值对金额进行定向填补
df["amount"] = df.groupby("channel")["amount"].transform(lambda s: s.fillna(s.mean()))

# 2. 向量化派生实际支付列
df["actual_pay"] = df["amount"] * df["discount"]

# 3. 分组统计 (Split-Apply-Combine)
summary = df.groupby("channel").agg(
    order_count=("order_id", "count"),
    total_revenue=("actual_pay", "sum"),
    avg_order_value=("actual_pay", "mean")
).reset_index()

print(summary)
# 示例输出:
#   channel  order_count  total_revenue  avg_order_value
# 0    门店            2         227.25          113.625
# 1    线上            3         659.00          219.667
四、Matplotlib:面向对象的可视化绘图体系
Matplotlib 是 Python 最强大也最常被初学者误解的绘图库。其早期设计借鉴了 MATLAB 的全局状态机模型(plt.plot()),但在任何多子图或生产级脚本中,状态机接口都会导致上下文混淆。工程实践中应 100% 采用面向对象(Object-Oriented, OO)接口。
1. 面向对象层级解剖:Figure 与 Axes
Matplotlib 的所有可视组件构成一棵严密的树状层级:
- Figure(顶层画布):代表整个物理窗口或保存的图片文件,控制分辨率(
dpi)和总尺寸。 - Axes(子图坐标系):属于某个 Figure,是实际承载图表内容(X/Y 轴、刻度、数据线、网格、图例)的独立绘图区域。一张 Figure 可以包含多个平行或网格排列的 Axes。
- Axis(坐标轴):控制具体轴向的数值范围、主副刻度格式化器与刻度标签。
- Artist(图元):画布上可见的任何几何对象(
Line2D、Rectangle、Text)都是 Artist,由 Axes 进行统筹管理并最终光栅化输出。
2. 规范中文字体与负号渲染配置
在输出中文统计图表时,Matplotlib 默认字体库常出现方块乱码(Tofu),且负号符号容易被错误渲染为问号。在导入模块后应统一进行全局参数配置:
import matplotlib.pyplot as plt

# 全局配置中文字体回退列表与负号正常显示
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Microsoft YaHei", "Noto Sans CJK SC", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False  # 确保负号 '-' 正常渲染
3. 面向对象多子图绘制范例
# 创建 1 行 2 列的子图画布
fig, (ax_line, ax_bar) = plt.subplots(nrows=1, ncols=2, figsize=(12, 4.5), dpi=100)

# 左侧子图:绘制折线走势
months = ["1月", "2月", "3月", "4月", "5月"]
dau = [120, 135, 150, 142, 168]
ax_line.plot(months, dau, color="#394957", marker="o", linewidth=2, label="日活用户(k)")
ax_line.set_title("月度日活用户走势", fontsize=13, fontweight="bold")
ax_line.set_ylabel("用户数 (千人)")
ax_line.grid(True, linestyle="--", alpha=0.5)
ax_line.legend(loc="upper left")

# 右侧子图:绘制分类柱状对比
categories = ["电子", "家居", "服装", "美妆"]
sales = [85.4, 62.1, 74.8, 91.2]
ax_bar.bar(categories, sales, color="#AD8B58", width=0.5, label="月销售额(万)")
ax_bar.set_title("各品类月销售额分布", fontsize=13, fontweight="bold")
ax_bar.set_ylabel("销售额 (万元)")
ax_bar.grid(axis="y", linestyle="--", alpha=0.5)
ax_bar.legend()

# 紧凑排列并保存
fig.tight_layout()
# fig.savefig("output_report.png", dpi=300)
五、综合实战演练:从原始数组到完整分析图表
为了展示三库在真实业务分析中的无缝结合,本节提供一段完整、可执行的端到端数据流水线:通过 NumPy 模拟生成随机销售与活跃指标,利用 Pandas 完成结构化时序包装、缺失值清洗与多维聚合,最后借助 Matplotlib 面向对象绘制双子图看板。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 1. NumPy 阶段:固定随机种子并生成 180 天的原始连续多维数据
np.random.seed(42)
n_days = 180
base_trend = np.linspace(50, 120, n_days)
random_noise = np.random.normal(loc=0, scale=8, size=n_days)
raw_sales = np.maximum(10, base_trend + random_noise)

# 模拟随机渠道分类 (0: 移动APP, 1: 网页官网)
channel_flags = np.random.choice([0, 1], size=n_days, p=[0.65, 0.35])

# 2. Pandas 阶段:结构化表格重组、日期索引生成与清洗
dates = pd.date_range(start="2026-01-01", periods=n_days, freq="D")
df = pd.DataFrame({
    "date": dates,
    "sales_amount": raw_sales,
    "channel": np.where(channel_flags == 0, "移动APP", "网页官网")
})

# 注入少量模拟缺失值并进行前向填充修复
mask_na = np.random.rand(n_days) < 0.05
df.loc[mask_na, "sales_amount"] = np.nan
df["sales_amount"] = df["sales_amount"].ffill()

# 按月份与渠道进行透视聚合计算
df["month"] = df["date"].dt.to_period("M")
monthly_summary = df.pivot_table(
    index="month",
    columns="channel",
    values="sales_amount",
    aggfunc="sum"
)

# 3. Matplotlib 阶段:面向对象排版输出可视化图表
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 4.8), dpi=100)

# 图 1:日销售额滚动 7 天平滑趋势线
df["sales_roll_7"] = df["sales_amount"].rolling(window=7, min_periods=1).mean()
ax1.plot(df["date"], df["sales_amount"], color="#D8D2C4", alpha=0.7, label="日销售额(原始)")
ax1.plot(df["date"], df["sales_roll_7"], color="#394957", linewidth=2, label="7天滑动均线")
ax1.set_title("2026 上半年日销售额走势与平滑分析", fontsize=12, fontweight="bold")
ax1.set_ylabel("销售金额 (千元)")
ax1.legend()
ax1.grid(True, linestyle=":", alpha=0.6)

# 图 2:月度分渠道累计业绩对比柱状图
months_labels = [str(m) for m in monthly_summary.index]
x_pos = np.arange(len(months_labels))
width = 0.35
ax2.bar(x_pos - width/2, monthly_summary["移动APP"], width, label="移动APP", color="#394957")
ax2.bar(x_pos + width/2, monthly_summary["网页官网"], width, label="网页官网", color="#AD8B58")
ax2.set_xticks(x_pos)
ax2.set_xticklabels(months_labels, rotation=20)
ax2.set_title("各月渠道销售额累计对比", fontsize=12, fontweight="bold")
ax2.set_ylabel("总销售额 (千元)")
ax2.legend()
ax2.grid(axis="y", linestyle=":", alpha=0.6)

fig.tight_layout()
# plt.show()
六、高频陷阱与开发避坑指南
在日常开发与数据分析中,许多难以排查的 Bug 并非由于语法错误,而是由于对三库底层特性的隐式行为缺乏认知。以下梳理三个最具代表性的避坑准则:
1. 陷阱一:Pandas 链式索引与 SettingWithCopyWarning
当编写 df[df["age"] > 30]["salary"] = 10000 时,Pandas 往往抛出 SettingWithCopyWarning。这是因为 df[df["age"] > 30] 返回的可能是一个中间临时 DataFrame 的视图或副本,第二步 ["salary"] = ... 赋值操作可能修改的是临时对象,导致原 DataFrame 并未按预期被改变。
永远使用单一的 .loc 索引器一步到位进行条件筛选与列赋值:
df.loc[df["age"] > 30, "salary"] = 10000。
2. 陷阱二:误用 Python 原生循环处理大型表格
不少初学者在对每行计算指标时,习惯使用 for idx, row in df.iterrows():。在 Python 解释器中逐行打包成 Series 会产生巨大的对象封装开销,其速度通常比矢量化计算慢 50 至 300 倍。
优先级顺序:原生列级运算 (df['a'] + df['b']) > NumPy 向量化算子 (np.where(...)) > df.apply(lambda ...) > 严禁使用 iterrows()。
3. 陷阱三:Matplotlib 混用全局 plt 与局部 ax
如果在定义了 fig, (ax1, ax2) = plt.subplots(1, 2) 之后,在后续代码中又穿插调用 plt.title("...") 或 plt.xlabel("..."),全局状态机只会把这些修改作用在“当前激活的最后一个子图”上,导致前面的子图缺少标题或标注错位。
一律在具体的子图实例上调用方法:使用 ax1.set_title()、ax1.set_xlabel() 替代 plt.title(),完全杜绝状态机混乱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









