

Python数据分析常见报错修复:SettingWithCopyWarning与KeyError代码解决
详细剖析Python与pandas数据分析中高频出现的SettingWithCopyWarning与KeyError报错成因,给出基于.loc、.copy()及索引规范的代码解决方案与排查流程。
在基于 Python 进行数据清洗与分析时,pandas 库中的 SettingWithCopyWarning 警告与 KeyError 异常是最常遇到的两道门槛。前者源于多层切片引起的“链式赋值”,导致系统难以确定修改作用于原始数据还是临时副本;后者则是由列名隐藏字符、大小写错误或切片后行索引断裂导致的键检索失败。本文针对这两类问题的运行机理,提供标准规范的代码改写方案与系统化的排查路径。
一、SettingWithCopyWarning 的机理与隐患
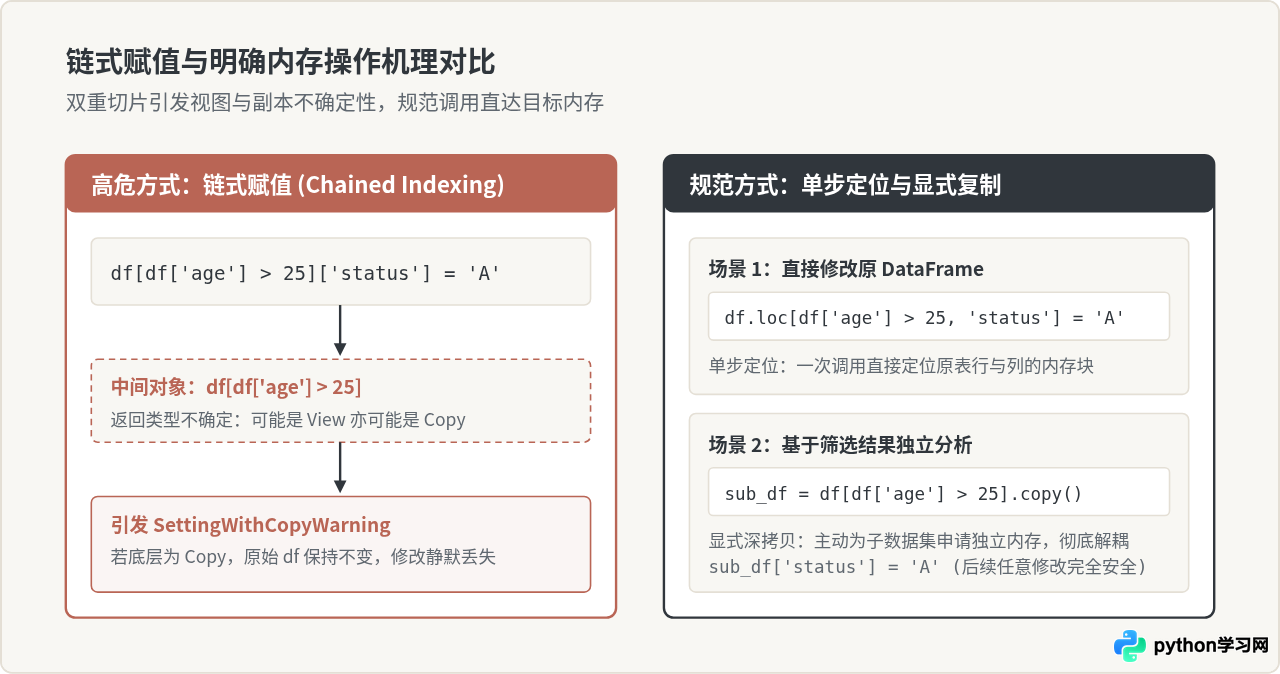
SettingWithCopyWarning 是 pandas 抛出的运行时警告(Warning),而非导致程序直接中断的致命错误(Exception)。但这并不意味着可以忽略它。当该警告出现时,意味着代码正在尝试对一个尚未明确是“视图(View)”还是“副本(Copy)”的对象进行赋值修改。如果目标实际上是副本,赋值修改将只在临时内存中生效,原 DataFrame 的数据完全不会改变;如果目标是视图,修改会穿透到原表。这种不确定性极易导致数据处理结果与预期产生偏差。
最典型的触发场景是“链式赋值”(Chained Assignment),即连续使用两个方括号进行索引与赋值操作,例如 df[condition]['column'] = value。在这个操作中,第一个方括号 df[condition] 会在底层调用 __getitem__ 返回一个中间对象,第二个方括号 ['column'] = value 随后在中间对象上调用 __setitem__。此时 pandas 无法断定这个中间对象是否与原数据共享内存缓冲区。
二、SettingWithCopyWarning 的代码解决方案
消除该警告的核心原则是“明确意图”:如果需要修改原表,必须使用单步基于标签的索引器 .loc;如果需要提取子集后独立处理,必须显式调用 .copy() 创建独立副本。
1. 错误代码与修复示例
考虑以下包含员工信息的示例。假定需要将所有年龄大于 25 岁员工的职级(level)更新为高级:
import pandas as pd

# 准备初始数据
data = {
    'name': ['张三', '李四', '王五', '赵六'],
    'age': [23, 28, 31, 22],
    'level': ['初级', '初级', '初级', '初级']
}
df = pd.DataFrame(data)

# 【错误写法】:触发 SettingWithCopyWarning
# 连续使用切片操作符,造成链式赋值
df[df['age'] > 25]['level'] = '高级'

# 检查原表数据(修改可能根本没有生效)
print(df)
执行上述代码会打印警告信息,且 df 中的 level 字段极有可能依然全部是“初级”。正确的写法是将行条件和目标列合并在单个 .loc 索引器中:
# 【正确写法 1】:直接更新原表
# .loc[行条件, 目标列] = 新值
df.loc[df['age'] > 25, 'level'] = '高级'

print(df)
# 示例输出:
#    name  age level
# 0  张三   23    初级
# 1  李四   28    高级
# 2  王五   31    高级
# 3  赵六   22    初级
2. 子数据集的处理:使用 .copy()
如果在代码中先对数据表进行了筛选,并将结果保存在一个新变量中,随后对新变量进行列赋值,同样会触发该警告:
# 【常见隐式链式错误】
senior_df = df[df['age'] > 25]
senior_df['bonus'] = 5000  # 触发警告:senior_df 是否共享 df 的内存?

# 【正确写法 2】:显式调用 .copy()
senior_df = df[df['age'] > 25].copy()
senior_df['bonus'] = 5000  # 安全执行,无任何警告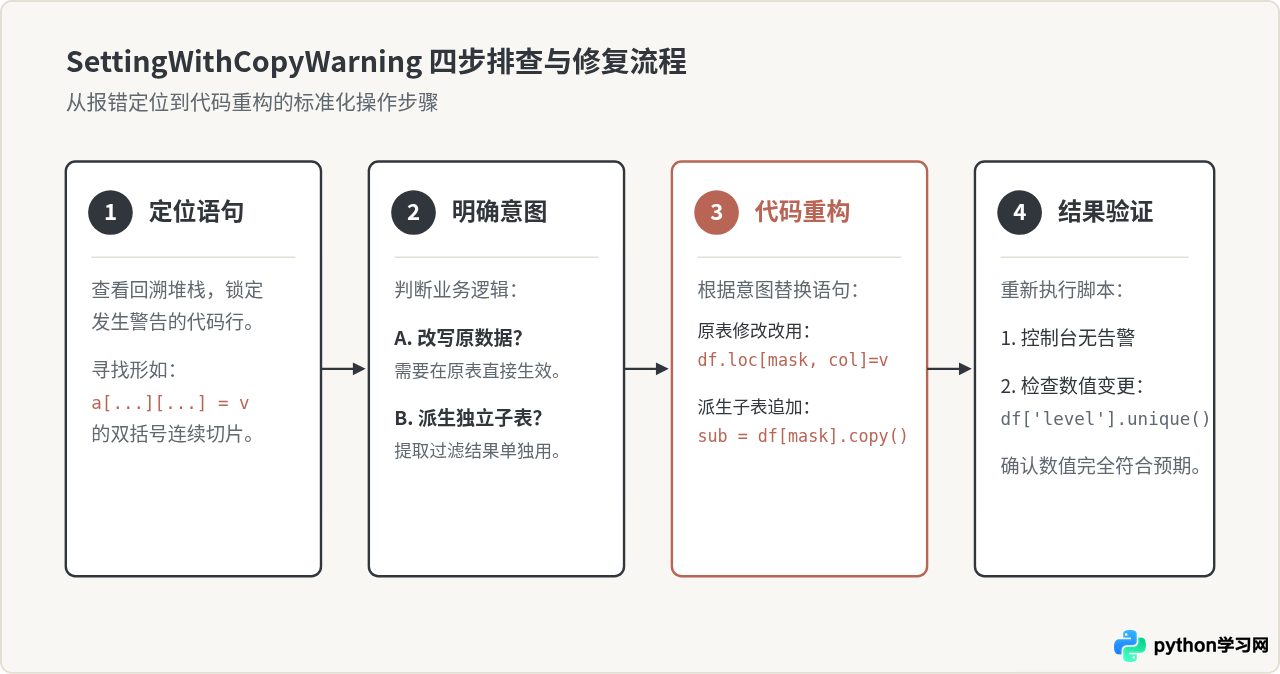
在 pandas 2.0 及后续 3.0 版本中,引入了 Copy-on-Write (CoW) 机制(可通过
pd.set_option('mode.copy_on_write', True) 开启)。在 CoW 模式下,任何切片默认均延迟拷贝,写入时自动触发深拷贝,从而直接从底层消除了 SettingWithCopyWarning。但为了保证代码在不同环境、不同 pandas 版本下的通用性与鲁棒性,依然推荐强制使用 .loc 与 .copy() 的规范写法。
三、KeyError 的典型成因与代码解决
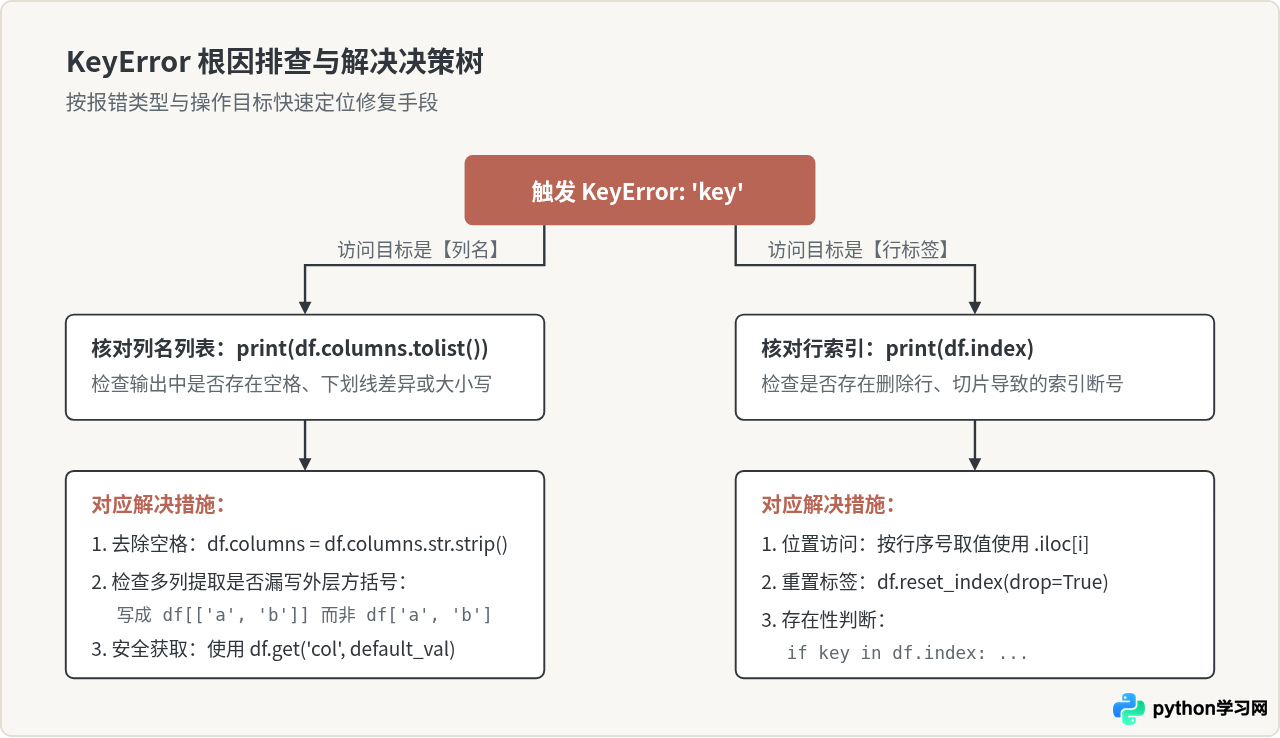
与警告不同,KeyError 是 Python 核心或 pandas 抛出的硬性中断异常。在 pandas 数据处理场景中,KeyError 绝大多数情况下意味着所请求的“列名”或“行索引标签”在当前 DataFrame 的 Index 容器中不存在。主要诱因可归纳为以下三类:
1. 列名存在不可见空格或大小写不匹配
从 CSV、Excel 或数据库导出数据时,表头列名经常包含前导或尾随空格(如 " age " 而非 "age")。代码执行 df['age'] 时便会触发 KeyError: 'age'。
import pandas as pd

# 模拟带有脏表头的数据
df = pd.DataFrame({' name ': ['Alice', 'Bob'], 'Age': [25, 30]})

# 【错误调用】:触发 KeyError: 'name'
# print(df['name'])

# 【防御性清洗方案】:导入数据后第一步统一列名
# 1. 清除所有列名前后空格
df.columns = df.columns.str.strip()

# 2. 统一转为小写,避免大小写冲突
df.columns = df.columns.str.lower()

# 清洗后即可安全访问
print(df['name'])
# 示例输出:
# 0    Alice
# 1      Bob
# Name: name, dtype: object
2. 混淆标签索引 (.loc) 与位置索引 (.iloc)
在经过 drop() 删除部分行,或者基于布尔条件筛选后,DataFrame 的行索引标签(Index)往往会出现断层(例如剩余行索引为 [0, 2, 5])。如果此时使用 .loc[1] 尝试访问第 2 行,就会抛出 KeyError: 1,因为此时已经不存在标签为 1 的行。
df = pd.DataFrame({'val': [10, 20, 30, 40]}, index=[0, 1, 2, 3])

# 删除索引为 1 的行
filtered_df = df.drop(1)
print(filtered_df.index)  # Index([0, 2, 3], dtype='int64')

# 【错误写法】:触发 KeyError: 1,因为标签 1 已被删除
# print(filtered_df.loc[1])

# 【正确解决途径 A】:若按“在第几行”的位置获取,使用 .iloc
print(filtered_df.iloc[1])  # 获取当前实际排在第 2 位的元素(标签为 2,值为 20)

# 【正确解决途径 B】:若后续操作依赖连续数字标签,重置索引
reset_df = filtered_df.reset_index(drop=True)
print(reset_df.loc[1])      # 正常执行,返回重新排序后的第 2 个元素
3. 多列筛选列表书写遗漏外层方括号
从 DataFrame 中提取多列时,正确语法是传入一个列表,即双层方括号 df[['col1', 'col2']]。如果误写为 df['col1', 'col2'],Python 会将逗号解析为一个元组 ('col1', 'col2'),pandas 会尝试在列索引中查找名为该元组的单一列,最终抛出 KeyError: ('col1', 'col2')。
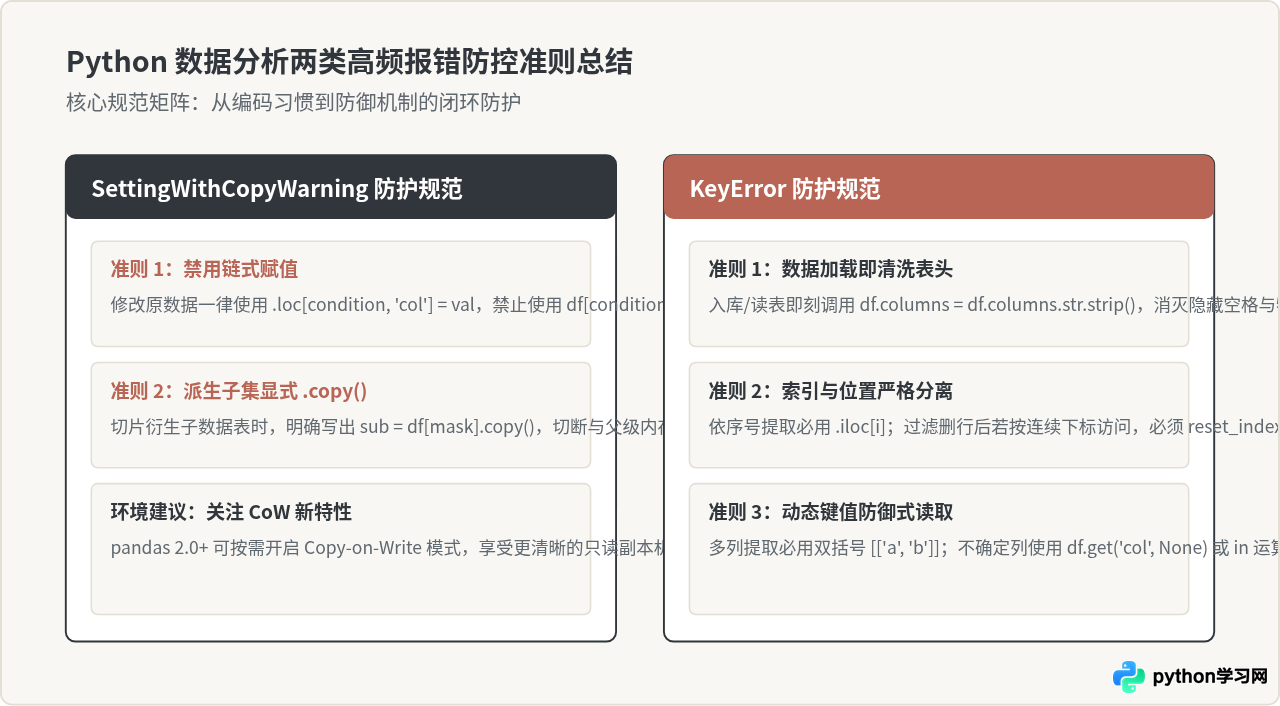
四、工程化防御规范与总结
要在日常数据分析与工程项目中彻底杜绝 SettingWithCopyWarning 和 KeyError,应将防御性编程融入到数据管道的标准流程中:
- 前置清洗标准化:在读取外部数据(CSV、Excel、SQL 查询)后,第一时间执行列名格式化处理,去除头尾空格,剔除特殊字符,避免后续业务代码中因不可见字符排查大量时间。
- 严格区分索引职责:坚持“标签用
.loc、位置用.iloc、条件修改必合并”的准则。绝不在赋值操作中使用多层方括号。 - 明确内存生命周期:凡是从主表中基于条件过滤派生出需要独立处理、增加计算列的中间数据表,在过滤语句末尾一律追加
.copy()。 - 键安全检查替代硬编码访问:在动态列或字典映射场景中,优先使用
df.get('col')或预先使用if col in df.columns:进行判断,为缺省字段提供兜底逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









