

Python difflib实现列名相似度模糊匹配
深入讲解如何使用Python标准库difflib模块实现数据表格列名的相似度模糊匹配与标准化对齐。包含SequenceMatcher算法原理、get_close_matches使用、阈值cutoff调优策略及完整的Pandas自动化清洗代码示例。
在日常数据清洗与 ETL 管道开发中,合并多源表格常会遇到字段名称不一致的难题。例如业务系统导出的表格中,客户姓名可能被命名为 cust_name、customer_name 或 client_name;用户编号可能呈现为 user_id、userid 或 user_id_num。手工编写逐个映射字典繁琐且难以应对新增异构源。利用 Python 标准库自带的 difflib 模块,无需引入 Levenshtein 或 RapidFuzz 等 C 编译扩展或重型第三方库,仅需数行代码即可高效构建列名相似度评分模型,实现异构字段自动识别与标准化重命名。
一、核心原理:difflib 的匹配机制与相似度计算
Python 内置的 difflib 提供了用于序列比对的高阶工具,其中最核心的类是 difflib.SequenceMatcher。它底层基于 Ratcliff-Obershelp 算法(又称最长公共子序列比对法),其核心思路是:在两段字符串中递归寻找最长的连续完全一致子串,记录匹配字符总数,最终依据序列总长度计算出介于 0.0 到 1.0 之间的相似度系数(ratio)。
相似度评分的数学公式为:
\[ ext{ratio} = rac{2 imes M}{|T_1| + |T_2|} \] 其中 \( |T_1| \) 与 \( |T_2| \) 分别代表待比对的两段列名字符串的总字符长度,\( M \) 代表两序列中所有匹配上的字符总数(即各最长匹配块长度之和)。当两字符串完全相同时值为 1.0,完全无关时为 0.0。
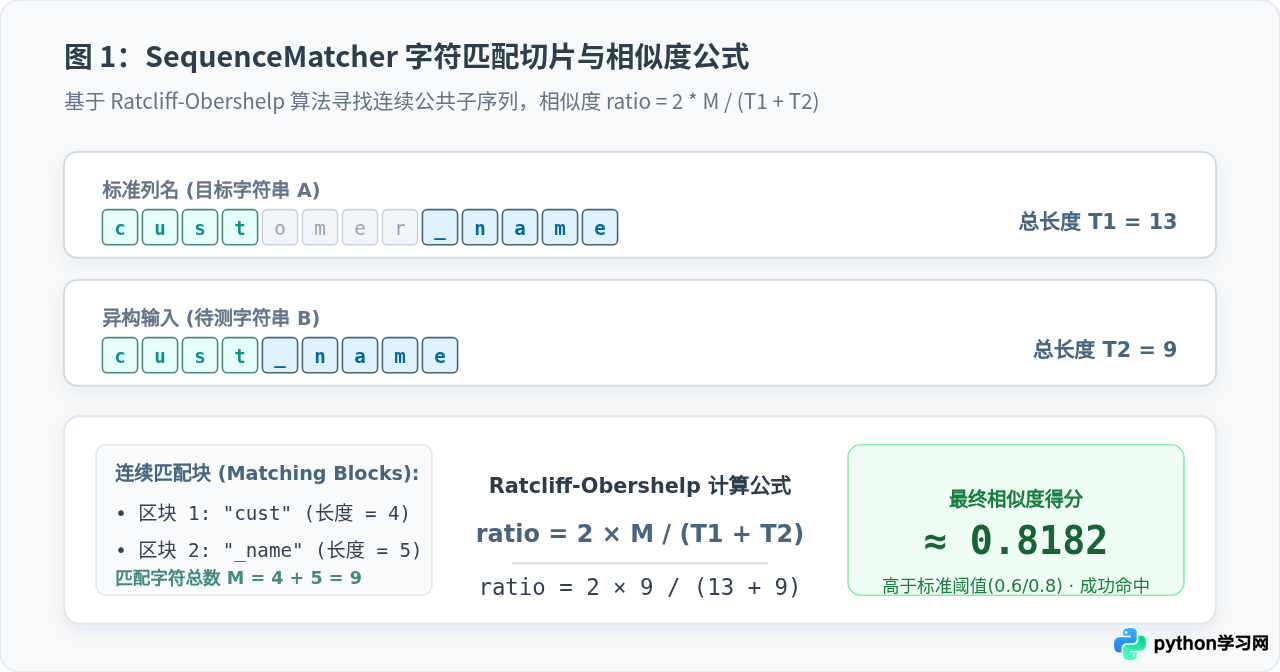
以目标标准列名 customer_name(长 13 字符)与异构输入 cust_name(长 9 字符)为例:算法首先识别出公共子串 cust(长 4),随后递归查找匹配到 _name(长 5),总匹配字符数 \( M = 4 + 5 = 9 \)。代入公式计算得到相似度得分:
\[ ext{ratio} = rac{2 imes 9}{13 + 9} = rac{18}{22} pprox 0.8182 \]
该分值显著超过了常规阈值,能够被可靠识别并归一化为标准列名。
二、快速上手:SequenceMatcher 与 get_close_matches
在实际编码中,difflib 提供了两种常用层级的 API:底层的 SequenceMatcher 用于一对一细粒度打分;高层的 get_close_matches 则直接支持在一组候选列表中检索最接近的匹配项。
1. 一对一相似度精确打分
使用 SequenceMatcher(isjunk, a, b) 可以计算两列名间的数值相似度,代码如下:
from difflib import SequenceMatcher

def calc_column_similarity(col_a: str, col_b: str) -> float:
    """计算两个列名之间的相似度比率 (0.0 ~ 1.0)"""
    return SequenceMatcher(None, col_a.strip().lower(), col_b.strip().lower()).ratio()

# 示例测试
score_1 = calc_column_similarity("cust_name", "customer_name")
score_2 = calc_column_similarity("user_id", "userid")
score_3 = calc_column_similarity("order_date", "total_amount")

print(f"cust_name vs customer_name: {score_1:.4f}")   # 输出约 0.8182
print(f"user_id vs userid:           {score_2:.4f}")   # 输出约 0.9231
print(f"order_date vs total_amount:  {score_3:.4f}")   # 输出约 0.2727
2. 使用 get_close_matches 快速查找最佳候选
get_close_matches(word, possibilities, n=3, cutoff=0.6) 是最常用的便捷函数:
word:待匹配的输入列名;possibilities:标准规范列名列表(候选池);n:最多返回的相似项数量(通常设为 1,即只取最相似的一个);cutoff:相似度截断阈值,只有相似度得分大于或等于该数值的项才会被返回,默认值为 0.6。
from difflib import get_close_matches

standard_cols = ["user_id", "customer_name", "order_date", "total_amount", "phone_number"]

incoming_cols = ["cust_name", "userid", "order_dt", "tot_amount", "unknown_field"]

for col in incoming_cols:
    matches = get_close_matches(col, standard_cols, n=1, cutoff=0.6)
    matched_target = matches[0] if matches else None
    print(f"原始列: {col:<15} -> 匹配标准列: {matched_target}")

# 示例输出:
# 原始列: cust_name       -> 匹配标准列: customer_name
# 原始列: userid          -> 匹配标准列: user_id
# 原始列: order_dt        -> 匹配标准列: order_date
# 原始列: tot_amount      -> 匹配标准列: total_amount
# 原始列: unknown_field   -> 匹配标准列: None
三、规范实施:列名模糊匹配的标准处理流程
在生产级批量数据处理中,不能仅靠单一的字符串直接比对,必须遵循清晰的工程流水线,以避免因大小写、空格噪音或重复映射导致的数据失真。
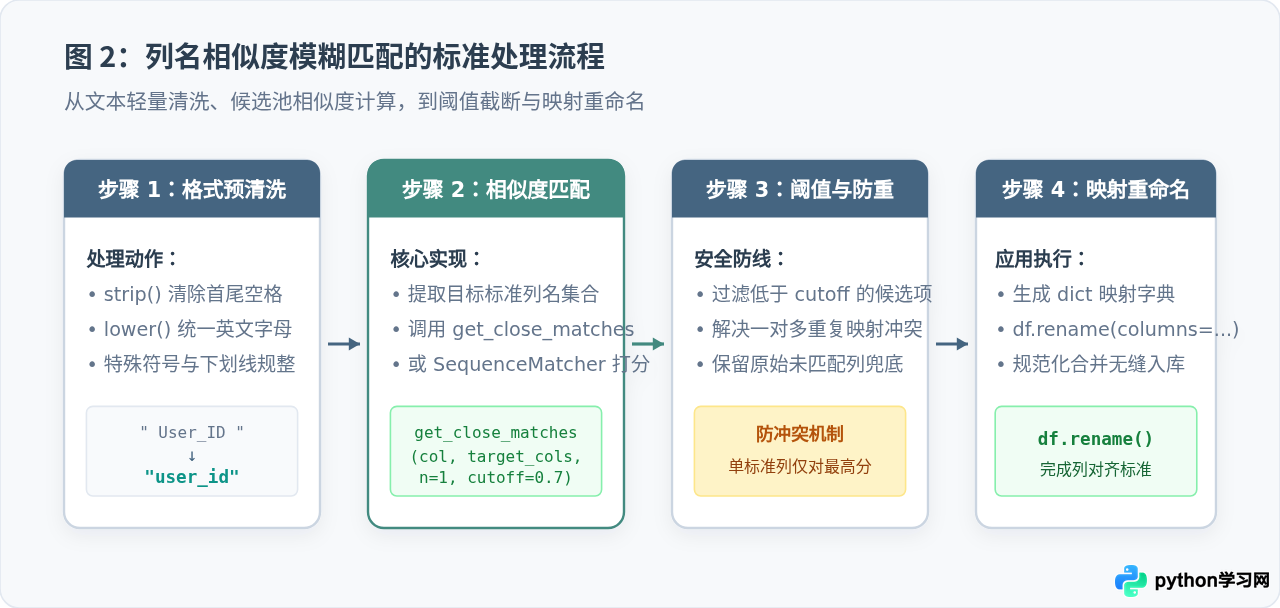
- 格式预清洗:首先执行
strip()清除多余空格,统一转为小写字母lower(),并将连字符-统一替换为下划线_,最大程度消除低级字符噪音。 - 候选池评分:针对预处理后的列名,遍历标准列定义池,调用
SequenceMatcher计算得分,选出相似度最高的目标列。 - 阈值截断与防重机制:对低于置信度阈值(例如 0.70)的候选予以丢弃,避免强行匹配无关列;同时记录已分配的标准列,若两个原始列同时匹配同一标准列,仅保留得分更高的一方,另一方标记待人工审查。
- 生成映射字典:整理为形如
{'cust_name': 'customer_name'}的字典对象,输入df.rename(columns=...)执行一键重命名。
四、关键参数控制:Cutoff 阈值选择与防错矩阵
cutoff 参数直接决定了匹配的严格程度。过低会导致将无关列误认(假阳性),过高则会导致合理的拼写差异被忽略(假阴性)。
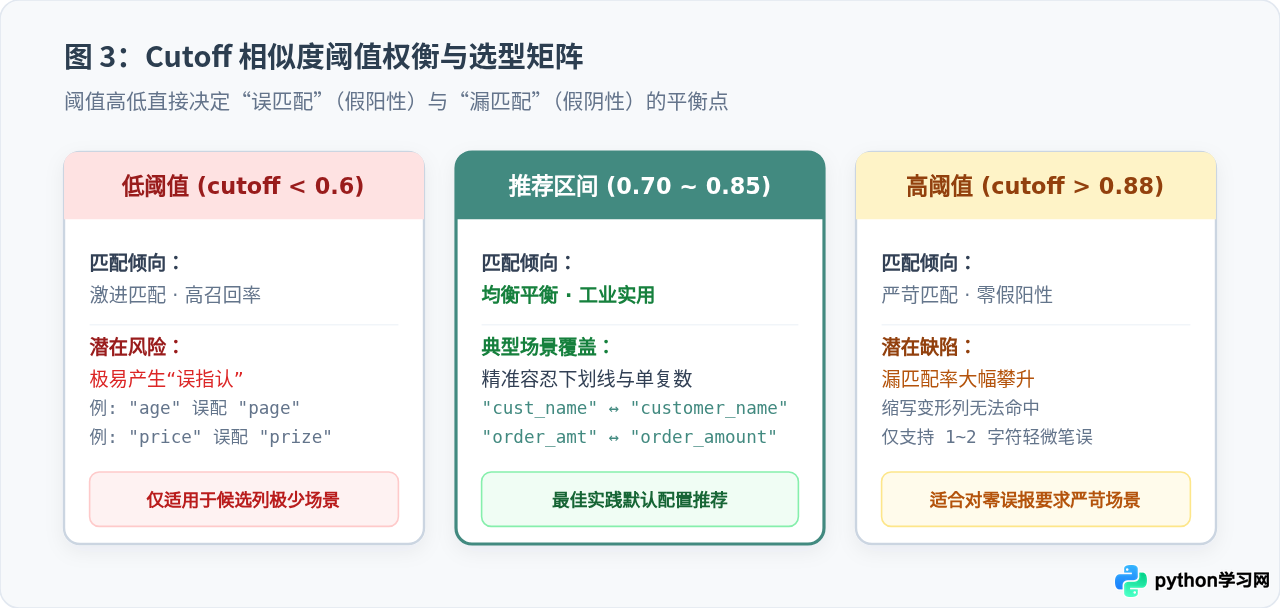
| Cutoff 取值区间 | 匹配特性 | 典型命中示例 | 常见误配风险 | 适用建议 |
|---|---|---|---|---|
< 0.60 (宽松) |
召回率极高,容忍大面积变形 | amt 匹配 total_amount |
page 误配为 age,cost 误配为 post |
仅用于列名数量极少且语义差异显著的特殊场景 |
0.70 ~ 0.85 (推荐) |
精准度与召回率平衡 | cust_name 匹配 customer_name |
极低,多数语义冲突列被自然隔离 | 生产通用默认推荐区间 |
> 0.88 (严格) |
极度保守,近乎完全匹配 | user_id 匹配 userid |
缩写缩短词(如 dt、amt)被直接漏掉 |
仅适用于严格防笔误、严禁任何误认的场景 |
如果原始表格中同时存在
cust_name 与 customer_nickname,它们可能同时与标准列 customer_name 产生较高相似度。工程代码中必须维护一个占用集合(assigned_targets),确保每个标准列只被置信度最高的唯一列占用。
五、完整实战:Pandas 多源表格自动化对齐合并
下面是一个工业实用的完整 Python 脚本。该脚本创建了两份具有不同列名风格的模拟数据表,通过 difflib 构建映射管道,全自动完成列名对齐并无缝合并为统一规范的 DataFrame。
import pandas as pd
from difflib import SequenceMatcher
from typing import Dict, List, Tuple

def build_column_mapping(
    actual_columns: List[str],
    target_columns: List[str],
    cutoff: float = 0.70
) -> Tuple[Dict[str, str], List[str]]:
    """
    基于 difflib 构建列名模糊匹配字典

    参数:
        actual_columns: 原始数据表的实际列名列表
        target_columns: 预期对齐的标准列名列表
        cutoff: 相似度截断阈值,默认 0.70

    返回:
        (mapping_dict, unmatched_columns)
        mapping_dict: 用于 df.rename 的映射字典 {原始列名: 标准列名}
        unmatched_columns: 未能成功匹配的原始列名列表(用于审计与报警)
    """
    mapping: Dict[str, str] = {}
    assigned_targets = set()
    unmatched: List[str] = []

    # 预先记录小写标准化列名
    clean_target_map = {col.strip().lower(): col for col in target_columns}
    clean_targets = list(clean_target_map.keys())

    # 按相似度高低进行贪心匹配
    for orig_col in actual_columns:
        clean_orig = orig_col.strip().lower().replace("-", "_")

        # 1. 优先完全一致匹配
        if clean_orig in clean_target_map:
            std_col = clean_target_map[clean_orig]
            mapping[orig_col] = std_col
            assigned_targets.add(std_col)
            continue

        # 2. 模糊匹配打分
        best_match = None
        highest_score = 0.0

        for tgt in clean_targets:
            score = SequenceMatcher(None, clean_orig, tgt).ratio()
            if score > highest_score:
                highest_score = score
                best_match = tgt

        # 3. 阈值判断与防重保护
        if highest_score >= cutoff and best_match is not None:
            std_col = clean_target_map[best_match]
            if std_col not in assigned_targets:
                mapping[orig_col] = std_col
                assigned_targets.add(std_col)
            else:
                # 冲突发生,暂记入未分配并输出警告
                print(f"[警告] 列名冲突: '{orig_col}' 匹配到已分配的标准列 '{std_col}' (分值: {highest_score:.3f})")
                unmatched.append(orig_col)
        else:
            unmatched.append(orig_col)

    return mapping, unmatched


# ==================== 场景模拟与运行验证 ====================

if __name__ == "__main__":
    # 统一的标准字段规范 Schema
    TARGET_COLUMNS = ["user_id", "customer_name", "order_date", "total_amount", "contact_phone"]

    # 模拟数据源 A(某分公司导出的异构表格)
    df_branch_a = pd.DataFrame([
        {"userid": "U1001", "cust_name": "张三", "order_dt": "2026-03-01", "tot_amount": 350.5, "phone": "13800000001"},
        {"userid": "U1002", "cust_name": "李四", "order_dt": "2026-03-02", "tot_amount": 120.0, "phone": "13800000002"},
    ])

    # 模拟数据源 B(第三方合作商提供的表格,存在中划线和大写)
    df_branch_b = pd.DataFrame([
        {"User-ID": "U2001", "Customer_Name": "王五", "Order_Date": "2026-03-03", "Total_Amount": 890.0, "ext_memo": "加急"},
    ])

    print("--- 原始数据源 A 列名 ---")
    print(list(df_branch_a.columns))

    # 执行模糊映射计算
    mapping_a, unmatched_a = build_column_mapping(list(df_branch_a.columns), TARGET_COLUMNS, cutoff=0.72)
    print("\n数据源 A 生成的重命名映射字典:")
    print(mapping_a)
    print(f"数据源 A 未识别字段: {unmatched_a}")

    # 执行重命名
    df_a_cleaned = df_branch_a.rename(columns=mapping_a)

    # 对数据源 B 执行相同处理
    mapping_b, unmatched_b = build_column_mapping(list(df_branch_b.columns), TARGET_COLUMNS, cutoff=0.72)
    print("\n数据源 B 生成的重命名映射字典:")
    print(mapping_b)
    print(f"数据源 B 未识别字段: {unmatched_b} (如额外业务字段保留或存入扩展字段)")

    df_b_cleaned = df_branch_b.rename(columns=mapping_b)

    # 最终合并
    unified_df = pd.concat([df_a_cleaned, df_b_cleaned], ignore_index=True)

    print("\n--- 最终自动化对齐合并后的统一表格 ---")
print(unified_df[["user_id", "customer_name", "order_date", "total_amount"]])--- 原始数据源 A 列名 ---
['userid', 'cust_name', 'order_dt', 'tot_amount', 'phone']
数据源 A 生成的重命名映射字典:
{'userid': 'user_id', 'cust_name': 'customer_name', 'order_dt': 'order_date', 'tot_amount': 'total_amount'}
数据源 A 未识别字段: ['phone']
数据源 B 生成的重命名映射字典:
{'User-ID': 'user_id', 'Customer_Name': 'customer_name', 'Order_Date': 'order_date', 'Total_Amount': 'total_amount'}
数据源 B 未识别字段: ['ext_memo'] (如额外业务字段保留或存入扩展字段)
--- 最终自动化对齐合并后的统一表格 ---
user_id customer_name order_date total_amount
0 U1001 张三 2026-03-01 350.5
1 U1002 李四 2026-03-02 120.0
2 U2001 王五 2026-03-03 890.0六、进阶技巧与局限性认知
difflib 是轻量级标准库工具,掌握以下技巧能进一步提升其实战稳定性,同时也需理性认识其适用边界:
1. 词序无关匹配优化(Token 预排序)
difflib 对字符序列的先后顺序高度敏感。例如对于 order_status 和 status_order,因词序倒置,两者的直接相似度仅约 0.45,会低于默认阈值。若存在大量倒序命名的列名,可在比对前将以下划线分割的单词进行字典序重排:
def sort_tokens(col_name: str) -> str:
    """消除词序颠倒影响:例如 'order_status' -> 'order_status','status_order' -> 'order_status'"""
    parts = col_name.strip().lower().replace("-", "_").split("_")
    return "_".join(sorted(filter(None, parts)))

# 测试
col_x = sort_tokens("order_status")  # 'order_status'
col_y = sort_tokens("status_order")  # 'order_status'
print(SequenceMatcher(None, col_x, col_y).ratio()) # 输出 1.0 完全匹配!
2. difflib 与编辑距离方案的选型对比
- difflib 的核心优势:Python 原生内置,跨平台开箱即用,无需编译 C/C++ 依赖,非常适合轻量运维脚本、Serverless 容器函数及离线交付项目。
- 何时考虑升级三方库:若每秒需要对数十万个复杂文本列名进行高频比对,或面对极端严重的拼写错位与缩写截断,使用基于 C++ 实现的
RapidFuzz或结合编辑距离(Levenshtein Distance)与拼音/分词的专业库会更合适。
七、方案落地架构总结
综上所述,借助 difflib 可以在不增加项目依赖复杂度的前提下,构建一条轻盈、高健壮性的列名模糊匹配管道。
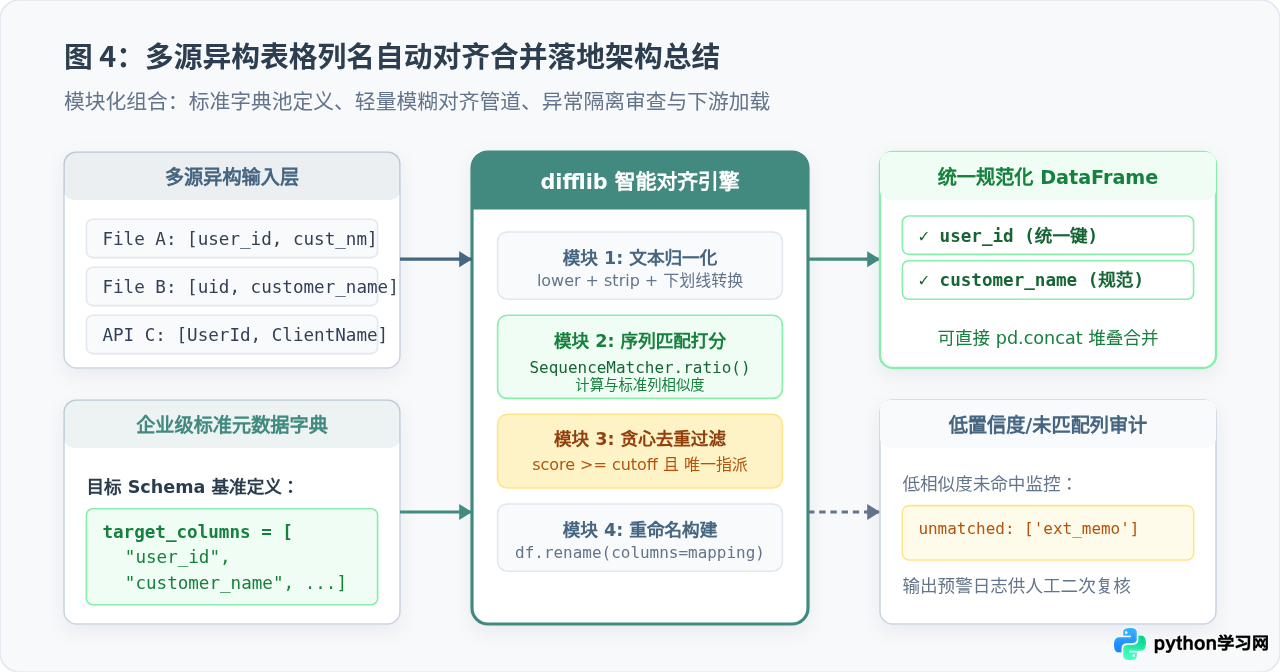
在工程落地上,建议始终遵循 “规范先行、清洗辅助、阈值控制、日志兜底” 的四步策略:优先建立好统一的标准列名池,在清洗阶段平滑大小写和分隔符,使用 0.70 ~ 0.85 的黄金阈值截断,最后将未匹配成功的列与冲突项输出至审计日志供人工复核。通过该流程,能够以极低的代码成本解决 95% 以上的表格列名异构对齐问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









