

Python常用内置函数指南:按字符串、列表与字典操作场景分类
针对Python中最常用的字符串、列表与字典三大数据结构,按实际开发场景分类讲解核心内置函数的使用方法、底层协议机制、与类型方法的差异辨析及常见避坑指南。
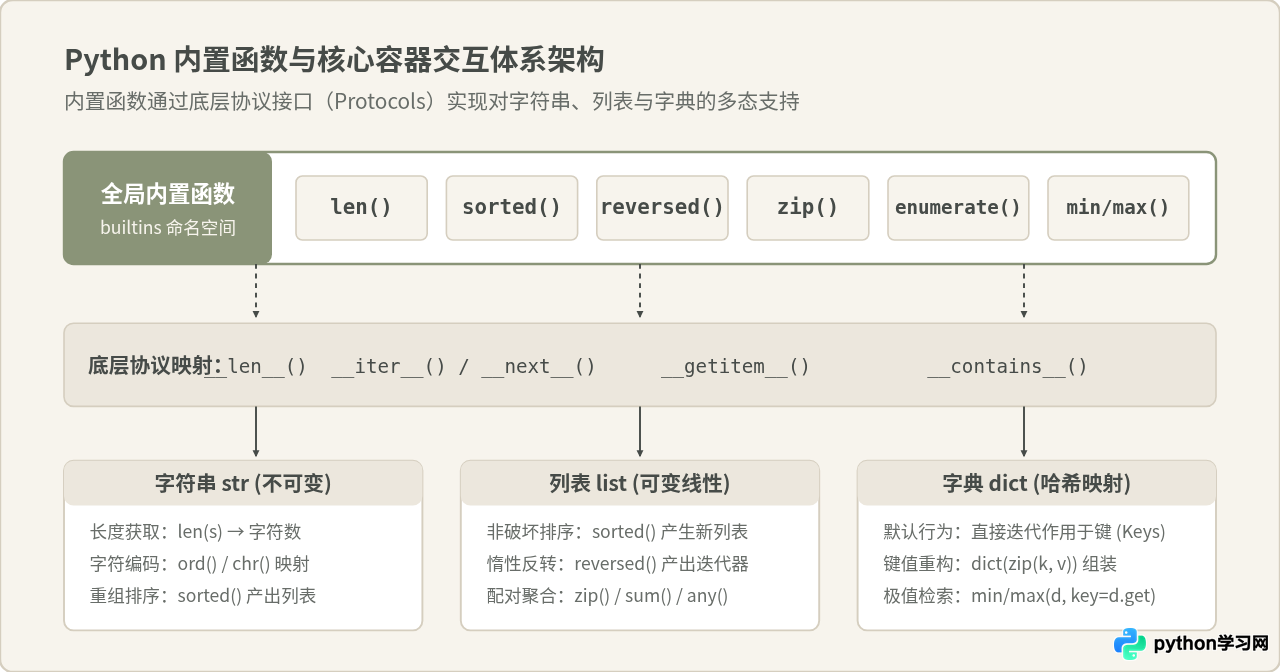
一、核心概念辨析:内置函数与对象方法的边界与机制
在初学与进阶 Python 的过程中,许多人常将“内置函数”与“对象方法”混淆。例如:有人习惯将 str.split() 称为内置函数,或者对“为什么求长度要写 len(obj) 而不是 obj.len()”感到困惑。明确两者的职责边界,是写出地道 Python 代码的前提。
1. 命名空间与查找路径:内置函数存放在全局命名空间的 builtins 模块中,解析器在启动时便已完成加载。无论在函数内部还是模块顶层,任何未加前缀的合法标识符查找(LEGB 规则)最终都会落入该命名空间。而对象方法(如 list.append() 或 str.strip())绑定在特定的类型类(Type Class)上,必须由该类型的实例发起调用。
2. 底层协议(Protocols)与多态性:Python 采用全局函数结合底层特殊方法(Dunder Methods)的设计范式。当你调用 len(x) 时,Python 实际上执行的是 x.__len__();调用 sorted(x) 时,它依靠的是 x.__iter__() 协议。这种设计的核心优势在于多态一致性:无论传入的是不可变的字符串、可变的列表,还是键值映射的字典,同一内置函数都能按照标准协议完成工作,而无需每种类型各自发明一套不统一的接口名。
3. 副作用与返回值差异:内置函数大多遵循“函数式编程”特征,倾向于接收不可变或可变容器作为入参,经过计算后返回全新结果或惰性迭代器,不修改原对象。与之相对,部分容器方法(如 list.sort() 和 list.reverse())设计为原地修改(In-place Modification),直接改变原有内存块中的顺序并返回 None。
二、字符串常用操作场景与内置函数
字符串(str)在 Python 中是不可变(Immutable)的字符序列。针对字符串的操作,内置函数主要集中在维度测量、字符编码映射、形式化转换以及序列的非破坏性重组。
1. 长度度量与字符编码映射(len, ord, chr)
测量字符串的字符数直接使用 len()。需要注意的是,Python 3 的字符串原生采用 Unicode 编码,len("Python代码") 得到的数值是 8(字符数),而非底层的字节数。
在需要进行加密混淆、协议封包或校验字符范围时,ord() 与 chr() 是一对互逆的核心函数:ord(c) 接收单个字符并返回其 Unicode 码位数值(整数),chr(i) 则将整数码位反向转换为对应的字符。
# 长度与编码转换示例
text = "Python"
print(len(text))              # 示例输出: 6

char_code = ord('A')          # 得到 ASCII / Unicode 码位 65
recovered_char = chr(65)      # 反向恢复为字符 'A'
print(char_code, recovered_char) # 示例输出: 65 A
2. 安全呈现与格式化表达(str, repr, ascii, format)
将任意数据转换为可读字符串时使用 str(),而 repr() 则专用于生成供解释器解析或开发调试的“官方表达形式”。在处理含有非 ASCII 字符、控制字符(如
、 )或二进制数据流时,repr() 和 ascii() 能够将不可见字符转义输出,避免终端输出歧义。
raw_input = "Line1
Line2	中文"
print(str(raw_input))         # 直观换行与制表展现
print(repr(raw_input))        # 示例输出: 'Line1\nLine2\t中文'(保留转义符)
print(ascii(raw_input))       # 示例输出: 'Line1\nLine2\t\u4e2d\u6587'
3. 字符序列的非破坏性排序与逆序(sorted, reversed)
由于字符串是不可变序列,任何试图调用 s.sort() 或 s.reverse() 的尝试都会抛出 AttributeError。此时必须使用内置函数:
sorted(s):将字符串拆解为单字符序列并完成排序,返回由排好序的单字符构成的列表。若需恢复为字符串,需配合"".join()。reversed(s):返回一个反向迭代器(reverseiterator),属于惰性计算,不会立即分配内存,适合直接用于for循环或通过"".join()重建倒序字符串。
word = "algorithm"

# 排序:生成有序字符列表再接合
sorted_chars = sorted(word)
sorted_str = "".join(sorted_chars)
print(sorted_str)             # 示例输出: "aghilmort"

# 逆序:通过 reversed 迭代器接合
reversed_str = "".join(reversed(word))
print(reversed_str)           # 示例输出: "mihtrogla"
很多开发者习惯用切片 s[::-1] 反转字符串。这种做法在代码长度上确实最为简练,且在 CPython 底层执行迅速,直接返回新字符串;而 reversed(s) 的价值在于提供标准迭代器协议,当字符串非常长且仅用于流式单次比对时,reversed(s) 无需预先在内存中构建完整反转串。两者在不同场景下各有优势。
三、列表常用操作场景与内置函数
列表(list)作为可变且有序的线性序列,是 Python 数据处理中使用最频繁的容器。内置函数在列表场景中主要承担顺序控制、索引同步、多维配对、聚合统计与条件筛选任务。
1. 排序与反转的选用决策:sorted() vs list.sort()
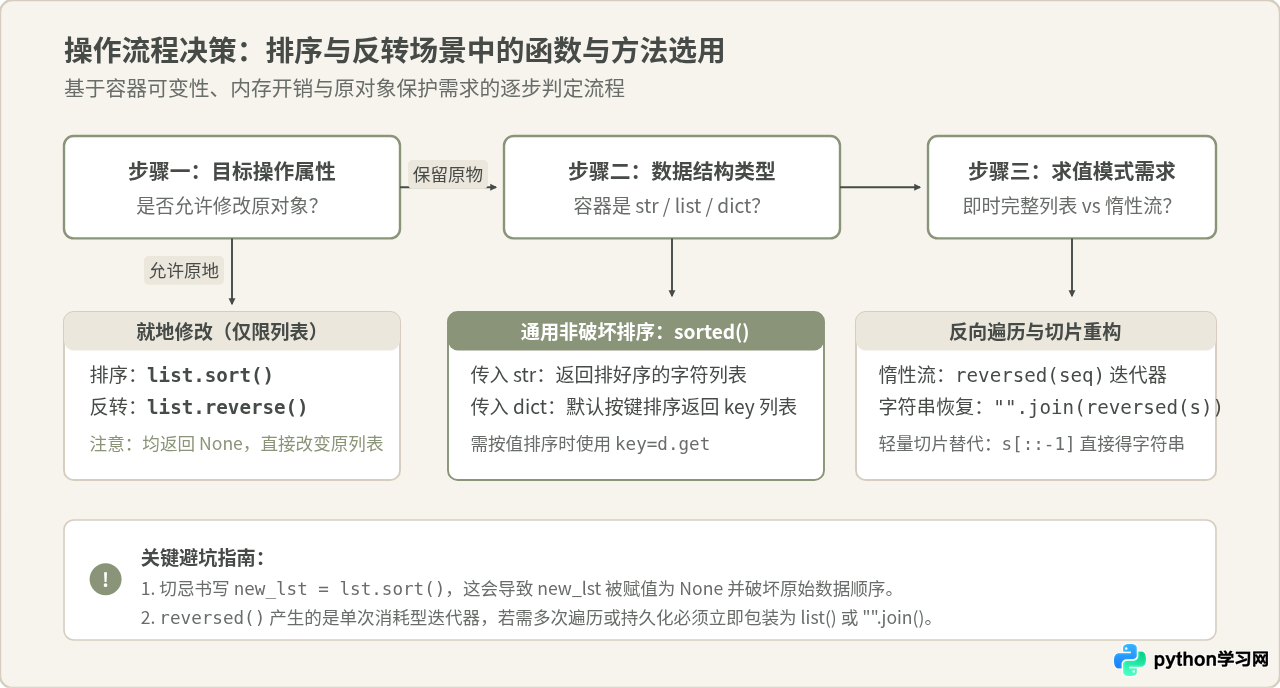
处理列表时最容易犯的错误之一是:new_list = old_list.sort()。由于 list.sort() 是原地操作,其返回值为 None,这会导致新变量丢失数据,原列表顺序也被打乱。
正确的选用原则:
- 如果允许且希望修改原列表,为了节省内存与提高性能,使用
list.sort()和list.reverse()。 - 如果必须保留原始列表的顺序,或者传入的数据源是元组、生成器等非列表类型,必须使用内置函数
sorted()和reversed()。
scores = [88, 62, 95, 74]

# 非破坏性排序:生成全新排好序的列表
asc_scores = sorted(scores)
desc_scores = sorted(scores, reverse=True)
print(asc_scores)             # 示例输出: [62, 74, 88, 95]
print(scores)                 # 示例输出: [88, 62, 95, 74] (原数据未被修改)

# 原地修改列表
scores.sort()
print(scores)                 # 示例输出: [62, 74, 88, 95] (原列表被修改)
2. 索引同步追踪与多序列并行配对(enumerate, zip)
在遍历列表元素的同时需要使用其下标序号时,切勿通过 range(len(lst)) 手动索引,也不要定义外部 index += 1 计数器。使用 enumerate() 可以直接产生 (index, item) 元组,且允许通过 start 参数灵活指定起始编号。
当需要同时遍历两个或多个等长序列时,zip() 能将各个序列同一位置的元素打包成元组。在 Python 3.10 及以上版本中,如果预期各列表长度完全相等,可开启 strict=True 参数,长度不一致时会主动抛出 ValueError,极大减少静默截断 Bug。
tasks = ["拉取日志", "清洗数据", "生成报告"]
durations = [12, 45, 8]

# 1. 编号遍历:start 参数从 1 开始计步
for step, name in enumerate(tasks, start=1):
    print(f"步骤 {step}: {name}")

# 2. 并行合并遍历
for name, cost in zip(tasks, durations):
    print(f"任务: {name}, 耗时: {cost}s")
3. 数值聚合统计与状态短路判定(sum, min, max, all, any)
对数值型列表执行常规统计时,sum()、min()、max() 是最为紧凑高效的内置函数。sum(iterable, start=0) 接受起始累加值;min() 与 max() 支持传入 key=callable 进行投影比较,并可通过 default=value 防止空列表引发 ValueError。
在业务逻辑判定中,all() 与 any() 配合生成器表达式能实现优雅的短路求值(Short-circuit Evaluation):
all(iterable):所有元素为真时返回True;一旦遭遇假值立即终止计算返回False。any(iterable):只要有一个元素为真即返回True;一旦捕获真值立即终止后续迭代。
latencies = [120, 95, 310, 88]

print(sum(latencies))                    # 示例输出: 613
print(min(latencies), max(latencies))    # 示例输出: 88 310

# 业务判定:是否所有请求均低于 500ms?
all_healthy = all(x < 500 for x in latencies)  # 示例输出: True

# 业务判定:是否存在超时警报(> 300ms)?
has_warning = any(x > 300 for x in latencies)  # 示例输出: True
四、字典常用操作场景与内置函数
字典(dict)是基于哈希表实现的键值映射容器。由于字典同时包含“键(Keys)”、“值(Values)”与“键值对(Items)”三种视图维度,内置函数作用于字典时呈现出特定的行为规则。
1. 字典的构建与快速映射(dict, zip)
在从数据库字段、配置文件或 CSV 表头恢复结构化数据时,常常面对两个分离的列表:一个存储键名,另一个存储对应的属性值。使用 dict(zip(keys, values)) 是一步将平行序列转换为标准字典的最地道写法。
headers = ["host", "port", "timeout"]
configs = ["127.0.0.1", 8080, 30]

# 跨容器一步组装字典
server_info = dict(zip(headers, configs))
print(server_info)
# 示例输出: {'host': '127.0.0.1', 'port': 8080, 'timeout': 30}
2. 键、值、项多维度的排序与极值获取(len, sorted, min, max)
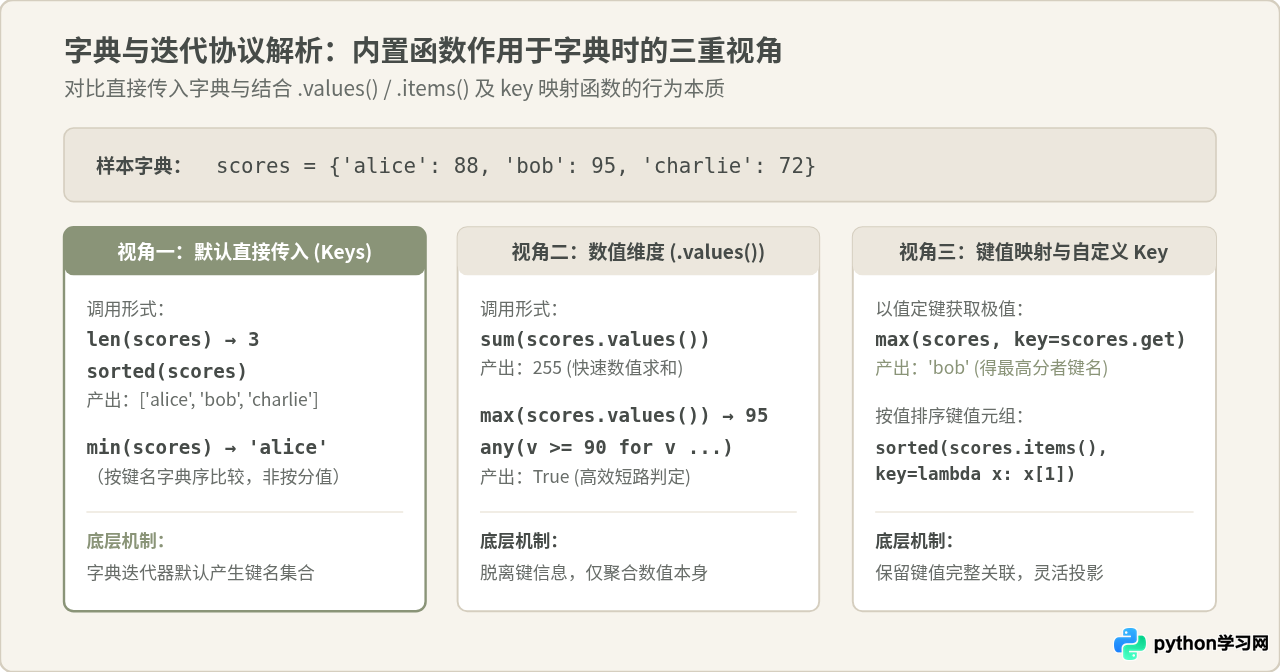
核心规则:当直接将字典对象传入 len()、sorted()、min()、max() 时,由于字典默认的迭代协议(__iter__)产生的是键名集合,这些函数默认只处理键:
len(d):返回字典中键的总数(在 CPython 中时间复杂度为严格的 $O(1)$)。sorted(d):默认按键名字典序排序,返回排好序的键名列表。min(d)/max(d):默认按键名字母序比较,返回最小/最大的键。
若需要依据字典的“值”进行极值查找或排序,必须显式结合映射逻辑:
sales = {"A": 140, "B": 320, "C": 210}

# 1. 直接操作:仅比对键名
print(max(sales))                      # 示例输出: 'C' (按字母序最大键)

# 2. 依据值寻找对应的“最佳键名”:传入 key=sales.get
top_product = max(sales, key=sales.get)
print(top_product)                     # 示例输出: 'B' (销售额最高的产品)

# 3. 按值对字典项排序:操作 .items() 视图
sorted_items = sorted(sales.items(), key=lambda kv: kv[1], reverse=True)
print(sorted_items)
# 示例输出: [('B', 320), ('C', 210), ('A', 140)]

# 4. 对所有值求和:显式指定 .values()
total_amount = sum(sales.values())
print(total_amount)                    # 示例输出: 670
五、跨容器场景协同与高频复合用法
真实业务场景往往并非单一数据结构孤立运行,而是涉及字符串切分、列表收集、元组打包再沉淀到字典的连续数据管道。
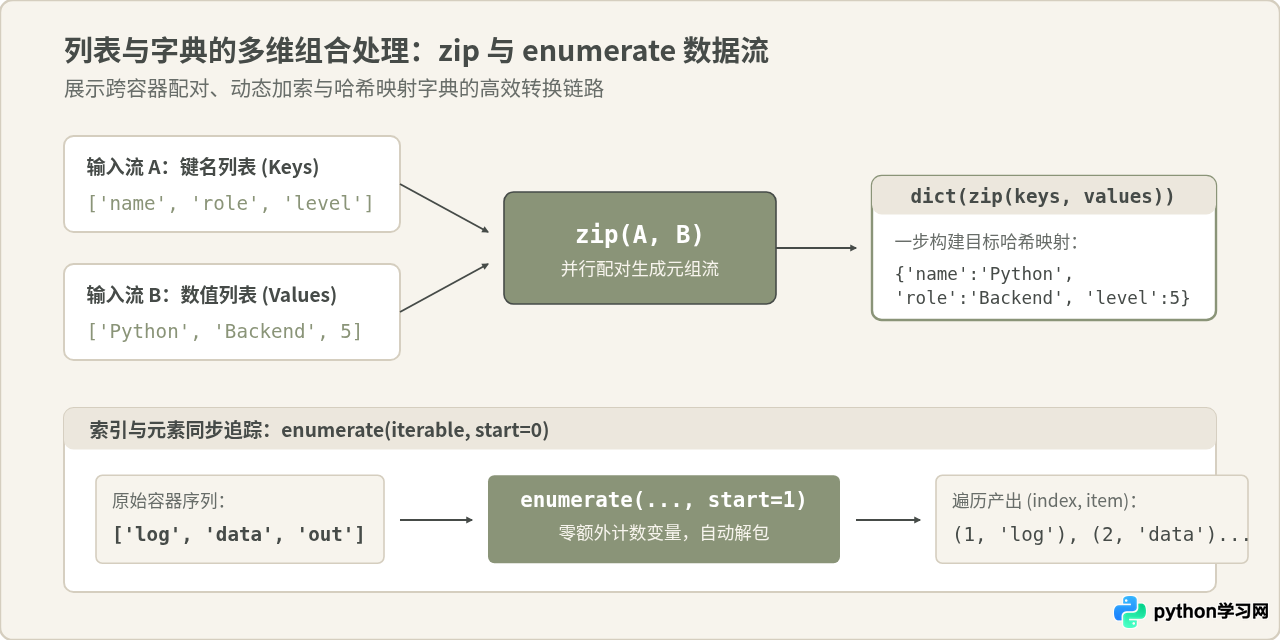
1. 属性清洗与多源数据字典映射
当读取文本配置行(字符串)并与预设字段列表结合时,结合 str.split()、map() 与 zip() 可以构建极具表现力的数据处理流水线:
header = ["id", "title", "read_count"]
raw_row = "101,PythonGuide,4500"

# 拆分原始字符流,并将数值字段通过 int 处理
tokens = raw_row.split(",")
record = dict(zip(header, [int(tokens[0]), tokens[1], int(tokens[2])]))
print(record)
# 示例输出: {'id': 101, 'title': 'PythonGuide', 'read_count': 4500}
2. 带序号的格式化报表输出
在输出已排序的字典项时,同时结合 enumerate() 与 sorted() 能在一行循环中完成排名注入与键值解包,无需维护额外的自增变量:
rankings = {"Python": 28.4, "C++": 12.1, "Java": 14.6}

# 排序字典项并在遍历时注入序号
for rank, (lang, share) in enumerate(sorted(rankings.items(), key=lambda x: x[1], reverse=True), start=1):
    print(f"TOP {rank}: {lang:<8} 份额: {share}%")
# 示例输出:
# TOP 1: Python   份额: 28.4%
# TOP 2: Java     份额: 14.6%
# TOP 3: C++      份额: 12.1%
六、常用内置函数场景速查与总结
为了在实际编写代码时快速定位最适合当前场景的函数,下表总结了本文涉及的全部常用内置函数在三种数据结构中的行为特性与约束条件:
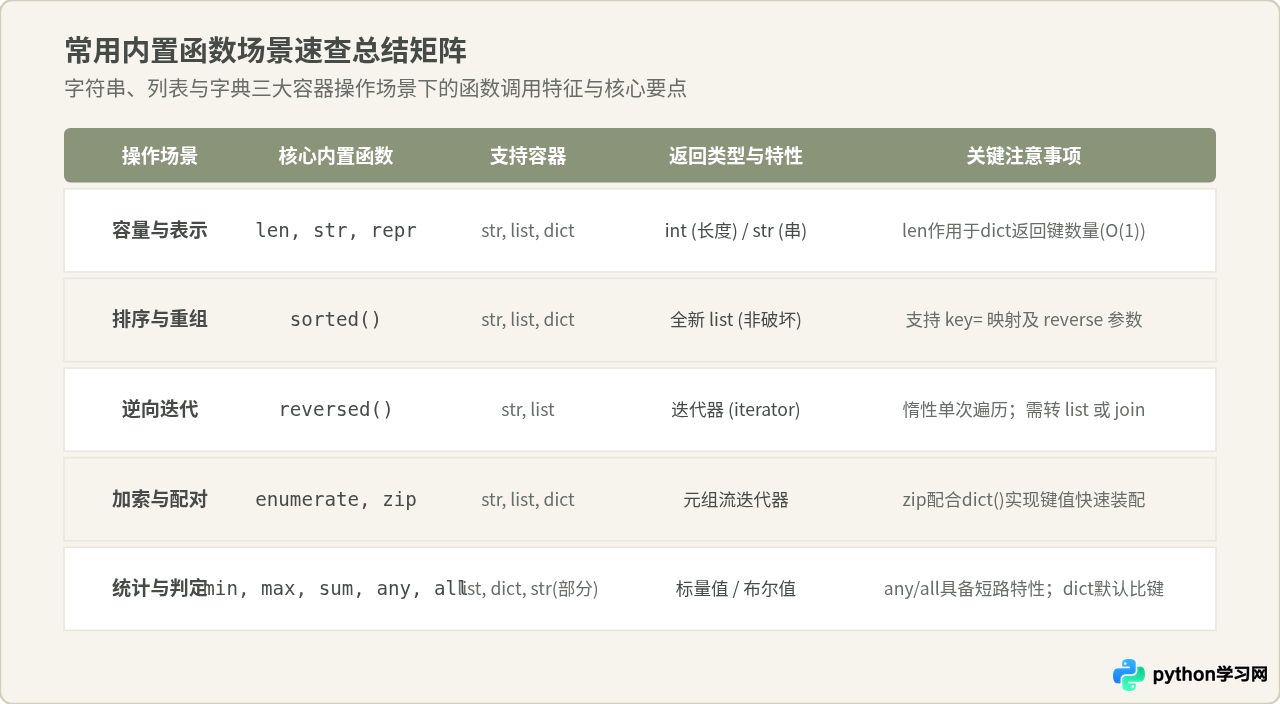
| 分类场景 | 推荐内置函数 | 主要适用对象 | 返回值特征 | 核心设计优势与注意事项 |
|---|---|---|---|---|
| 容量与基数 | len() |
str, list, dict | int(元素个数) | 字典返回键数量;时间复杂度 O(1);不可传入生成器 |
| 安全表示 | repr(), ascii() |
所有数据类型 | str(带转义) | 消除不可见字符歧义,便于开发调试排查与日志留存 |
| 非破坏排序 | sorted() |
str, list, dict | 全新 list | 保持原对象不受影响;支持 key 投射函数与 reverse 开关 |
| 惰性逆序 | reversed() |
str, list, tuple | 迭代器 | 按需生成省内存;单次消费;如需复用需用 list() 固化 |
| 带索遍历 | enumerate() |
可迭代对象 | (index, item) 迭代器 | 消除手工维护序号;支持 start 起始参数自定义 |
| 并行打包 | zip() |
多个可迭代对象 | 元组迭代器 | 配合 dict() 快速组装字典;3.10+ 可开启 strict=True 校验 |
| 聚合汇总 | sum(), min(), max() |
数值列表 / dict.values() | 对应标量数值 | 字典直接传入只比对键名,如需以值定键使用 key=dict.get |
| 状态短路断言 | any(), all() |
布尔可迭代序列 | bool(True/False) | 配合生成器表达式时具备短路特性,避免无谓计算 |
Python 的内置函数设计遵循“少即是多”与“通用多态”的设计哲学。掌握它们的关键在于:第一,分清内置函数(跨类型协议抽象)与实例方法(类型内部就地逻辑)的差异;第二,牢记字典在默认迭代时仅暴露键(Keys)的底层特征;第三,善用 enumerate 与 zip 替代多余的下标计算。在合适的场景选用恰当的内置工具,既能显著精简代码行数,也能从根本上规避边界空指针与状态篡改问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









