

编写同时兼容Python 2和Python 3的代码技巧
深入讲解编写同时兼容Python 2与Python 3的实用工程技巧,包含__future__导入基线、文本与二进制边界处理、标准库垫片重组、迭代与面向对象协议对齐及自动化测试矩阵配置。
__future__ 导入和抽象垫片在 Python 2 下运行”。实现双版本兼容并不是在业务逻辑中到处填充 sys.version_info 分支,而是通过固化顶层语法基线、清晰划分字符串与二进制边界、重组标准库模块映射,以及对齐容器迭代与类协议。遵循这些技巧,可以使同一套代码无修改地在 Python 2.7 与现代 Python 3 环境中稳定运行。
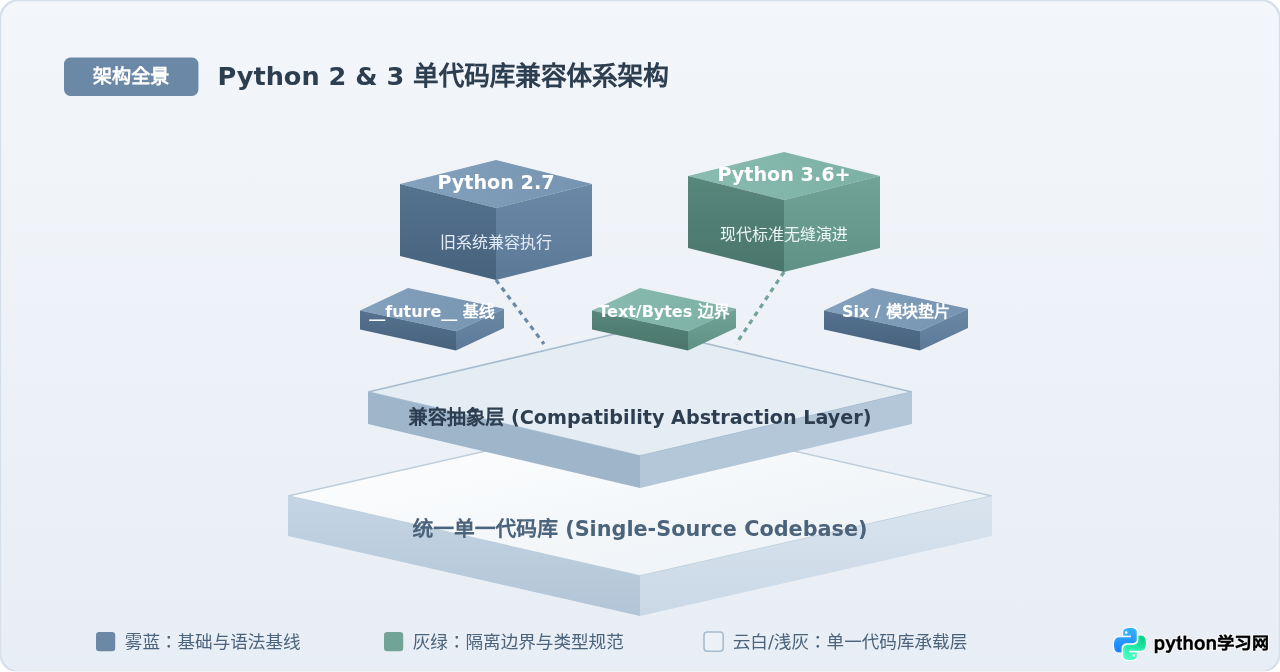
一、导入 __future__ 特性——固化语法与运行行为基线
Python 2.7 提供了多种由 __future__ 模块反向移植的 Python 3 语法与行为特性。编写兼容代码的第一步,是在每个 Python 源文件的最顶层统一引入这些未来特性。这样做能够从语法解析层消除两代解释器最基础的语义冲突。
from __future__ import absolute_import
from __future__ import division
from __future__ import print_function
from __future__ import unicode_literals
1. print 必须作为函数调用
在 Python 2 中,print 属于语言关键字,而在 Python 3 中被重构为内置函数。一旦引入 print_function,Python 2 就会将 print 视作函数,支持 file、end、sep 等参数。
import sys
# 正确兼容写法:像普通函数一样调用,支持重定向与定制分隔符
print("执行结果:", 200, sep=" ", file=sys.stdout)
注意陷阱:在未引入 print_function 的 Python 2 中,写 print("hello", "world") 会被解析为打印一个二元组 ('hello', 'world'),引入后则会按预期输出以空格分隔的两个单词。
2. 除法运算符的行为对齐
在默认的 Python 2 中,两个整数相除采用“截断整除”模式(例如 3 / 2 得到 1),而 Python 3 中 / 始终是“真除法”(3 / 2 得到 1.5),整除则使用双斜杠 //。
导入 from __future__ import division 后,Python 2 将完全对齐 Python 3:
- 使用
/永远返回浮点数,即使分子分母都是整数。 - 需要向下取整时,一律显式使用
//(例如7 // 3得到2)。
3. 绝对导入与相对导入明确化
Python 2 默认优先在当前包内寻找同名模块(隐式相对导入),容易误导入与标准库同名的局部文件;Python 3 则默认绝对导入。引入 from __future__ import absolute_import 之后,导入标准库将直达根命名空间,当前包内模块导入则强制使用点号显式相对导入(如 from . import utils)。
unicode_literals 的权衡:from __future__ import unicode_literals 会使模块内所有未带前缀的字符串字面量 "text" 成为 unicode 对象。在绝大部分业务代码中这能极大简化向 Python 3 的迁移;但若需要与某些要求原生 str 的 C 扩展模块、os.environ 键值或特定底层网络库交互,可能引发隐式类型报错。此时需对纯字节字面量显式标注 b"raw bytes"。
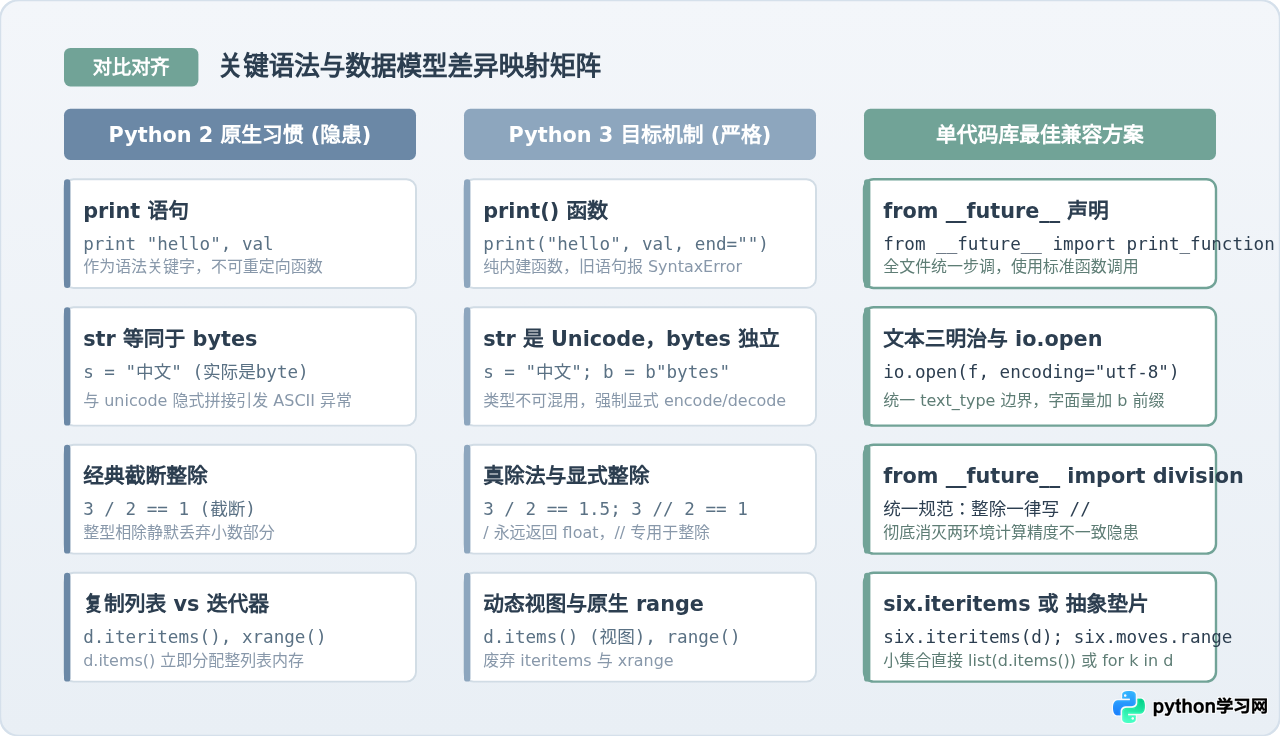
二、理清文本与二进制边界——遵循“文本三明治法则”
Python 2 与 3 之间最隐蔽、最普遍的报错来源于字符串与字节类型的混乱。在 Python 2 中,str 实际上是字节序列,并且会与 unicode 进行隐式转码;而在 Python 3 中,bytes 与 str(Unicode 文本)完全隔离,绝不允许隐式混合拼接或比较。
1. 文本三明治模型(Text Sandwich)
要让代码在两个版本下均不出现 UnicodeDecodeError 或 TypeError,必须执行“三明治”处理策略:
- 输入边界:当从文件、网络套接字或外部进程读取到字节流(bytes)时,第一时间调用
.decode("utf-8")转换为文本对象。 - 内部核心:程序内部所有业务处理逻辑、字符串拼接、格式化与正则匹配,全程只使用 Unicode 文本。
- 输出边界:只有在向终端、文件或网络写出数据的前一刻,才显式调用
.encode("utf-8")转换为字节流。
2. 统一的文件 I/O 操作
不要使用内置的 open() 函数,因为 Python 2 的 open 默认以字节模式读取,不支持 encoding 参数;而在 Python 3 中 open 默认读取文本并依赖系统编码。
最佳实践:始终使用标准库的 io.open,它在 Python 2.7 和 Python 3 中具有完全一致的签名与行为:
import io

# 读取文本文件:显式指定编码,返回跨版本一致的 Unicode 文本
with io.open("config.json", mode="r", encoding="utf-8") as f:
    content = f.read()

# 写入二进制文件:显式标记 'wb',写入 bytes
with io.open("archive.bin", mode="wb") as f:
    f.write(b"\x00\x01\x02\x03")
3. 字符串与字节类型的跨版本检查
当需要通过 isinstance() 判断变量类型时,直接使用 str 或 basestring 会在其中一个版本失败。建议引入轻量兼容垫片(如 six)或自建兼容基类:
import sys

# 自建简易类型垫片(若不引入外部 six 库)
PY2 = sys.version_info[0] == 2

if PY2:
    text_type = unicode
    binary_type = str
    string_types = (str, unicode)
else:
    text_type = str
    binary_type = bytes
    string_types = (str,)

# 兼容的类型判断示例
def sanitize_input(value):
    if isinstance(value, string_types):
        return value.strip()
    elif isinstance(value, binary_type):
        return value.decode("utf-8").strip()
    raise TypeError("不支持的输入类型: %r" % type(value))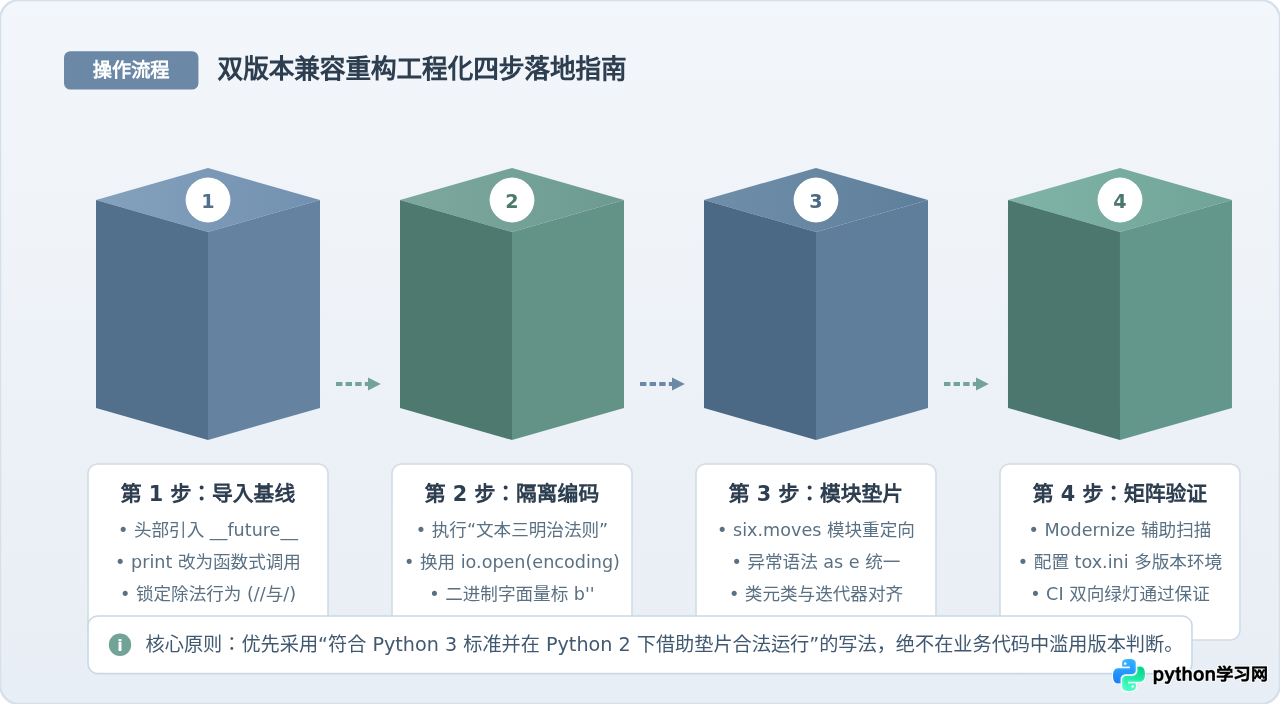
三、标准库与内置函数重组的平滑过渡
Python 3 对标准库模块结构进行了大规模重整,合并与拆分了许多旧模块(如 urllib 族、Queue、configparser)。处理模块变动的原则是:优先尝试从 Python 3 的路径导入,失败时回退到 Python 2 路径,并赋予统一别名。
1. 常见重命名模块映射表
| 功能场景 | Python 2 模块路径 | Python 3 模块路径 | 推荐统一导入写法 |
|---|---|---|---|
| HTTP 网络请求 | urllib2, urllib |
urllib.request, urllib.parse |
six.moves.urllib.request |
| 配置文件解析 | ConfigParser |
configparser |
import configparser (或 try/except) |
| 线程安全队列 | Queue |
queue |
try: import queue except: import Queue as queue |
| 高效对象序列化 | cPickle |
pickle |
try: import cPickle as pickle except: import pickle |
| 内存字符串缓冲 | cStringIO.StringIO |
io.StringIO |
from io import StringIO |
2. 纯标准库兼容器模式(不依赖第三方包)
如果不希望项目引入额外的依赖项,可以在项目内建立一个单独的 compat.py 模块集中维护垫片,避免在各个业务模块中重复编写 try...except ImportError:
# compat.py
import sys

PY2 = sys.version_info[0] == 2

if PY2:
    import urllib2 as urlrequest
    import urlparse
    import Queue as queue
    from cStringIO import StringIO
    from itertools import izip as zip
    range = xrange
    raw_input = raw_input
else:
    import urllib.request as urlrequest
    import urllib.parse as urlparse
    import queue
    from io import StringIO
    zip = zip
    range = range
    raw_input = input
业务代码只需要执行 from mypkg.compat import urlrequest, range, StringIO,即可获得一致的调用方式。
四、数据容器迭代与面向对象协议对齐
Python 3 普遍将返回完整列表的接口改造成了惰性迭代器或字典视图(View)。若代码中包含针对 Python 2 专有方法的调用,在 Python 3 下会直接抛出 AttributeError。
1. 字典迭代方法的适配
在 Python 2 中,dict.items() 会直接在内存中分配包含所有键值对的全新列表,高并发或大数据量时必须用 dict.iteritems() 节省内存。但 iteritems()、iterkeys() 和 itervalues() 在 Python 3 中被全部移除,因为 Python 3 的 items() 本身就是低开销的视图对象。
- 对于常规迭代,优先直接遍历字典自身:
for key in my_dict:。 - 遍历键值对时,若字典规模不大,直接使用
for k, v in my_dict.items():即可满足两端兼容。 - 对于极度敏感的大字典,使用
six.iteritems(my_dict)获取迭代器。
2. 异常捕获语法与重新抛出
Python 2 曾经支持逗号风格的异常捕获 except ValueError, err:,这一写法在 Python 3 中属于语法错误(SyntaxError)。所有异常捕获都必须采用 as 关键字:
try:
    process_data()
except (TypeError, ValueError) as err:
    logger.warning("数据解析异常: %s", err)
    # 若需保留堆栈重新抛出,避免修改异常对象
    raise
3. 类的元类(Metaclass)声明
在 Python 2 中,指定元类使用类属性 __metaclass__ = MetaType;而在 Python 3 中,元类通过类声明参数传入:class MyClass(metaclass=MetaType):。两者语法互不相容。
正确的兼容写法是使用 six.with_metaclass,或者定义一个临时的基类工厂:
import six

class ValidationMeta(type):
    def __init__(cls, name, bases, attrs):
        super(ValidationMeta, cls).__init__(name, bases, attrs)

# 兼容 Python 2 和 Python 3 的元类继承写法
class BaseRecord(six.with_metaclass(ValidationMeta, object)):
    pass
4. 自定义类的 __str__ 与 __unicode__ 协议
在 Python 2 中,__str__ 返回字节串,__unicode__ 返回文本;而在 Python 3 中,__str__ 必须返回 Unicode 字符串。使用 @six.python_2_unicode_compatible 装饰器可以一劳永逸地解决这一冲突:
import six

@six.python_2_unicode_compatible
class UserProfile(object):
    def __init__(self, username):
        self.username = username

    # 只需编写符合 Python 3 习惯的 __str__
    def __str__(self):
        return "用户详情: %s" % self.username
该装饰器会自动在 Python 2 环境下将此方法映射为 __unicode__(),并生成一个经过 UTF-8 编码的 __str__() 方法。
五、自动化工具链与工程化验证
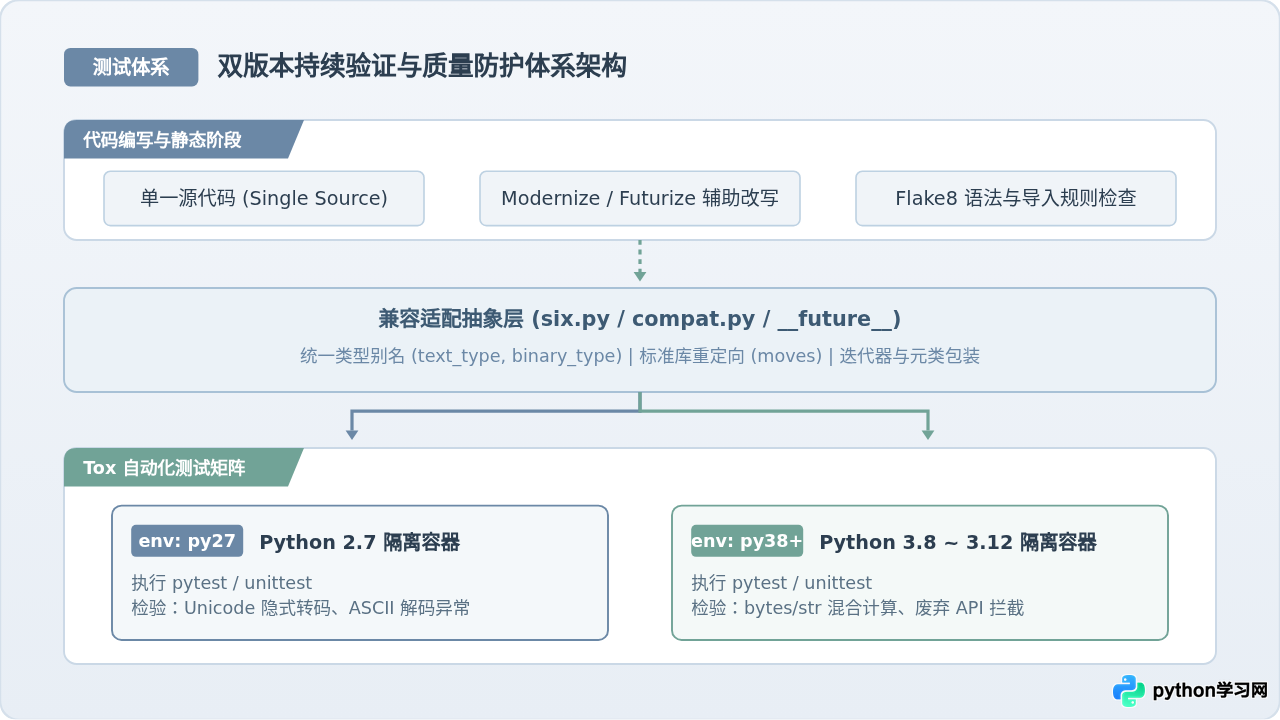
手动改造大型项目不仅效率低下,而且容易遗漏隐式类型转换或深层语法。工程上应当结合静态检测工具进行辅助改写,并通过自动化测试矩阵进行守卫。
1. 使用 Modernize 或 Futurize 进行渐进式重构
python-modernize 和 futurize 是专门用于编写双版本兼容代码的自动化工具。与直接转成纯 Python 3 的 2to3 不同,它们通过引入 six 或 future 库,将代码改写为两端均可运行的形式。
# 安装 modernize
pip install modernize

# 查看当前文件的兼容性改造建议(不修改原文件)
python-modernize -d src/module.py

# 自动将建议原地应用到源代码中
python-modernize -w src/
2. 配置 Tox 驱动多版本测试矩阵
确保双版本兼容最坚固的防线是 CI 持续集成测试。在代码根目录编写 tox.ini 文件,使本地和远程 CI 同时运行 Python 2.7 与目标 Python 3 版本的测试套件:
[tox]
envlist = py27, py38, py310

[testenv]
deps =
    pytest
    six
commands =
    pytest tests/
只有当所有版本的测试环境全部输出绿色通过(Passed)时,代码的兼容性改造才算真正完成。
六、总结与迁移防劣化建议
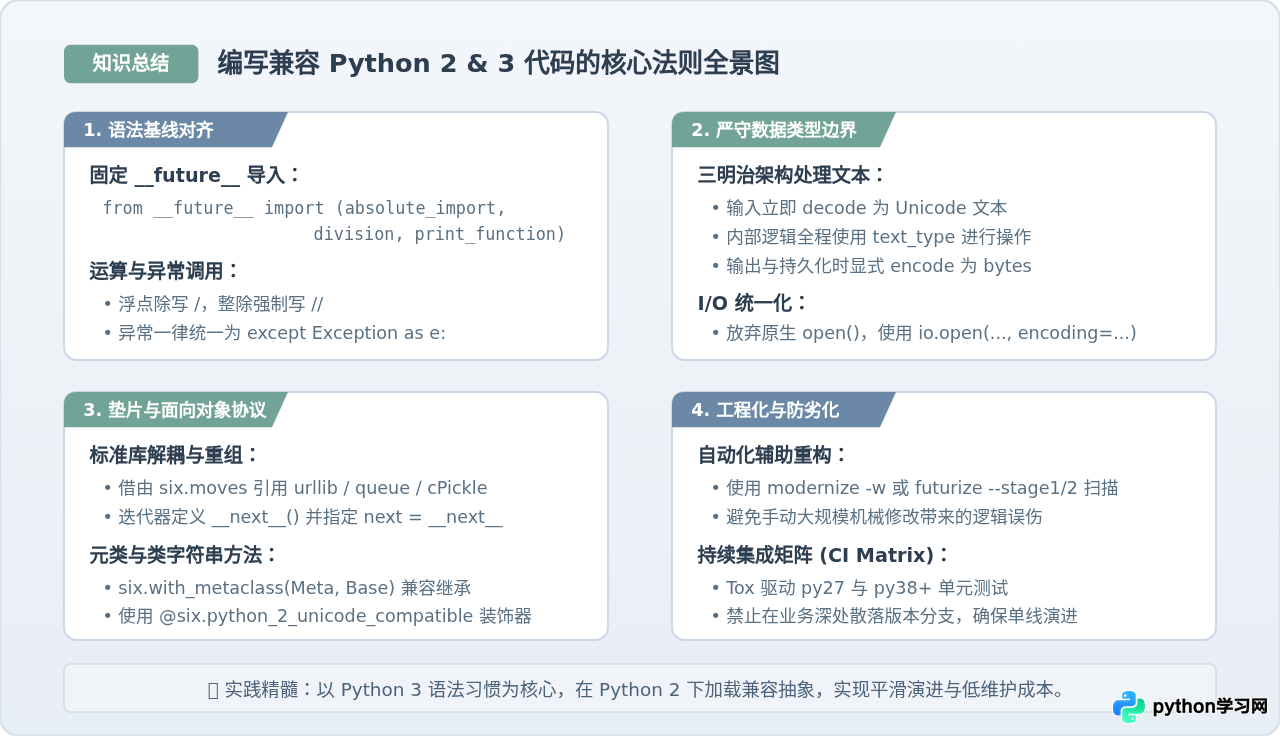
双版本兼容代码的本质是一座“过渡桥梁”。为了保障代码的可维护性,应严格遵守以下三条防劣化规则:
- 严禁散落版本判断:业务代码内部不应出现诸如
if sys.version_info[0] == 2: ... else: ...的逻辑分叉。所有差异必须在基础层通过垫片(shim)消化。 - 全面拥抱 Python 3 习惯:新编写的代码从第一行起就应当符合 Python 3 的语法与类型理念,仅在 Python 2 执行时由兼容层向下适配,绝不为了兼顾旧语法而采用废弃的设计模式。
- 设置清晰的生命周期:当宿主环境完全具备停用 Python 2 的条件时,只需使用
pyupgrade等工具自动剥离six和__future__依赖,即可无缝收敛为干净的纯现代 Python 3 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









