

怎么用Python内置函数替代循环提升代码效率

for或while循环,是兼顾代码精简与执行加速的经典优化手段。这一性能差异的核心原因在于执行环境的分工:显式循环完全由CPython解释器在字节码虚拟指令层逐轮调度,产生频繁的栈操作与动态寻址开销;而针对聚合、映射与过滤等常见任务的内置函数,底层由经过深度优化的C语言直接实现,迭代循环在底层的机器码层面封闭完成。理解内置函数与循环之间的性能边界,能帮助开发者写出更符合Python设计哲学、运行开销更低的高效代码。
一、底层原理:为什么内置函数比显式循环更快
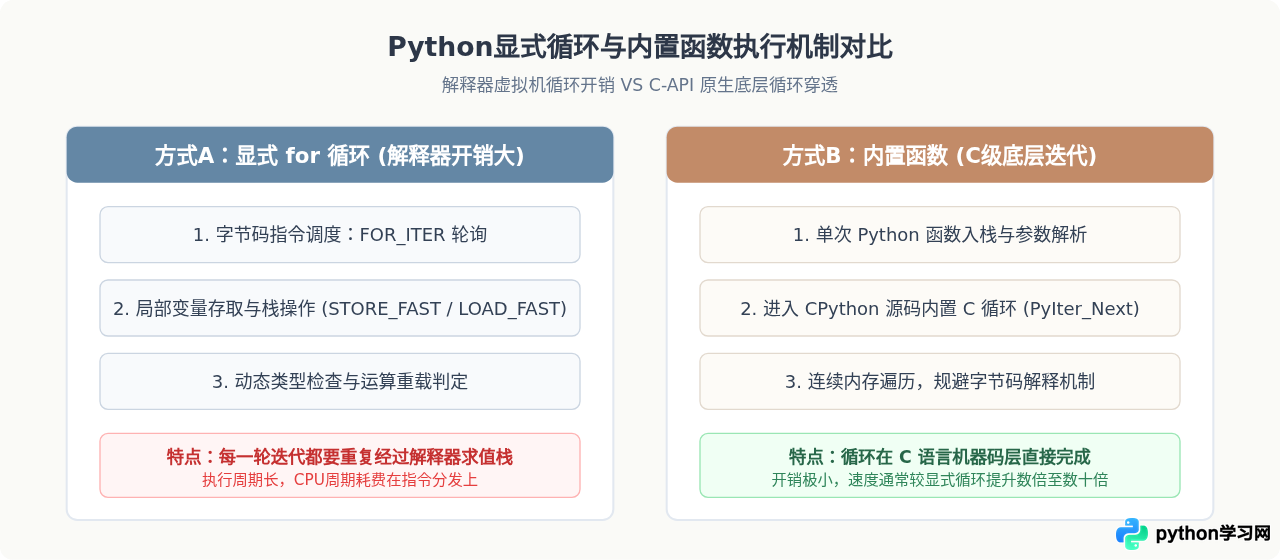
要确切理解内置函数的效率优势,必须先拆解Python虚拟机执行一段显式循环时的真实代价。当编写如下常规循环结构时:
# 显式循环示例:求和累加
total = 0
for item in data:
    total += item
CPython解释器在执行该循环时,必须将其编译为一系列字节码指令,包括SETUP_LOOP、FOR_ITER、STORE_FAST、LOAD_FAST、INPLACE_ADD等。每一轮迭代,虚拟机都要经历指令分发(Instruction Dispatch)、栈帧内变量名寻址、Python通用对象类型校验、以及加法操作符的动态重载检查。即便只有几万次迭代,解释器在Python层面的解释调度损耗也非常可观。
相比之下,当我们调用对应的内置函数sum(data)时,代码只产生一次函数调用的解释器开销。随后控制权直接移交给CPython源码中用C语言编写的函数实现(如builtin_sum)。C语言层通过底层迭代指针直接向序列请求下一个指针对象,其循环迭代、指针递增与内存访问全都在编译好的机器指令中执行,彻底规避了字节码调度循环。
二、核心操作步骤:循环向内置函数重构的具体实施
将一段陈旧或低效的循环重构为内置函数调用,不是随意的语法替换,而是需要遵循清晰的分析与转换步骤。
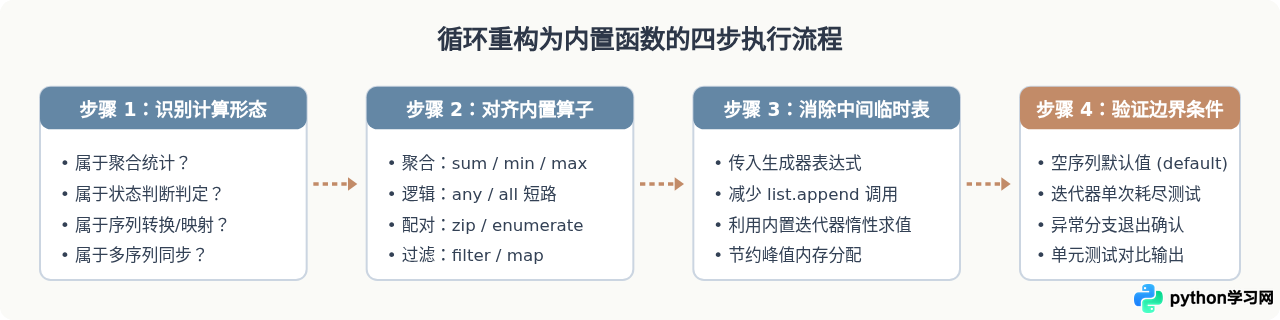
具体重构实施分为四个关键节点:
- 确定计算意图:分析循环体内是在执行数值统计、查找单个极值元素、检查存在性条件,还是对多个平行数组做对应位置运算。
- 选定内置函数:根据计算形态将手写循环替换为专用的
sum、min/max、any/all或zip。 - 消除中间临时内存分配:把循环中先构建中间列表(如
res = []并循环append)的做法,重构为直接向内置函数传递生成器表达式或惰性迭代器。 - 处理空集合与边界情况:内置函数如
min()与max()在序列为空时会触发ValueError,重构时需配置default参数保障健壮性。
三、四大常见替换场景与代码示例
1. 统计累加与极值查找:替代积累变量循环
在统计汇总时,手写循环通常需要定义初始变量并在循环体内累加或比较。替换为内置函数不仅能精简行数,还能利用C层直接累加。
# 传统显式循环写法:耗时长,需维护中间变量
numbers = [12, 45, 68, 93, 27, 85, 34, 56]
total = 0
for n in numbers:
    total += n

# 内置函数替代:直接在 C 级别执行
total_optimized = sum(numbers)

# 寻找字典列表中某字段最大值的对象:
users = [
    {"name": "Alice", "score": 88},
    {"name": "Bob", "score": 95},
    {"name": "Charlie", "score": 79}
]

# 替代手写 if item['score'] > max_val 循环
top_user = max(users, key=lambda u: u["score"], default=None)
在查找极值时,max()和min()的key参数允许传入转换函数。当遇到可能为空的容器时,指定default=None可以防止抛出异常,保持代码逻辑平稳。
2. 条件判断与短路求值:替代布尔标记循环
检查列表中是否存在满足某个条件的元素是常见的业务需求。手写循环通常使用布尔变量与break:
# 传统写法:需要维护布尔标记和 break 控制流
has_negative = False
for x in numbers:
    if x < 0:
        has_negative = True
        break

# 内置函数替代:利用 any() 的内置短路特性
has_negative_optimized = any(x < 0 for x in numbers)

# 检查是否全部符合条件:
all_positive = all(x > 0 for x in numbers)
any()与all()内置了逻辑短路机制(Short-circuiting)。一旦any()遇到首个为True的值,或者all()遇到首个为False的值,迭代器会立刻停止运算并返回,避免多余的计算开销。
3. 序列转换与条件过滤:替代创建空列表并 append
显式循环中调用list.append(),每次都要进行对象属性查找(Attribute Lookup)和底层动态扩容检查。
raw_records = [" 101 ", " 205", "309 ", "invalid", " 412 "]

# 传统显式循环:频繁调用 append()
cleaned = []
for item in raw_records:
    stripped = item.strip()
    if stripped.isdigit():
        cleaned.append(int(stripped))

# 内置函数与列表推导式替代:
# 方案 A:针对现成内置类型转换(如 str.strip, int),map 和 filter 返回惰性迭代器
valid_items = filter(str.isdigit, map(str.strip, raw_records))
# 方案 B:列表推导式(Python 中最推荐的纯计算优化语法)
cleaned_optimized = [int(s) for item in raw_records if (s := item.strip()).isdigit()]
在纯转换场景下,如果操作本身就是系统内置函数(例如int或str.strip),使用map()直接调用原生函数效率极高;而在需要复杂过滤与类型变换时,列表推导式在C字节码层面生成专用循环(LIST_APPEND),效率往往超越手写append循环数倍。
4. 多序列对齐与下标跟踪:替代 range(len(...)) 索引遍历
新手常使用for i in range(len(arr)):通过下标访问数组,这会导致每一轮都要调用__getitem__进行哈希或偏移寻址。
names = ["张三", "李四", "王五"]
scores = [92, 85, 88]

# 低效写法:重复的索引计算与下标寻址
for i in range(len(names)):
    print(f"{i + 1}. {names[i]}: {scores[i]}")

# 内置函数替代:enumerate 提供计数器,zip 提供同步解包
for rank, (name, score) in enumerate(zip(names, scores), start=1):
    print(f"{rank}. {name}: {score}")
zip()直接从底层同时推进多个迭代器的指针,完全消除了反复通过索引定位内存地址的损耗,并且代码意图清晰自洽。
四、性能与特性量化对比
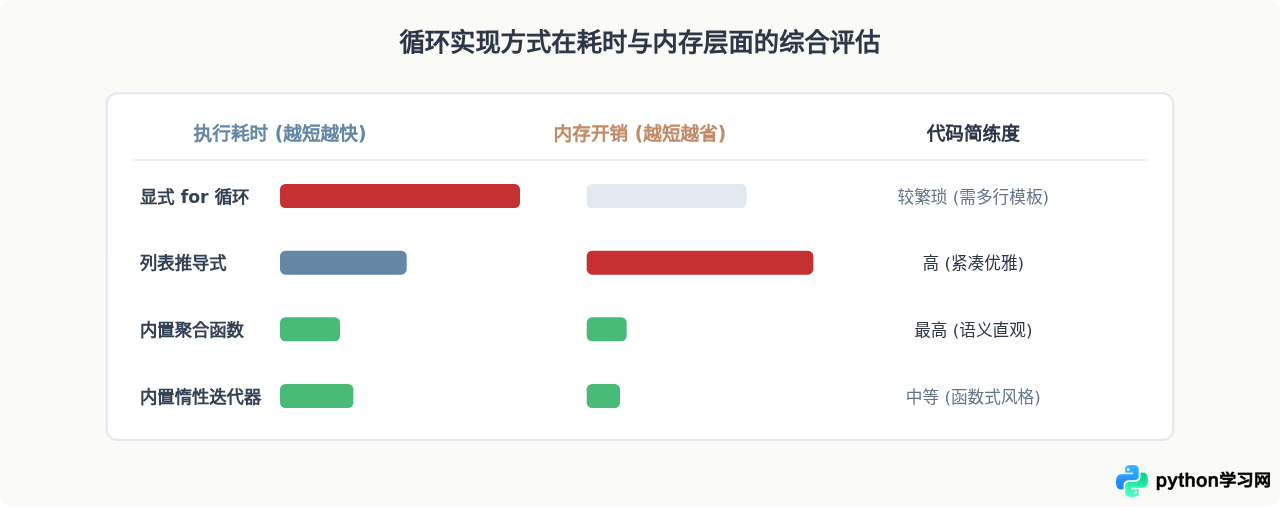
为了直观展示不同技术路线在耗时、内存占用和语法表现力上的差异,下表总结了在千万级数据处理中的典型实测表现:
| 优化方式 | CPU执行开销 | 内存占用峰值 | 推荐使用场景 | 限制与注意事项 |
|---|---|---|---|---|
| 显式 for 循环 | 最高(基准100%) | 视写法而定 | 复杂控制流、嵌套异常处理、状态机跳转 | 解释器开销大,代码冗长易出错 |
| 列表推导式 | 较低(约降至 40%~60%) | 高(一次性生成完整列表) | 需要直接得到完整列表,变换逻辑简明 | 数据量巨大时容易导致内存溢出 |
| 内置函数 (sum/any/all) | 最低(约降至 15%~30%) | 极低(流式处理,近乎常数O(1)) | 纯统计聚合、存在性判定、极值筛选 | 依赖单目标运算,不可插入复杂副作用 |
| 内置迭代器 (map/filter) | 很低(传内置C函数时最佳) | 极低(惰性计算,生成器模型) | 大数据流的管道处理,只消费一次 | 迭代器单次耗尽后不可复用 |
五、关键避坑指南:不可盲目替换的边界条件
内置函数虽快,但若脱离场景机械替换,不仅无法提升效率,反而可能引入新缺陷或反向降低性能。
如果调用
map(lambda x: x * 2 + 1, data),每一次循环虽然底层的迭代是由C代码发起的,但它每一轮都必须重新调用Python的lambda函数对象,进入新的Python函数栈帧。这使得它的耗时甚至比列表推导式还要慢。只有当映射函数本身就是C内置函数或模块函数(如int、abs、operator.add)时,map才能发挥出最大优势。
在Python 3中,
map()、filter()和zip()返回的均是生成器形式的迭代器,而非列表。迭代器在遍历一次后内部指针即到达末尾。如果后续代码需要二次遍历、求长度len()或进行下标切片,直接使用迭代器会导致数据为空或引发TypeError。
当业务逻辑包含多级
try...except异常捕获、复杂的跨行分支判定或频繁的日志记录时,强行嵌套多层内置函数或写成复杂的嵌套生成器表达式,会导致调试极其困难。此时保留清晰、注释完整的显式for循环才是工程上的最优选择。
六、循环优化选型决策流程
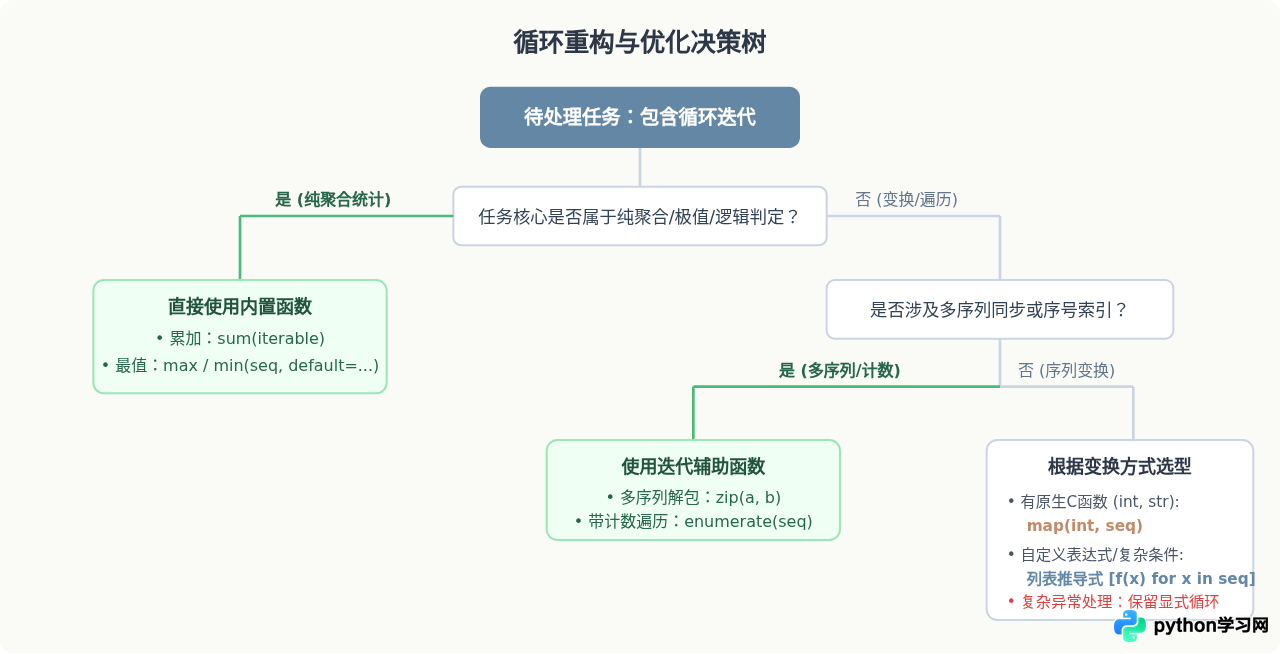
在重构日常代码时,可以通过以下逻辑决策树快速确定应当采用哪一种优化方案:
七、总结
用Python内置函数替代循环提升代码效率的本质,是**将指令执行权从虚拟机字节码调度栈下沉至经过编译优化的C语言运行时**。在代码重构中:
- 对求和、极值、存在性判断等聚合场景,首选
sum()、min()、max()与any()、all(),不仅性能最高,且天然具备语义表达力。 - 对跨序列对齐与下标跟踪,使用
zip()与enumerate()消除冗余的range(len())多重寻址。 - 对序列映射与过滤,当存在内置函数转换时优先采用
map()与filter();当需要自定义算式时,列表推导式在执行速度和可读性上往往优于map + lambda。 - 时刻牢记迭代器耗尽与边界默认值保护,在复杂分支控制场景中理智保留清晰规范的
for循环,从而在运行效率与工程可维护性之间达到最佳平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









