

非计算机专业转行学Python,应该重点掌握哪些技能
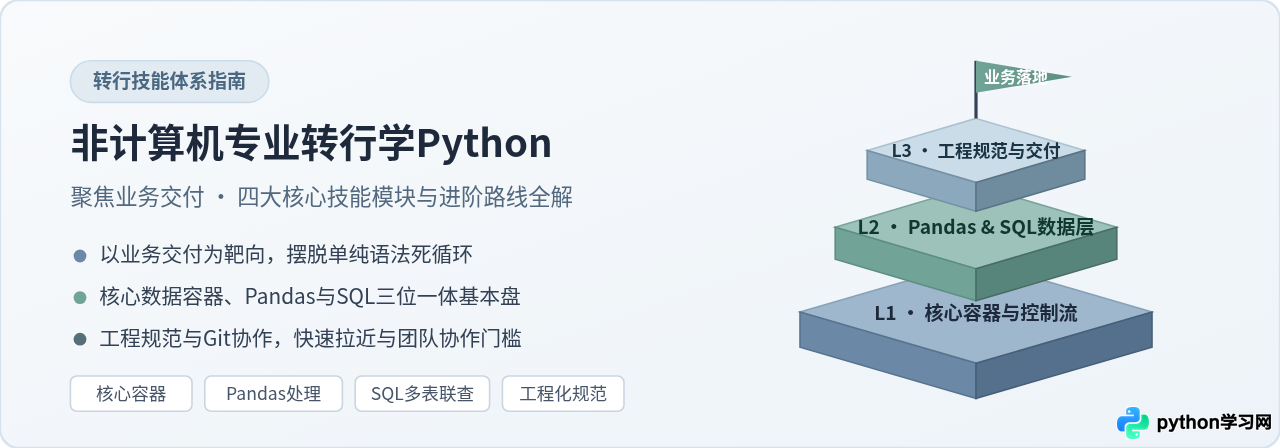
非计算机专业转行学Python,应该重点掌握哪些技能?本文从业务交付角度梳理了核心语法容器、Pandas数据处理、SQL多表查询以及工程协作规范四大模块,并提供四阶段学习演进路线与优先级矩阵。
一、技能定位:从“业务问题”反推学习清单
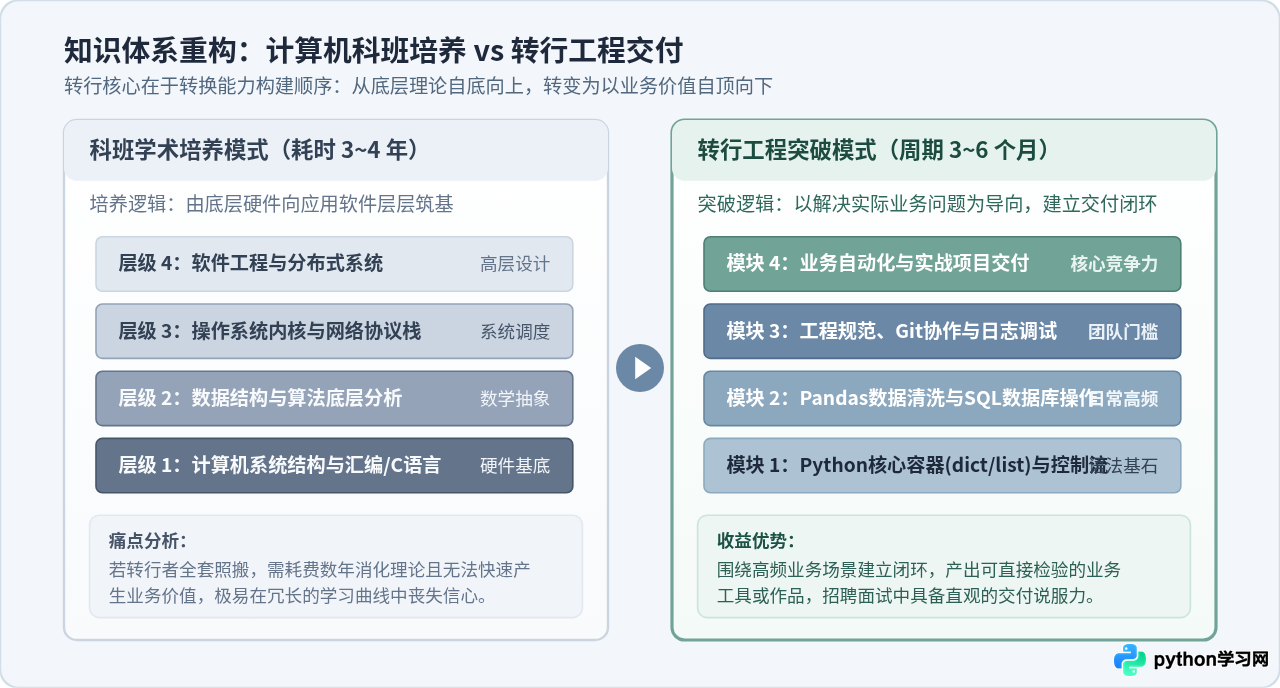
计算机专业的培养目标是系统化的底层建筑,课程涵盖离散数学、汇编语言、编译原理、操作系统内核及算法分析。这种体系需要数年的连续脱产沉浸,旨在培养能够开发底层基建、编译器或复杂操作系统的科研人员与系统工程师。
非计算机专业转行者面临完全不同的客观条件:学习周期通常只有 3 至 6 个月,求职目标主要是数据分析师、自动化测试、运维开发、后端初级工程或业务系统支持岗位。这些岗位考核的核心标准,是你能否在接手业务需求后,独立编写出逻辑自洽、运行稳定且能够处理脏数据的代码,而不是你能否手写红黑树或手写汇编指令。
因此,转行者的技能构建策略应当彻底倒置:由传统的“自底向上筑基”转变为“从业务痛点反推技能树”。凡是在日常业务开发中高频调用的工具,必须达到肌肉记忆般的熟练度;凡是偏向底层学术研究、面试极少让转行者实操的理论,应当在初期果断延后。
二、核心语法:聚焦高频数据容器与防御性控制流
很多初学者把“学语法”理解为背诵语法字典,逐章学习面向对象的高级魔术方法、元类、深层闭包和描述符。在实际业务中,由于绝大多数任务都在对各类外部数据进行提取、转换与校验,真正每天都在调用的语言核心特性高度集中在以下三项:
- 字典(dict)与列表(list)的高效操作:企业业务数据无论来自 API 还是日志,在内存中通常表现为字典与列表的嵌套结构。必须熟练使用
dict.get()设定安全缺省值、使用列表推导式完成批量字段映射与条件过滤。 - 结构化函数设计:掌握函数的参数解包(
*args、**kwargs)、单一职责原则与多值返回,杜绝把数百行逻辑堆砌在一个全局作用域中。 - 防御性异常处理(try...except):外部数据往往伴随字段缺失、数据类型不一致或空值污染。工程师必须具备局部捕获特定异常并输出日志的能力,避免批处理任务因为一行异常数据而崩溃退出。
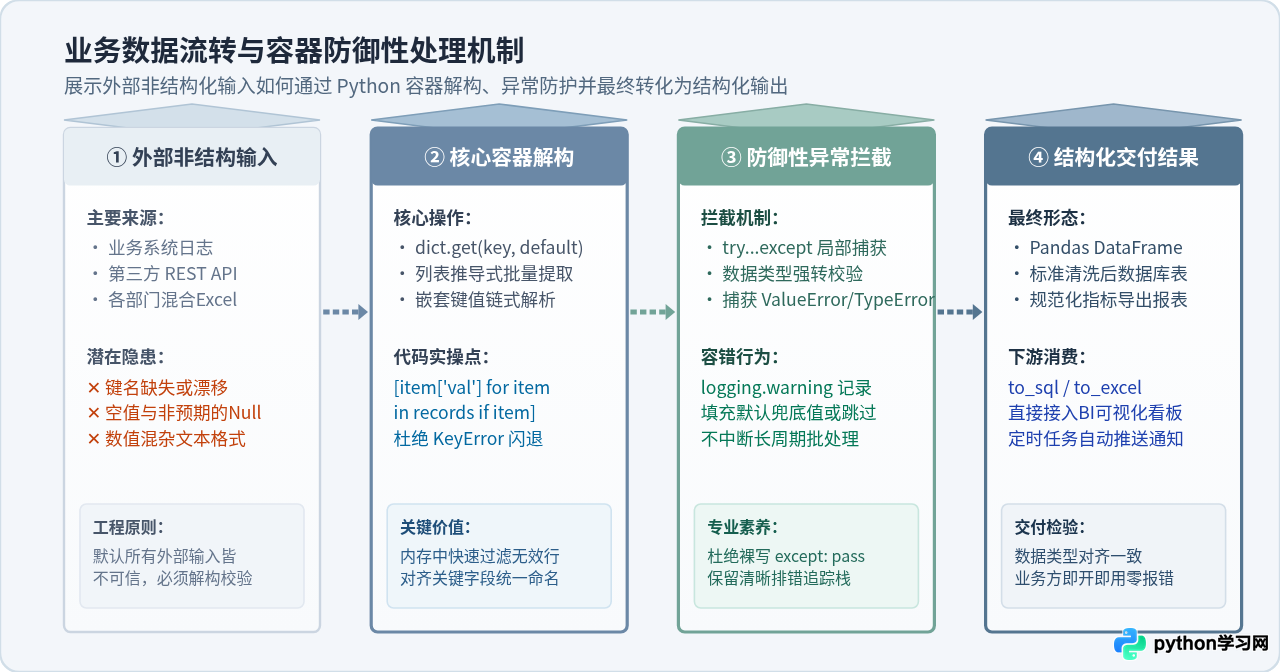
下面是一个典型的业务场景示例:从外部非结构化接口数据中提取有效交易记录,清洗脏数据并输出规整字典列表。
Python 核心容器实操示例(clean_records.py)import logging
logging.basicConfig(level=logging.INFO, format="%(levelname)s: %(message)s")
raw_api_payload = [
{"order_id": "ORD_101", "amount": "129.50", "status": "COMPLETED"},
{"order_id": "ORD_102", "amount": "INVALID", "status": "COMPLETED"}, # 脏数据:金额异常
{"order_id": "ORD_103", "amount": "88.00", "status": "CANCELLED"}, # 状态过滤
{"order_id": "ORD_104", "amount": "210.00"}, # 缺漏状态字段
{"corrupted_data": True}, # 缺漏关键ID
]
def parse_and_validate_order(record: dict) -> dict | None:
# 1. 使用 dict.get 安全获取字段,避免抛出 KeyError
order_id = record.get("order_id")
if not order_id:
logging.warning("跳过无效记录:缺失 order_id 字段 -> %s", record)
return None
status = record.get("status", "UNKNOWN")
if status != "COMPLETED":
return None
# 2. 局部捕获类型转换异常,防止整个脚本中断
try:
clean_amount = float(record.get("amount", 0.0))
except (ValueError, TypeError) as err:
logging.warning("订单 %s 金额转换失败,已标记忽略: %s", order_id, err)
return None
return {"order_id": order_id, "amount": clean_amount, "status": status}
# 3. 使用列表推导式高效完成过滤与提取
valid_orders = [
parsed for item in raw_api_payload
if (parsed := parse_and_validate_order(item)) is not None
]
print("清洗后有效订单结果:", valid_orders)
except: pass。这种写法会吞噬所有底层系统异常(包括键盘中断 KeyboardInterrupt 和语法错误),导致代码在发生严重隐患时毫无排查线索。始终捕获具体异常类并输出告警。
三、业务利器:文件系统操作与 Pandas 结构化数据清洗
对非计算机专业的转行者来说,最快展现代码实用价值的场景是“自动化办公与结构化数据处理”。日常工作中有大量跨部门 Excel 表格合并、CSV 报表定期汇总与目录检索任务。若能用代码在数秒内完成原本人工需耗费半天的工作,就能迅速在企业内部建立正向技术反馈。
该模块的核心技术栈包含两个关键组件:
- 现代路径库 pathlib:替代过时的
os.path。通过面向对象方式实现跨平台路径拼接(Path / "data")、批量文件检索匹配(path.glob("*.xlsx"))以及文件存在性检查。 - 数据清洗工具 Pandas:熟练使用
read_csv与read_excel、布尔索引多条件筛选、fillna与dropna缺失值修补、merge双表字段关联以及groupby分组聚合统计。
import pandas as pd
from pathlib import Path

# 模拟构建待清洗的业务数据集
data_department = pd.DataFrame({
    "staff_id": ["E101", "E102", "E103", "E104"],
    "staff_name": ["张伟", "李芳", "王强", "赵敏"],
    "region": ["华东", "华北", "华东", "华南"]
})

data_sales = pd.DataFrame({
    "staff_id": ["E101", "E102", "E103", "E105"],
    "sales_count": [45, None, 80, 20],               # 存在空值
    "revenue": [13500.0, 9200.0, 24000.0, 6000.0]
})

# 1. 缺失值填充与类型修正
data_sales["sales_count"] = data_sales["sales_count"].fillna(0).astype(int)

# 2. 多表关联:依据 staff_id 实行左连接
merged_df = pd.merge(data_department, data_sales, on="staff_id", how="left")

# 3. 多条件过滤与分组汇总:统计华东大区业务表现
east_summary = (
    merged_df[merged_df["region"] == "华东"]
    .groupby("region")
    .agg(
        total_staff=("staff_id", "count"),
        total_revenue=("revenue", "sum"),
        avg_revenue=("revenue", "mean")
    )
    .reset_index()
)

print(east_summary.to_string(index=False))
四、硬门槛跨越:SQL 关系型数据库查询与多表联动
许多转行者在面试中受挫,不是因为 Python 语法不过关,而是忽视了 SQL。在现代企业生产环境中,核心业务数据全部沉淀在关系型数据库(如 MySQL、PostgreSQL、SQL Server)或数仓中,几乎没有重要业务系统会直接将原始数据以单个 CSV 文件形式存放在本地磁盘。
学习 SQL 的投资回报率极高。对于转行求职者,必须攻克的 SQL 知识点主要包括:
- 基础过滤与排序:
SELECT指定字段、WHERE多条件筛选、IN、BETWEEN以及模糊搜索LIKE。 - 多表连接(JOIN):深入理解
INNER JOIN(内连接仅取交集)与LEFT JOIN(左连接保留主表全量),明确外键匹配关系,防止多对多关联导致的笛卡尔积数据虚增。 - 分组聚合(GROUP BY & HAVING):熟练结合
COUNT()、SUM()、AVG()进行分类汇总,理解WHERE(分组前过滤)与HAVING(分组后指标过滤)的执行顺序区别。 - Python 与数据库联动:掌握利用内置
sqlite3或标准库SQLAlchemy执行 SQL,并直接使用pd.read_sql_query()将数据无缝提取为 DataFrame。
import sqlite3
import pandas as pd

# 在内存中创建模拟数据库并初始化表结构
conn = sqlite3.connect(":memory:")
cursor = conn.cursor()

cursor.executescript("""
CREATE TABLE users (
    user_id INTEGER PRIMARY KEY,
    username TEXT NOT NULL,
    department TEXT NOT NULL
);

CREATE TABLE orders (
    order_id INTEGER PRIMARY KEY,
    user_id INTEGER,
    amount REAL,
    created_at DATE
);

INSERT INTO users VALUES (1, 'Alice', '技术部'), (2, 'Bob', '运营部'), (3, 'Charlie', '市场部');
INSERT INTO orders VALUES (101, 1, 450.0, '2026-03-01'), (102, 1, 320.0, '2026-03-05'), (103, 2, 890.0, '2026-03-08');
""")
conn.commit()

# 使用 SQL 完成两表关联并计算每位员工的总采购额
query_sql = """
SELECT
    u.department,
    u.username,
    COUNT(o.order_id) AS order_total_count,
    COALESCE(SUM(o.amount), 0.0) AS total_spending
FROM users u
LEFT JOIN orders o ON u.user_id = o.user_id
GROUP BY u.user_id, u.username, u.department
ORDER BY total_spending DESC;
"""

df_report = pd.read_sql_query(query_sql, conn)
print(df_report.to_string(index=False))

conn.close()
五、工程师底线:虚拟环境、Git 与排错自愈
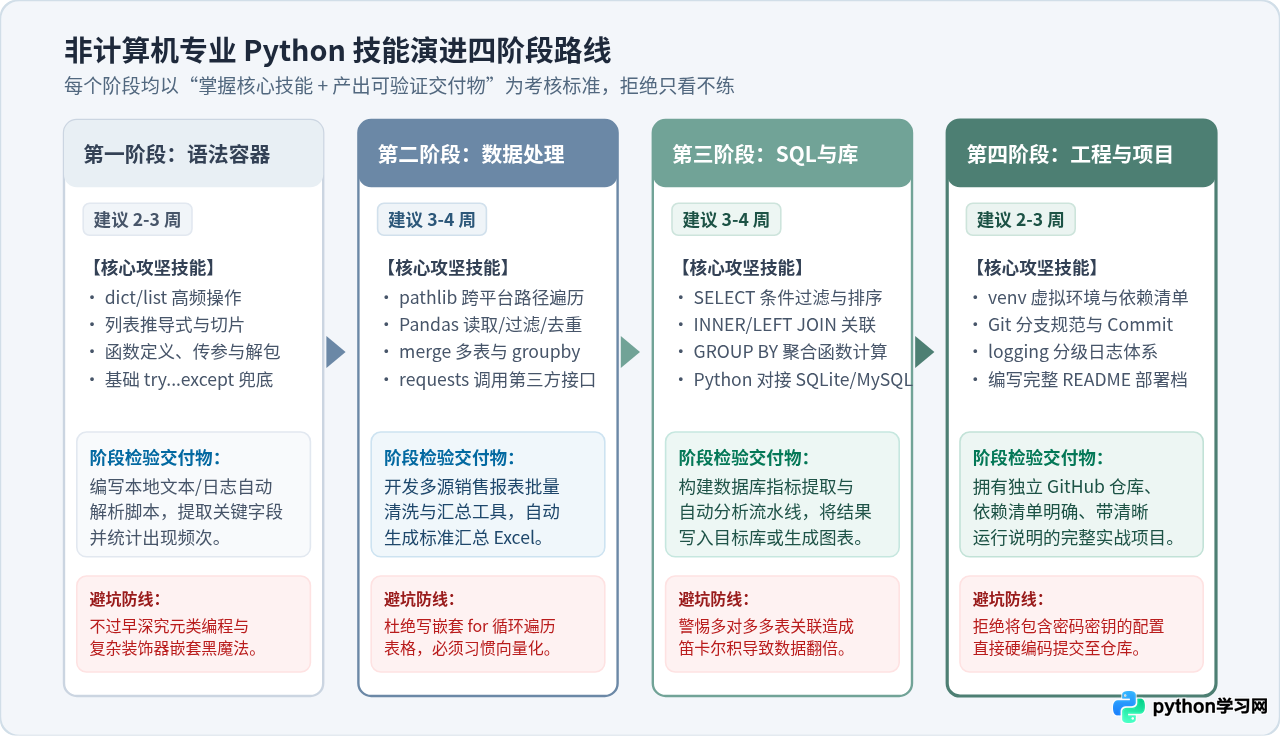
区分“业余写脚本的初学者”与“能够直接融入开发团队的初级工程师”,关键分水岭往往不在于算法复杂度,而在于工程素养。在真实团队协作中,如果一个求职者不会使用版本控制、无法独立排查环境依赖冲突,团队就需要付出极高的带教成本。
转行者必须掌握的工程三大基本件包括:
- 环境隔离与依赖管理(venv):掌握在终端中执行
python -m venv .venv创建虚拟环境,并使用pip freeze > requirements.txt导出明确的依赖清单,避免全局环境污染。 - 版本控制系统(Git):掌握标准命令行工作流:
git clone、创建功能分支git checkout -b feature、检查变动git status与git diff、提交代码git commit -m "清晰的提交信息"以及合并推送。 - 异常排错自愈能力:养成查看 Python 异常报错调用栈(Traceback)末尾核心提示的习惯,从报错类型(如
KeyError,IndexError,AttributeError)精准定位出错代码行,学会使用 VS Code 断点单步调试。
六、精力分配与转行求职避坑策略
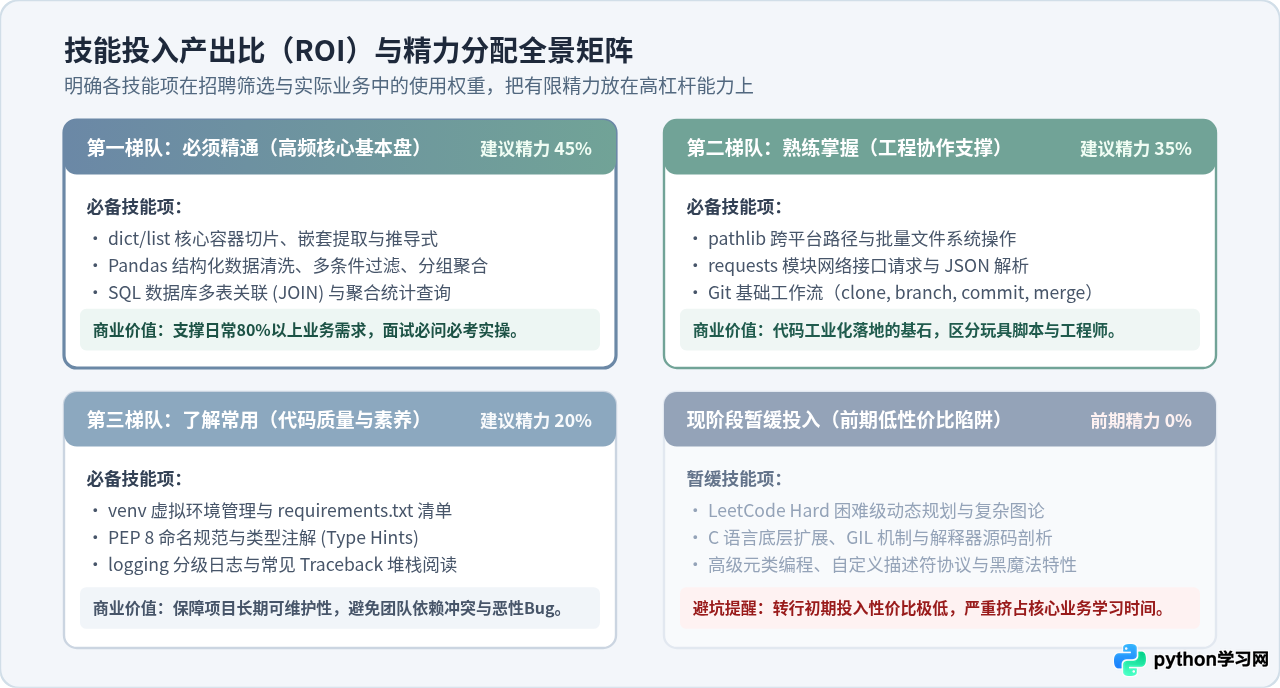
非计算机专业在转行过程中最宝贵的资源是时间。很多自学者之所以半途而废,并不是因为智力不够,而是把 80% 的时间浪费在了投入产出比极低的知识点上。
建议在备战阶段严格执行精力分配矩阵,把核心精力聚焦在高杠杆收益的板块:
转行备战期间务必警惕以下三个典型误区:
- 不要盲目死磕高难度算法: 转行者去应聘业务开发或数据岗位时,笔试极少考察 LeetCode Hard 级别的图论和复杂动态规划。掌握数组双指针、哈希表查找和基础排序思想足以应付常见面试。切勿把本该用来做完整实战项目的数月时间全耗在算法题库中。
-
警惕“教程囤积与只看不练”:
看懂视频教程并不等于具备编码能力。每一次学完关键库后,必须在本地终端亲手敲写代码,刻意制造报错并独立排查。建立自己的 GitHub 主页,上传包含完整
README.md说明、架构图和部署说明的独立项目。 - 充分激活原有专业的业务交叉优势: 纯计算机科班的优势在系统底层,而跨专业转行者的天然优势在于业务理解力。财务专业懂资金核算规则,物流专业懂库存调度逻辑,机械专业懂工程参数约束。用 Python 结合自身原有行业的业务痛点开发解决工具,是在面试中形成独特差异化竞争力的最高效路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









