

Python最常用的10个内置函数详解及代码示例
深入解析Python日常开发中最常用的10个内置函数,涵盖print、len、range、enumerate、zip、sorted、isinstance、map、filter与sum的语法机制、参数用法、执行示例及注意事项。
Python无需导入任何模块即可直接调用的内置函数共有近70个,但在日常编程、数据清洗与脚本开发中,80%以上的操作都围绕其中10个核心函数展开。理解这10个函数的工作机制、参数配置及潜在陷阱,能够大幅精简代码结构,避免由于手工维护索引或错误类型推导而引发的程序缺陷。
1. print():格式化流输出与控制台调试
print()是Python中最基础的输出接口,其核心机制是将传入的对象转换为字符串后写入标准输出流(默认为sys.stdout)。除了直接传参输出外,控制其连接符与行尾符是编写规范日志与终端交互的关键。
语法与关键参数
完整签名格式为:print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False)。其中sep决定多个参数之间的连接字符,end控制行末终止符,flush决定是否立即刷新缓冲区。
# 1. 改变分隔符与终止符
scores = [92, 88, 95]
print("分数列表", *scores, sep=" -> ", end=" [结束]\n")

# 2. 进度条即时刷新(避免缓冲区延迟)
import time
for i in range(1, 4):
    print(f"处理任务 {i}/3...", end="\r", flush=True)
    time.sleep(0.5)
print("\n所有任务已完成!")分数列表 -> 92 -> 88 -> 95 [结束]
所有任务已完成!避错提示:当需要将日志重定向到文件时,可直接指定file=open('log.txt', 'a'),无需额外使用文件句柄显式调用.write()。
2. len():常数时间复杂度获取容器规模
len()用于返回对象中元素的数量。与许多初学者直觉不同,对于Python内置容器(如list、dict、str、tuple),len()的执行时间复杂度为固定的O(1),而非遍历计算的O(n)。
运行机制与自定义对象支持
CPython解释器在内存中维护了容器结构体头部中的元数据(如PyVarObject中的ob_size),len(obj)本质上直接读取该预存数值,并间接调用对象的__len__()魔术方法。
# 常见容器长度检测
user_data = {"id": 1001, "name": "Alice", "role": "admin"}
tag_set = {"python", "backend", "web"}

print("字段数:", len(user_data))
print("标签数:", len(tag_set))

# 自定义支持 len() 的类
class TaskQueue:
    def __init__(self, tasks):
        self._tasks = list(tasks)

    def __len__(self):
        return len(self._tasks)

queue = TaskQueue(["task_a", "task_b", "task_c"])
print("队列待处理项:", len(queue))字段数: 3
标签数: 3
队列待处理项: 33. range():内存友好的惰性整数发生器
range()用于生成连续或等间距的整数序列。在Python 3中,range是一个不可变序列类型,而非一次性生成所有数字的列表。无论指定的区间规模是10还是1000万,其占用的内存空间保持恒定。
参数构成与步长方向
接受参数形式为range(stop)或range(start, stop[, step])。区间规则为左闭右开区间[start, stop),步长step可为负数用于逆向递减。
# 1. 步长递增与倒序遍历
even_nums = list(range(0, 10, 2))
countdown = list(range(5, 0, -1))

print("偶数序列:", even_nums)
print("倒计时:", countdown)

# 2. 内存占用验证
import sys
small_range = range(0, 10)
huge_range = range(0, 10000000)
print("小范围内存(字节):", sys.getsizeof(small_range))
print("超大范围内存(字节):", sys.getsizeof(huge_range))偶数序列: [0, 2, 4, 6, 8]
倒计时: [5, 4, 3, 2, 1]
小范围内存(字节): 48
超大范围内存(字节): 484. enumerate():消除计数器的人性化索引遍历
在循环过程中同时需要元素本身及其所处下标时,初学者常采用维护外部变量或range(len(seq))间接取值的方式。enumerate()将可迭代对象包装为一个生成元组(index, item)的迭代器,彻底消除了显式索引的冗余代码。
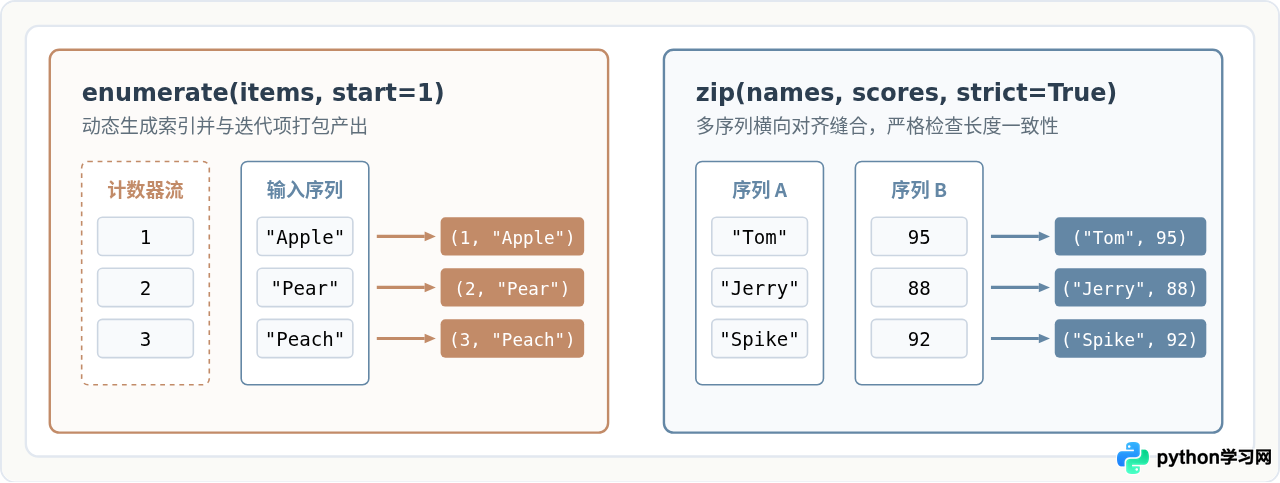
fruits = ["Apple", "Pear", "Peach"]

# 使用 start 参数指定起始编号(适合从 1 开始展示的清单)
for idx, item in enumerate(fruits, start=1):
print(f"序号 {idx}: {item}")序号 1: Apple
序号 2: Pear
序号 3: Peach5. zip():多维序列的并行对齐与字典重组
zip()接受多个可迭代对象作为输入,横向提取各容器相同索引位置的元素组成元组。当需要同时遍历两个或多个相关联的列表时,zip()是最自然、最扁平的解决方案。
长度不匹配与严格模式(strict)
默认情况下,zip()以最短的输入序列为准,多余元素会被默默截断。如果业务逻辑要求各输入序列必须等长,应在Python 3.10+中使用strict=True显式保护,防止静默丢数据。
fields = ["id", "username", "status"]
values = [1024, "developer_chen", "active"]

# 1. 快速构建字典
user_dict = dict(zip(fields, values))
print("组合为字典:", user_dict)

# 2. strict 参数防止长度不一致引发的隐蔽 Bug
try:
    colors = ["red", "green"]
    hex_codes = ["#FF0000", "#00FF00", "#0000FF"]
    pairs = list(zip(colors, hex_codes, strict=True))
except ValueError as err:
print("捕获严格对齐异常:", err)组合为字典: {'id': 1024, 'username': 'developer_chen', 'status': 'active'}
捕获严格对齐异常: zip() argument 2 is longer than argument 16. sorted():安全非破坏性排序与高维键提取
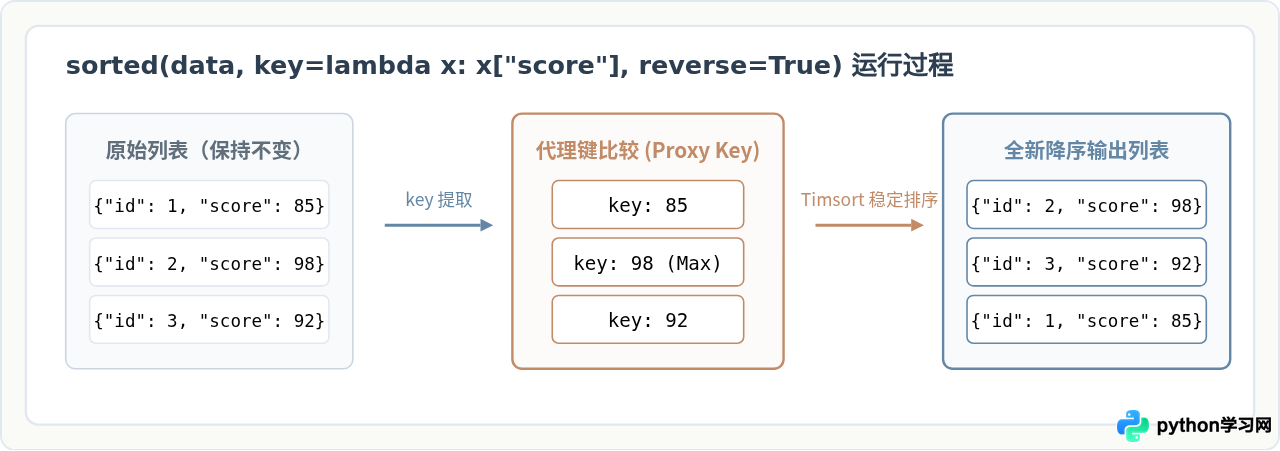
Python提供了两种排序方式:列表独有的原地修改方法list.sort(),以及通用内置函数sorted()。sorted()接收任何可迭代对象,并始终返回一个全新的升序排列列表,保证原始输入不被意外污染。
students = [
    {"name": "Alice", "score": 85, "age": 20},
    {"name": "Bob", "score": 95, "age": 19},
    {"name": "Charlie", "score": 85, "age": 22}
]

# 按分数降序;若分数相同则按年龄升序
sorted_res = sorted(students, key=lambda s: (-s["score"], s["age"]))
for s in sorted_res:
print(f"{s['name']}: 分数 {s['score']}, 年龄 {s['age']}")Bob: 分数 95, 年龄 19
Alice: 分数 85, 年龄 20
Charlie: 分数 85, 年龄 227. isinstance():遵循多态原则的类型安全校验
当需要验证变量类型时,常见误区是使用type(x) == int进行绝对匹配。这种方式无法识别子类继承关系,破坏了面向对象的多态性。isinstance()则是官方推荐的标准类型判断方式。
支持元组多类型联合校验
isinstance(object, classinfo)中,classinfo不仅可以是单一类型,还可以是包含多个类型的元组。只要对象满足其中任意一种类型即返回True。
# 1. 继承体系识别对比
class Animal: pass
class Dog(Animal): pass

snoopy = Dog()
print("type 直接比对:", type(snoopy) == Animal)     # 丢失子类继承信息
print("isinstance 检查:", isinstance(snoopy, Animal)) # 正确识别继承关系

# 2. 联合多类型校验
def parse_payload(val):
    if not isinstance(val, (int, float, str)):
        raise TypeError(f"不支持的输入数据格式: {type(val).__name__}")
    return str(val).strip()

print("数字校验结果:", parse_payload(3.14159))type 直接比对: False
isinstance 检查: True
数字校验结果: 3.141598. map() 与 9. filter():流式数据转换与筛选
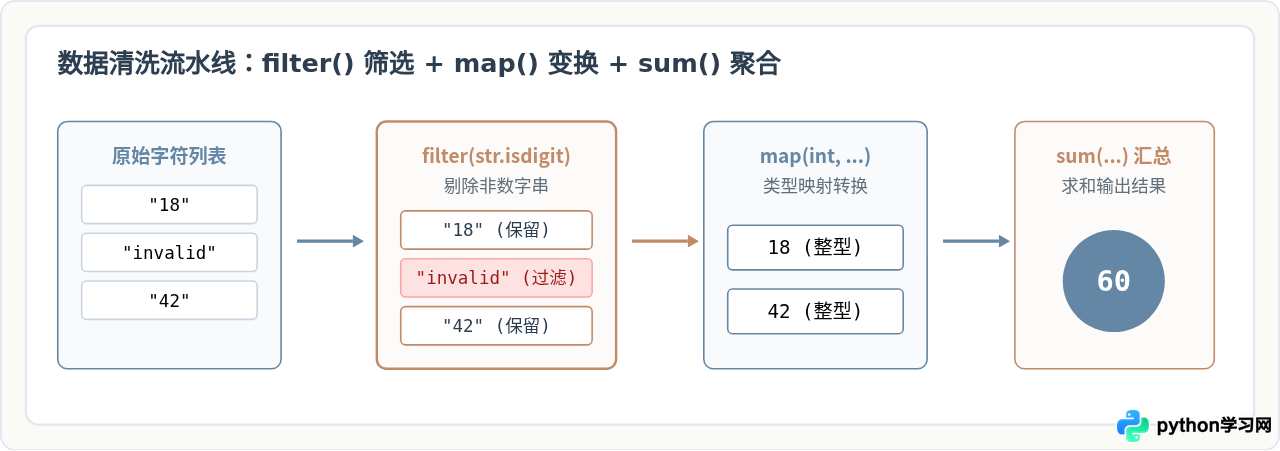
map()与filter()是Python函数式编程的基石。它们接收处理函数并返回惰性迭代器(Iterator),在迭代时按需计算元素,绝不会提前占用内存将所有结果一次性加载出来。
raw_records = [" 15 ", "NaN", "40", "-8", "100"]

# 1. 过滤掉非纯数值字符串
valid_items = filter(lambda s: s.strip().lstrip("-").isdigit(), raw_records)

# 2. 映射为整型
int_values = map(int, valid_items)

# 3. 产生最终计算列表
result = list(int_values)
print("清洗后整数结果:", result)清洗后整数结果: [15, 40, -8, 100]避错提示:map与filter返回的对象是一次性消耗迭代器。遍历一次后其内容即为空,若需多次访问,务必先显式转为list(res)或直接采用列表推导式。
10. sum():高效数值累加与初始基底设定
sum(iterable, /, start=0)用于对可迭代对象中的数值进行累加求和。其计算过程在底层C实现中循环完成,相比于纯Python层面的for x in items: total += x更加精炼且高效。
关键参数 start 的妙用
start参数用于指定累加的基准初始值(默认值为0)。除了针对普通数值进行偏移累加,还可以用来快速合并二维扁平列表或元组。
# 1. 基础累加与带基底计算
daily_expenses = [45.5, 120.0, 32.5]
starting_debt = 500.0
total_debt = sum(daily_expenses, start=starting_debt)
print("合并初始基底的总欠款:", total_debt)

# 2. 扁平化合并二维列表
matrix = [[1, 2], [3, 4], [5, 6]]
flat_list = sum(matrix, [])
print("二维列表合并后:", flat_list)合并初始基底的总欠款: 698.0
二维列表合并后: [1, 2, 3, 4, 5, 6]避错提示:虽然sum()可以通过start=[]连接列表,但其内部每次拼接都会产生新列表,合并超大嵌套列表时时间复杂度为O(n^2)。处理超大数据扁平化时,推荐使用itertools.chain.from_iterable();对字符串拼接则务必使用"".join(seq),sum()严禁用于字符串累加。
10大核心内置函数速查与特性汇总
为了在实际编码中更清晰地选择对应函数,下表从入参类型、返回值机制与复杂度维度对这10个函数进行了系统归纳:
| 函数名 | 主要功能 | 返回值形态 | 时间复杂度 | 核心注意点 |
|---|---|---|---|---|
print() |
标准流输出/调试 | None |
O(k) (k为字符长度) | 可配置sep、end及flush立即刷新 |
len() |
获取容器元素数量 | int |
O(1) (内置容器) | 直接读取底层结构体元数据,效率极高 |
range() |
惰性整数序列 | range 不可变序列 |
O(1) 内存开销 | 左闭右开区间,支持步长方向指定 |
enumerate() |
索引与元素打包 | enumerate 迭代器 |
O(1) 产生单项 | 可通过start自定义计数其实编号 |
zip() |
多序列并行配对 | zip 迭代器 |
O(1) 产生单项 | 默认以最短输入截断;Python 3.10+支持strict=True |
sorted() |
安全稳定升/降序 | 新list列表 |
O(n log n) | 非破坏性排序;key函数支持多层比较规则 |
isinstance() |
类型及继承关系校验 | bool |
O(1) | 支持子类多态判断,第二个参数可传多类型元组 |
map() |
批量函数映射应用 | map 迭代器 |
O(1) 产生单项 | 按需延迟求值;遍历一次即耗尽,不可二次读取 |
filter() |
布尔谓词条件筛选 | filter 迭代器 |
O(1) 产生单项 | 断言函数若传None则直接剔除所有False值 |
sum() |
数值累加与基准计算 | 数值类型 | O(n) | 严禁用于字符串拼接;可通过start指定偏移量 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









