

Python列表排序key参数怎么用:从lambda到自定义函数

在 Python 中,列表的 sort() 方法和全局内置函数 sorted() 均支持一个名为 key 的可选参数。这个参数接收一个“单参数可调用对象”(通常是函数),它不会改变列表中原始元素的结构,而是在排序比较前从每个元素中计算提取出一个“用于排序比对的键值”。无论是简单的单行属性提取(使用 lambda),还是包含分支、容错与加权逻辑的复杂规则(使用标准 def 自定义函数),掌握 key 参数的运作逻辑都是写出高效、清晰 Python 代码的关键基础。
一、key 参数的核心作用机制
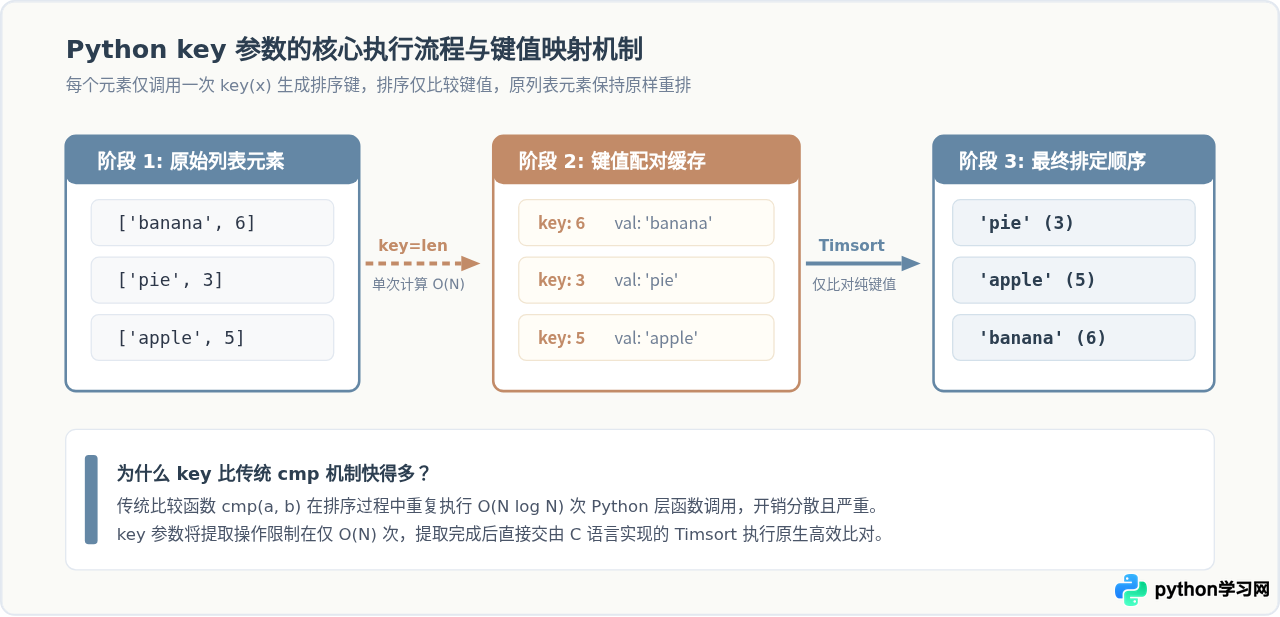
理解 key 参数最关键的一点在于:key 函数只在排序开始时对列表中的每个元素精确调用一次,并产生对应的键值镜像。底层的 Timsort 算法随后仅比较这些生成的键值,排序完成后再映射回原元素输出。这种设计在算法上被称为施瓦茨变换(Schwartzian Transform)。
在早期的 Python 2 中,排序允许传入 cmp(a, b) 双参数比较函数。当列表长度为 N 时,双参数比较函数需要被频繁调用 O(N log N) 次,计算开销巨大。而 Python 3 全面采用的 key 参数方案,只需进行 N 次函数调用提取键,随后直接利用 C 底层极其快速的元组或标量比较,执行效率得到了数量级的提升。
二、最简用法:直接传递内置函数
最直接使用 key 的方式是传递 Python 原生支持的单参数内置函数,如 len、abs 或字符串方法 str.lower。此时无需编写任何额外语句,直接传递函数名对象即可。
# 示例 1: 按绝对值大小对整数排序
numbers = [-15, 3, -2, 8, -20, 1]
# 不传 key 时按数值大小排序:[-20, -15, -2, 1, 3, 8]
sorted_by_abs = sorted(numbers, key=abs)
print("按绝对值排序结果:", sorted_by_abs)
# 输出: [1, -2, 3, 8, -15, -20]

# 示例 2: 忽略大小写的英文字符串排序
words = ["banana", "Apple", "cherry", "Date"]
# 默认排序下大写字母排在前面:['Apple', 'Date', 'banana', 'cherry']
words.sort(key=str.lower)
print("忽略大小写就地排序结果:", words)
# 输出: ['Apple', 'banana', 'cherry', 'Date']
注意区分 list.sort() 与全局函数 sorted():前者属于列表特有的方法,会对原列表进行“就地修改”(In-place modification)且返回值为 None;而后者接收任何可迭代对象,并构建并返回一个全新的排好序的列表。
三、使用 lambda 表达式处理多维属性与多键排序
当列表中包含字典、元组或复杂嵌套对象时,内置函数通常无法直接匹配特定的内层字段。此时,lambda 匿名函数是最常用、最轻量的解决方案。lambda 形式为 lambda 变量: 提取的目标表达式,能在单行内快速定义映射规则。
1. 提取字典字段或对象属性
students = [
    {"name": "张三", "score": 88, "age": 19},
    {"name": "李四", "score": 95, "age": 18},
    {"name": "王五", "score": 72, "age": 20}
]

# 按成绩从高到低排序(配合 reverse=True)
sorted_students = sorted(students, key=lambda s: s["score"], reverse=True)
print("按成绩降序:", [s["name"] for s in sorted_students])
# 输出: ['李四', '张三', '王五']
2. 组合多键排序(利用元组的逐项比对特性)
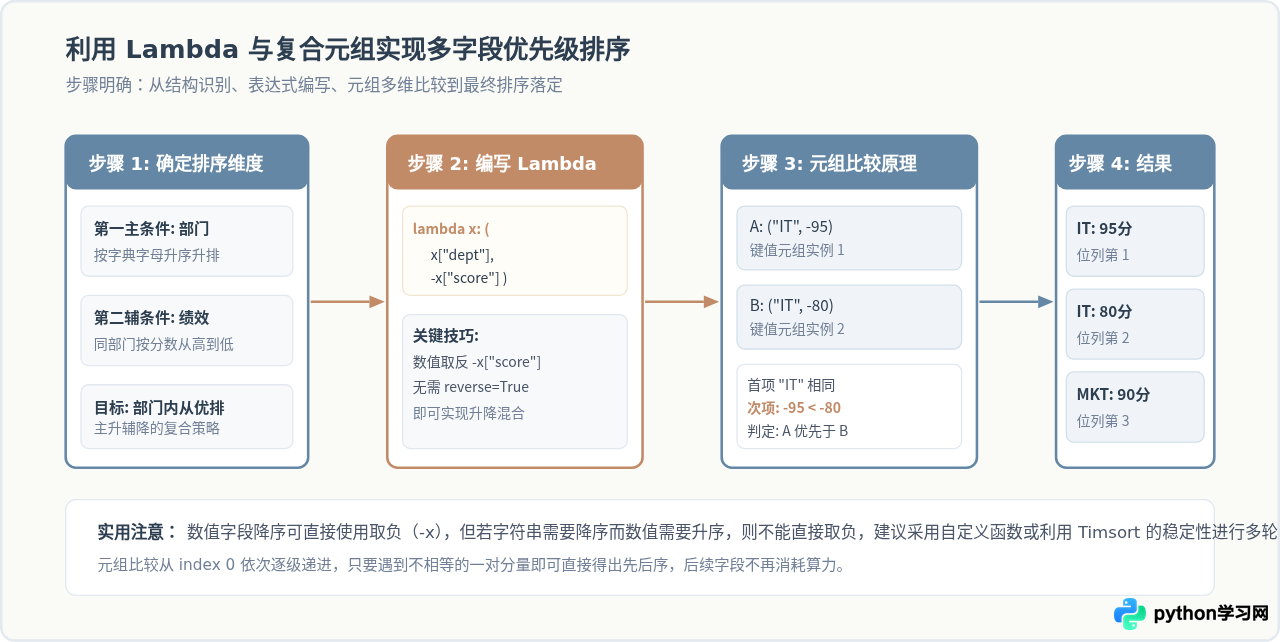
在实际需求中,往往需要“主条件相同则按次条件比对”。Python 中元组的比较规则是:先比较第一个元素,若相等则比较第二个,以此类推。因此,只需让 key 函数返回一个包含多个字段的元组,即可天然实现多级排序。
四、何时必须使用 def 自定义函数
尽管 lambda 极其精简,但在面对工业级项目或真实业务场景时,其单一表达式的限制常常导致代码难以阅读或无法处理异常。在以下三种情况下,应当坚决使用标准 def 语句定义命名函数:
- 存在分支判断(if-else)与异常数据清洗:例如排序字段中混杂有
None空值、空字符串或类型不规整的数据; - 需要复杂的权重映射与分箱运算:例如按业务优先等级(“置顶” > “加急” > “普通”)打分;
- 需要类型注解、文档说明(Docstring)及独立单元测试。
典型场景:安全处理含 None 的混合数据与业务权重排序
在 Python 3 中,尝试对 None 与整数或字符串进行大小比较(如 None < 10)会直接抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int'。要让含有缺失值的列表安全排序,并显式指定 None 排在最前或最后,编写自定义函数是最稳健的做法。
items = [
    {"name": "任务A", "priority": "high", "deadline_days": 3},
    {"name": "任务B", "priority": "low", "deadline_days": None},
    {"name": "任务C", "priority": "medium", "deadline_days": 1},
    {"name": "任务D", "priority": "high", "deadline_days": None},
    {"name": "任务E", "priority": "critical", "deadline_days": 5}
]

# 业务优先级映射字典
PRIORITY_WEIGHT = {
    "critical": 1,
    "high": 2,
    "medium": 3,
    "low": 4
}

def task_sort_key(task):
    """
    排序规则:
    1. 业务优先级(critical 最高,权重数字最小排前面)
    2. 截止剩余天数升序;若为 None 则统一排在同优先级的最后端
    """
    weight = PRIORITY_WEIGHT.get(task["priority"], 99)
    days = task["deadline_days"]

    # 用 (bool, value) 元组将 None 自动归置到最后
    # 当 days 为 None 时,is_none 为 True (即 1);有具体数值时为 False (即 0)
    # 因为 0 < 1,所以具体数值必然排在 None 前面
    is_none = (days is None)
    safe_days = days if not is_none else 0

    return (weight, is_none, safe_days)

# 传入自定义函数名(不要带括号)
items.sort(key=task_sort_key)

for t in items:
    print(f"[{t['priority'].upper():8}] 剩余天数: {str(t['deadline_days']):5} | {t['name']}")
运行上述代码输出结果如下:
[CRITICAL] 剩余天数: 5     | 任务E
[HIGH    ] 剩余天数: 3     | 任务A
[HIGH    ] 剩余天数: None  | 任务D
[MEDIUM  ] 剩余天数: 1     | 任务C
[LOW     ] 剩余天数: None  | 任务B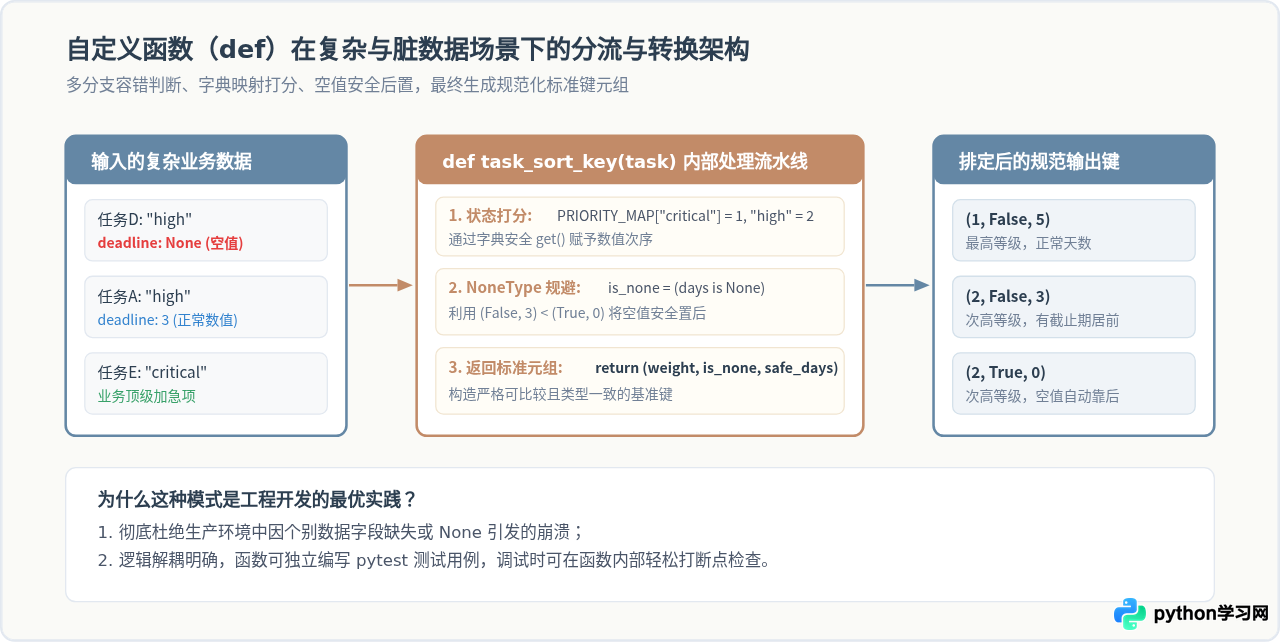
五、性能极致方案:标准库 operator 模块
如果仅仅是提取字典的键或对象的属性,使用 lambda x: x["key"] 虽然方便,但仍会引入一次 Python 字节码层级的函数调用开销。Python 提供了由 C 语言高效实现的 operator 标准库:
operator.itemgetter("key"):等价于lambda x: x["key"],支持索引提取与多键提取,速度提升 20%~35%;operator.attrgetter("attr"):等价于lambda x: x.attr,针对自定义类实例对象的属性访问;operator.methodcaller("method"):等价于lambda x: x.method(),针对需调用无参方法的结果排序。
import operator

users = [
    {"id": 103, "city": "Beijing", "score": 90},
    {"id": 101, "city": "Shanghai", "score": 95},
    {"id": 102, "city": "Beijing", "score": 85}
]

# 单键高效排序
users.sort(key=operator.itemgetter("city"))

# 多键复合排序:先按城市,再按分数
# itemgetter 支持一次传入多个键,返回的本身就是一个复合元组
users.sort(key=operator.itemgetter("city", "score"))
print("operator 复合排序结果:")
for u in users:
    print(u)
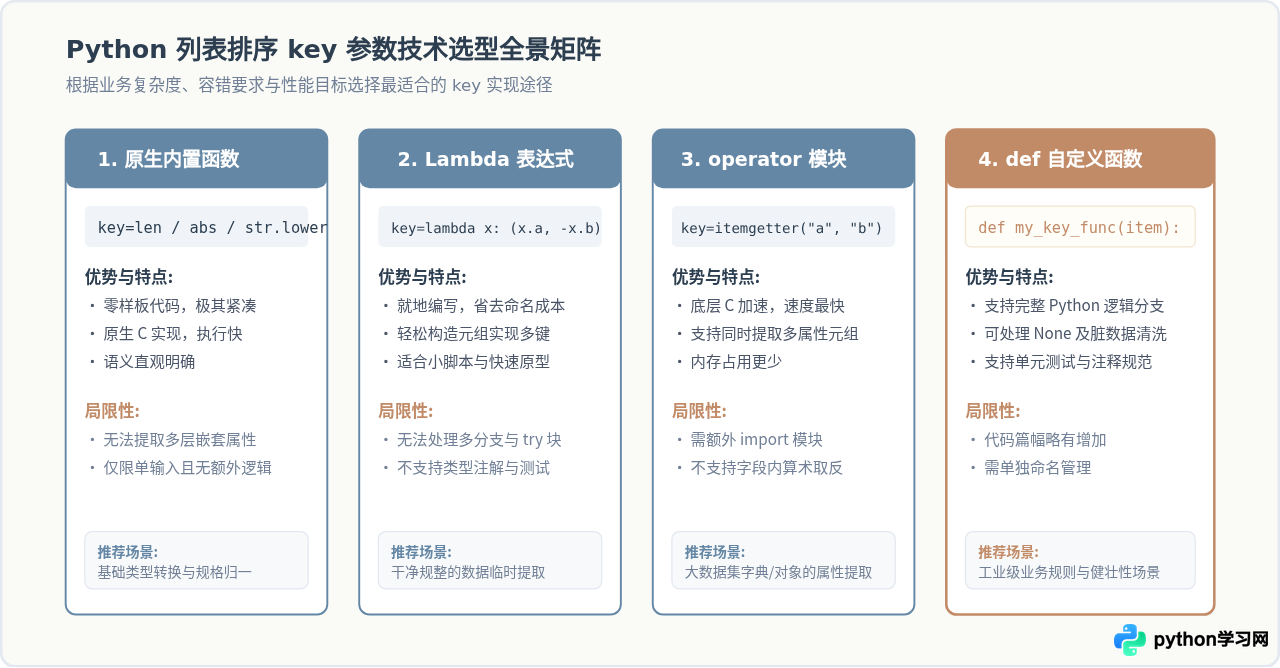
六、四种 key 实现方式的全景选型与对比
在编写排序代码时,选择最贴合实际场景的工具可以兼顾代码运行效率与长期可维护性。以下是四种常见方案的对比矩阵:
七、核心避坑指南与使用注意事项
关键点 1:传递函数本身,切勿加括号执行
初学者极易犯的一个错误是在 key= 后面写成 key=len() 或 key=my_func(x)。加了括号意味着在调用排序前立即执行该函数并将其返回值传给 key,这会直接抛出 TypeError。正确的写法是传递函数对象本身:key=len 或 key=my_func。
关键点 2:key 函数只接受单个参数
key 接收的函数在底层被循环调用时,每次只会被传入列表中的一个元素 x。如果定义的函数需要两个及以上必填参数,必须使用默认参数、functools.partial 或闭包将其封装为单参数函数。
关键点 3:利用 Timsort 的“稳定性”实现异构排序
Python 自带的排序算法 Timsort 具有严格稳定性(Stable Sort):若两个元素的键值相同,排序后它们原有的相对先后次序绝对不会发生改变。当你想实现“主条件升序、次条件降序”,且次条件是无法简单取负的字符串时,可以通过多次单字段排序(先排次要条件,再排主要条件)优雅解决:
# 示例:先按次条件(name降序)排序,再按主条件(age升序)排序
users = [("Alice", 25), ("Bob", 20), ("Charlie", 25), ("David", 20)]

# 第一轮:按姓名降序
users.sort(key=lambda u: u[0], reverse=True)
# 第二轮:按年龄升序(利用稳定排序特性,同年龄项保留上一轮的名字降序关系)
users.sort(key=lambda u: u[1])

print("多轮稳定排序最终结果:", users)
# 输出: [('David', 20), ('Bob', 20), ('Charlie', 25), ('Alice', 25)]
八、总结
掌握 Python 列表的 key 参数不仅是掌握一项语法糖,更是理解 Pythonic 编程思维与高效算法设计的重要体现。在日常开发中:
- 对于字符串大小写、绝对值、长度等单值转换,直接使用原生内置函数;
- 对于简单的数据提取与轻量多维元组组合,使用
lambda表达式能够大幅提高编码速度; - 对于高并发、大数据量字典属性提取,优先引入
operator.itemgetter榨干 C 底层性能; - 对于包含
None容错、业务规则映射及工程化模块,定义正规的def函数是确保系统健壮性与可维护性的最佳保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









