

除了列表,Python还有哪些序列类型?
深入解析Python除了列表(list)之外的核心序列类型,涵盖元组tuple、字符串str、整数范围range、二进制字节bytes与bytearray、内存视图memoryview及双端队列deque的原理、内存机制与选型实践。
在日常开发中,许多初学者习惯把所有集合数据都放进 list。然而,当面对需要防止被意外修改的业务记录、吞吐量敏感的高频网络二进制协议、或者上千万条惰性计算的循环范围时,盲目使用列表不仅会造成明显的内存浪费,还可能因引用的可变性引发静默数据 Bug。Python 标准库根据数据可变性、存储紧凑度以及特定算法需求,内置了层次丰富、各有专长的序列类型家族。
一、重新认识序列:到底什么是“序列”(Sequence)?
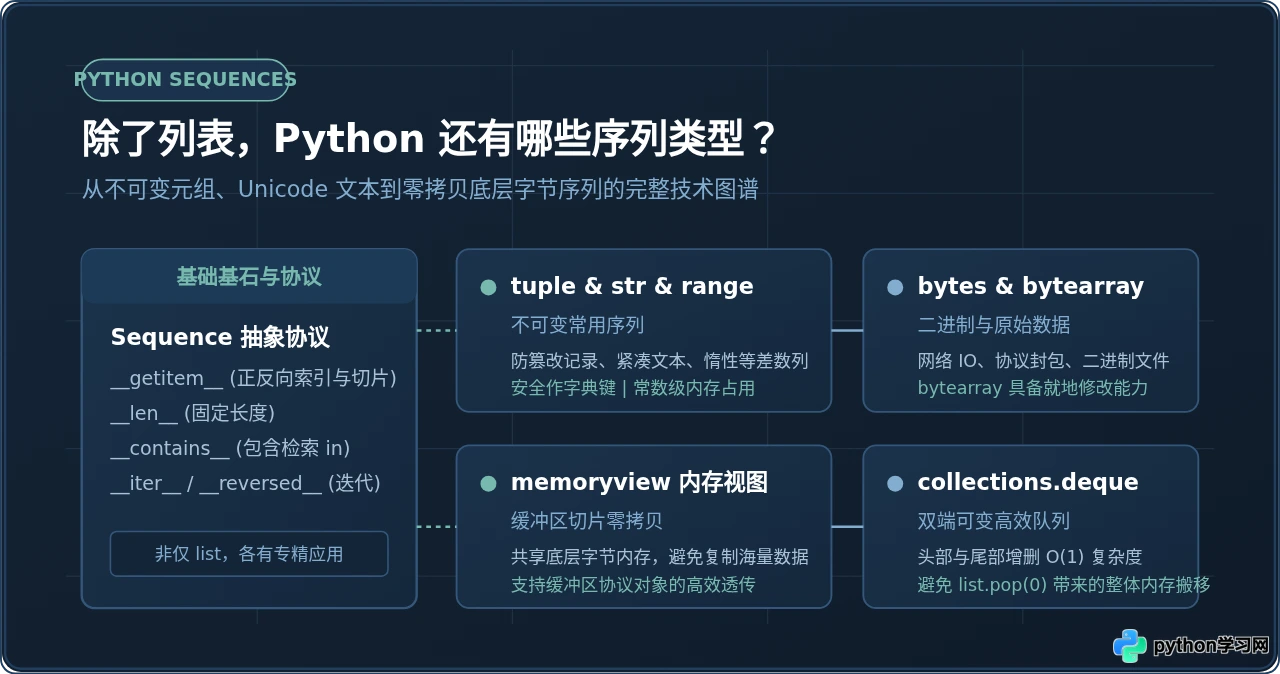
在深入各类序列之前,我们首先需要理解 Python 中“序列”的本质界定。Python 并不是单纯以继承层级来粗暴划分数据类型的,而是遵循典型的协议(Protocol)设计。一个对象只要实现了 Python 序列协议所约定的核心方法,它在行为上就是一种序列。
根据标准库 collections.abc.Sequence 的抽象约定,一个合法的序列必须支持以下核心操作:
- 基于整数的下标索引(Indexing)与切片(Slicing):实现
__getitem__方法,支持正向下标s[0]、负向下标s[-1]以及步长切片s[1:5:2]。 - 获取固定长度:实现
__len__方法,能够通过内置函数len(s)在 \(O(1)\) 时间内直接返回元素总个数。 - 成员归属测试:支持
x in s语法(通过__contains__或依托迭代回退)。 - 双向顺序迭代与查找:支持
for item in s正向遍历,支持reversed(s)逆向遍历,并提供s.index(x)和s.count(x)方法。
字典(dict)与集合(set)虽然也是可迭代的容器,但集合不具备确定下标,字典虽在 Python 3.7+ 保持插入顺序,但它的键是任意可哈希对象而非整数序号,不支持切片操作,因此它们属于映射(Mapping)和集合(Set)协议,而不是序列(Sequence)。
二、不可变通用容器:元组(tuple)
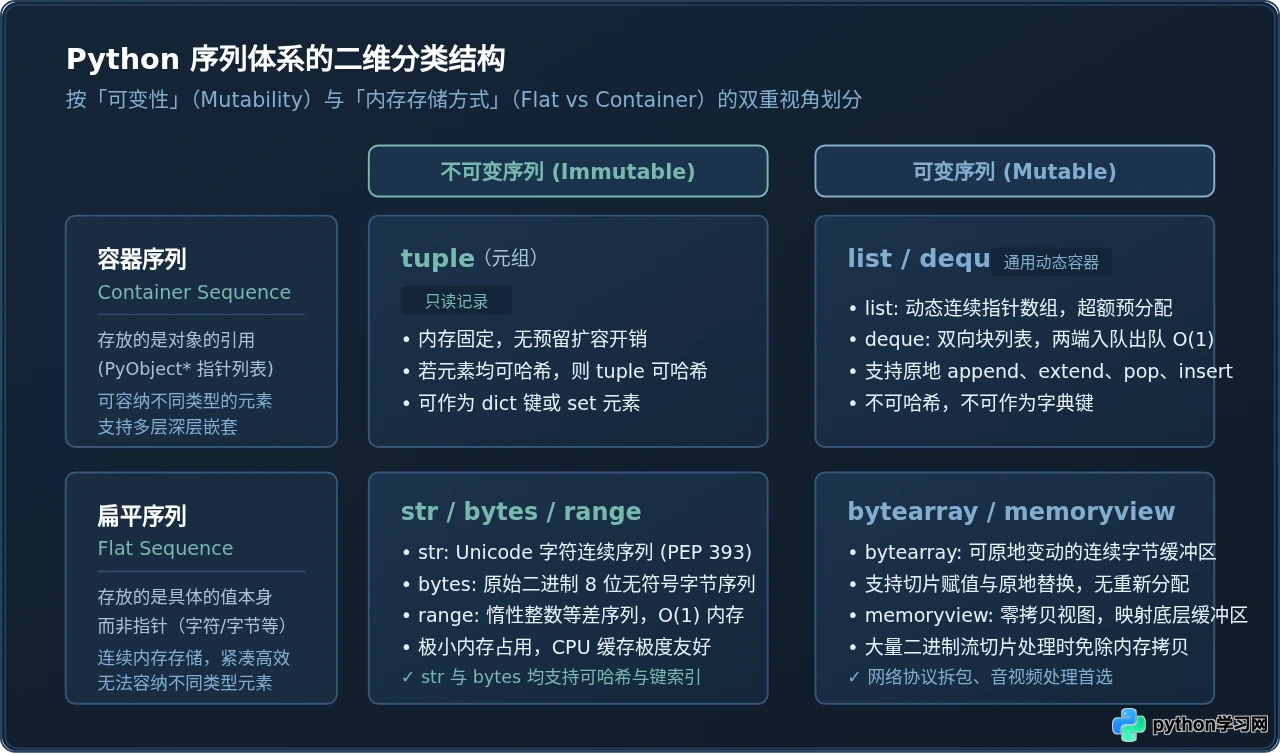
很多开发者容易将元组简单理解为“不能改的列表”。这种理解虽然抓住了不可变(Immutable)的表象,却忽略了元组在语言设计中的真正定位——没有字段名的结构化记录(Record)。
1. 元组与列表的核心差异
列表通常用于表示同质数据构成的动态集合(例如用户 ID 列表 [101, 102, 103],列表长度随时会增删变化);而元组则用于表示异质数据构成的固定记录,元组中每个位置的元素都具有明确的业务语义。
# 业务示例:经纬度坐标与用户信息记录
coord = (116.4074, 39.9042)  # (经度, 纬度) 固定几何记录
user_record = ("zhang_san", 28, "dev@example.com")  # 固定三元组记录

# 元组解包(Unpacking)具有极佳的可读性
name, age, email = user_record
print(f"用户: {name}, 年龄: {age}")
2. 为什么在只读场景优先使用 tuple?
- 防御性编程(Data Integrity):一旦函数返回或传入一个元组,调用方无法在其内部调用
append()或执行下标替换,从根源上杜绝了隐蔽的副作用。 - 支持哈希,可作为字典键:如果一个元组内包含的所有元素全部都是不可变的,那么该元组本身就是可哈希的(Hashable),可以直接作为
dict的键或存入set;而list绝不可能作为字典键。 - 极佳的内存紧凑度与垃圾回收效率:
list为了应对频繁追加,必须维护超额预分配(Over-allocation)机制,而tuple长度在初始化时即固定,没有任何扩容内存浪费。此外,CPython 对小元组有内存池缓存复用机制,分配销毁比列表更轻量。
# 示例:以坐标元组作为字典键进行空间网格查找
spatial_index = {}
spatial_index[(10, 20)] = "基站 A"
spatial_index[(10, 21)] = "基站 B"
print(spatial_index[(10, 20)])  # 正常输出:基站 A

# 若换成列表作为 key 则会直接触发 TypeError: unhashable type: 'list'
三、内置扁平不可变序列:字符串(str)与范围(range)
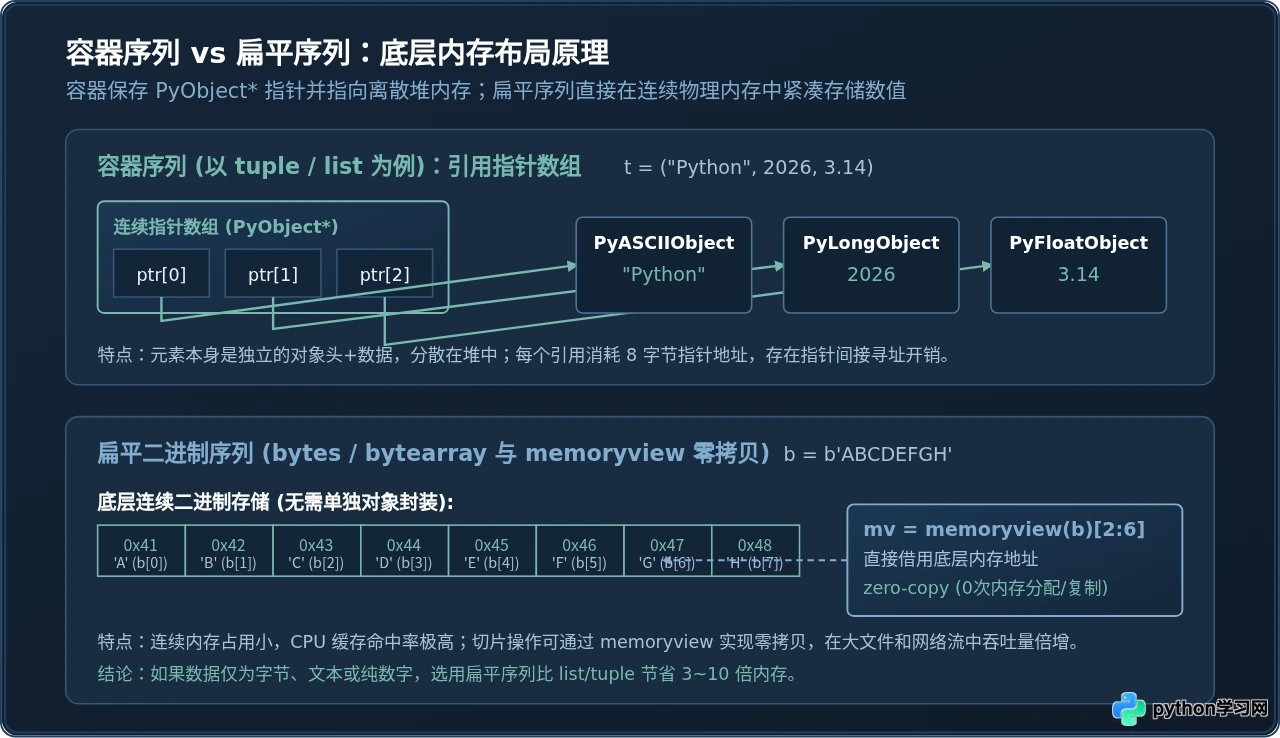
除了存放对象引用的容器序列,Python 中另一大类关键序列是扁平序列(Flat Sequence)。扁平序列直接在连续物理内存中存储基础值,其结构与行为非常契合特定计算任务。
1. 字符串(str):不可变的 Unicode 字符序列
在 Python 3 中,str 是标准的不可变 Unicode 码点序列。初学者常常只把它当作文本对待,但从序列角度看,它支持全部标准的序列下标与切片行为:
text = "Python序列核心解析"
print(text[0])       # 'P' - 按字符下标定位
print(text[::-1])    # '析解心核列序nohtyP' - 切片反向翻转
print("核心" in text) # True - 序列包含判定
底层机制上,自 Python 3.3(PEP 393)起,CPython 实现了灵活字符串表示(Flexible String Representation)。根据字符串内最大码点的不同,底层会自动选用 1 字节(Latin-1)、2 字节(UCS-2)或 4 字节(UCS-4)连续存储,既保证了 \(O(1)\) 按索引准确定位字符,又最大限度压缩了内存占用。
2. 范围对象(range):极度高效的等差整数序列
range 是一个常常被误认为是生成器的内置不可变序列类型。它完整实现了 Sequence 协议,具备索引、切片、包含判断和长度计算能力:
r = range(0, 1000000000, 3)  # 0 到 10 亿、步长为 3 的范围序列
print(len(r))         # 333333334 - 瞬时返回,时间复杂度 O(1)
print(r[5])           # 15 - 瞬间按公式算得,时间复杂度 O(1)
print(999 in r)       # True - 通过算术边界计算,时间复杂度 O(1)无需遍历
print(r[10:20])       # range(30, 60, 3) - 切片产出新的 range 对象
关键优势在于:常数级 \(O(1)\) 空间复杂度。无论范围跨越 10 个数字还是 10 亿个数字,一个 range 对象在 64 位系统上始终只占用约 48 字节内存,因为它只需记录 start、stop 和 step 三个属性,所有元素值都是按需计算出来的。
四、二进制序列家族:bytes、bytearray 与 memoryview
当处理网络套接字(Socket)、磁盘文件读写、图像像素处理或硬件协议交互时,我们面对的不再是高级文本,而是连续的原生 8 位字节(0 ~ 255)。针对这一领域,Python 提供了强大的二进制序列组合拳。
1. bytes:不可变字节序列
bytes 可以看作是只读的无符号字符数组,每个元素都是 0 <= x < 256 的整数。它具备不可变性与可哈希性,是网络数据交换的基础载体。
# 创建不可变字节序列
raw_packet = b"ª Hello"
print(raw_packet[0])  # 170 (即 0xAA)
print(raw_packet[4:]) # b'Hello'
# raw_packet[0] = 0xBB  # 会抛出 TypeError: 'bytes' object does not support item assignment
2. bytearray:可变字节序列
如果需要对接收到的二进制数据进行原地拼接、掩码变换或局部修改,使用 bytes 会因为反复生成新对象而造成大量内存分配。此时,应当使用可变字节序列 bytearray:
# 构建可变二进制缓冲区
buf = bytearray(b"    ")
buf[0] = 0xFF       # 原地修改单个字节
buf.extend(b"")  # 原地追加
buf[1:3] = b"ª»"   # 原地切片赋值替换
print(buf.hex())    # 输出: ffaabb000102
3. memoryview:零拷贝(Zero-Copy)内存视图
在处理大型二进制文件或网络吞吐时,传统切片 data[offset:offset+chunk_size] 每次都会在堆上复制出一段全新的 bytes 副本。如果一个文件有 500MB,切片 100 次就会额外复制出数十 GB 的瞬时内存垃圾,导致 GC 频繁卡顿。
内置的 memoryview 序列类型依托 Python 缓冲区协议(Buffer Protocol),允许你在完全不发生内存复制的前提下,直接对外暴露底层对象的内存指针与切片视图:
# 模拟从 Socket 接收的大缓冲区
payload = bytearray(1024 * 1024)  # 1MB 缓冲区
mv = memoryview(payload)

# 切片生成子视图,耗时为 O(1),无任何内存分配复制
chunk = mv[100:200]
print(len(chunk))  # 100 字节

# 可以直接通过可变视图原地覆写原始 payload 的内存
chunk[0:4] = b"SYNC"
print(payload[100:104])  # 输出: bytearray(b'SYNC'),底层已被直接改写!
mv.release()             # 显式释放视图关联
五、标准库专用序列:双端队列(collections.deque)
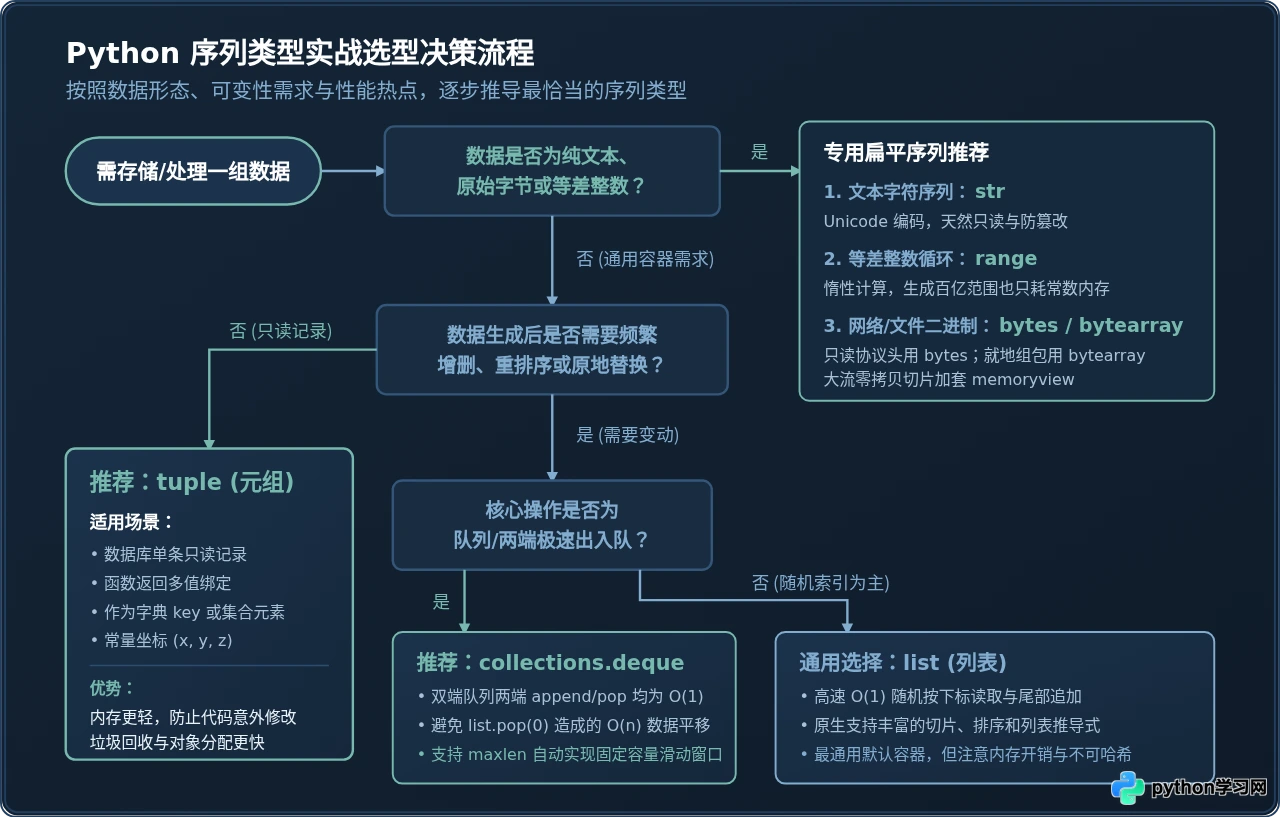
很多开发者在实现“先进先出”(FIFO)队列或任务调度时,顺手使用 list.pop(0) 来取出队首元素。这是一个隐蔽的性能陷阱:由于列表底层是连续指针数组,弹出第 0 个元素会导致其后所有元素全部向左平移 1 个位置,时间复杂度高达 \(O(n)\)。
标准库 collections.deque(双端队列)是专门为两端快速追加与弹出设计的序列类型,其两端操作的时间复杂度均为 \(O(1)\):
from collections import deque

# 初始化并创建具有最大容量的滑动窗口队列
recent_logs = deque(maxlen=3)
recent_logs.append("Log 1")
recent_logs.append("Log 2")
recent_logs.append("Log 3")
print(recent_logs)  # deque(['Log 1', 'Log 2', 'Log 3'], maxlen=3)

# 再次追加时,最老的数据会自动从对侧静默挤出
recent_logs.append("Log 4")
print(recent_logs)  # deque(['Log 2', 'Log 3', 'Log 4'], maxlen=3)

# 极速首尾操作
recent_logs.appendleft("Header")  # O(1) 头部推入
item = recent_logs.popleft()      # O(1) 头部弹出,毫无内存整体移动开销
deque 在两端的 append 和 pop 性能极高,但它内部由双向块链表构成。如果要频繁按中间下标随机读取(如 q[5000]),需要遍历链表块,平均耗时为 \(O(n)\)。对于以随机索引为核心的场景,应坚定使用 list。
六、序列协议实战:如何编写符合 Sequence 规范的自定义类?
在面向对象编程中,我们经常需要让自定义的数据结构具备类似序列的自然语法。Python 倡导的鸭子类型(Duck Typing)意味着,我们甚至无需显式继承父类,只要实现关键魔术方法即可享受 Python 序列的所有切片和迭代红利。
from collections.abc import Sequence

class StepSeries(Sequence):
    """自定义等比步长数值序列:只读、惰性、O(1) 内存"""
    def __init__(self, base, ratio, count):
        self.base = base
        self.ratio = ratio
        self.count = count

    def __len__(self):
        return self.count

    def __getitem__(self, index):
        # 支持正负下标与切片
        if isinstance(index, slice):
            return [self[i] for i in range(*index.indices(self.count))]
        if index < 0:
            index += self.count
        if index < 0 or index >= self.count:
            raise IndexError("序列下标越界")
        return self.base * (self.ratio ** index)

# 实际测试验证
s = StepSeries(base=2, ratio=3, count=5)
print(len(s))         # 5
print(s[0], s[1])     # 2, 6
print(s[-1])          # 162 (2 * 3^4)
print(s[1:4])         # [6, 18, 54]
print(54 in s)        # True - 自动继承来自 Sequence 的 __contains__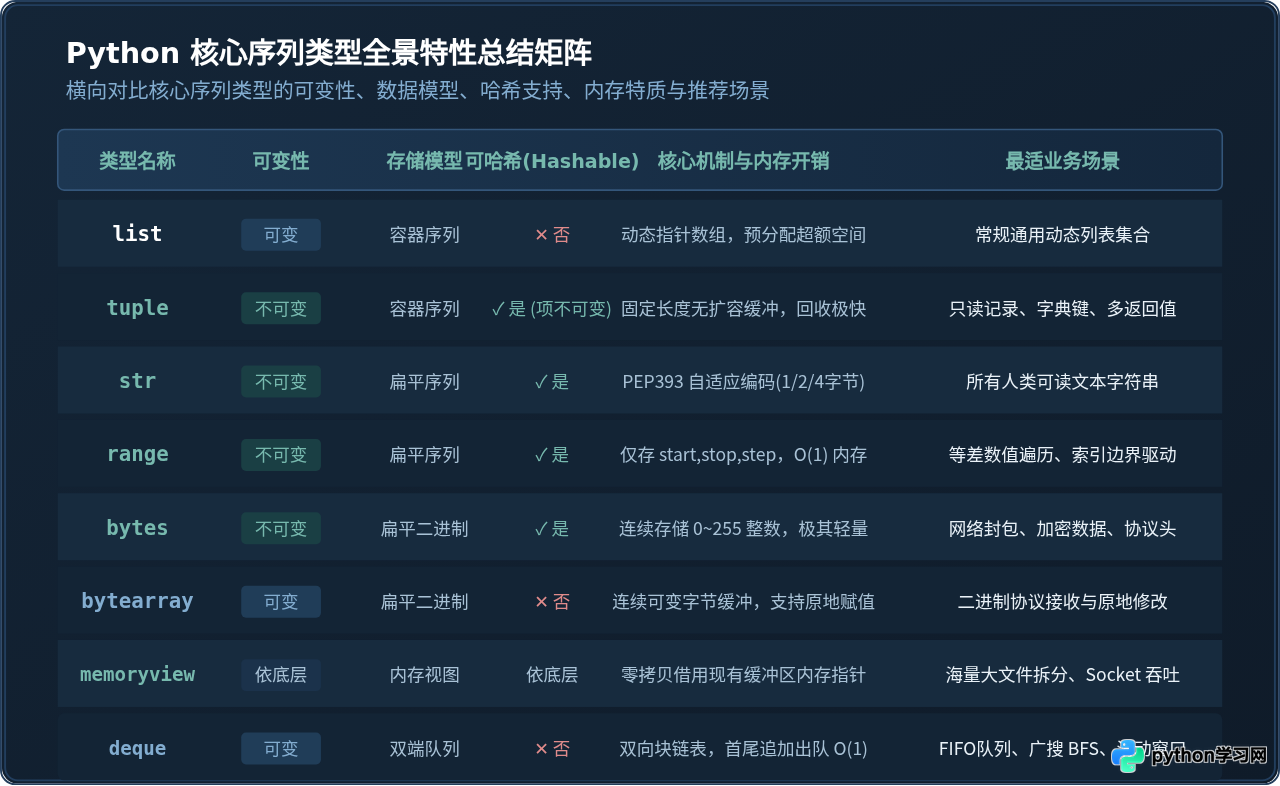
七、常见陷阱与工程最佳实践
在充分掌握各类序列后,日常工程落地中仍需特别警惕以下两个典型陷阱:
1. 陷阱一:元组内包含可变对象带来的“虚假不可变”
元组本身的不可变性指的是其持有的指针引用地址不可改变,并不意味着指针所指向的堆对象内部数据不可变。
bad_tuple = (1, [10, 20])
# bad_tuple[0] = 2  # 报错:元组不可修改
bad_tuple[1].append(30)  # 合法!列表内部状态被改变了
print(bad_tuple)         # 输出: (1, [10, 20, 30])

# 后果:该元组无法被哈希,尝试 hash(bad_tuple) 会立即抛出 TypeError防范建议:如果需要保证元组的可哈希性与真正的绝对不可变,务必确保元组内的每一级成员均是不可变类型(如数值、字符串、纯元组)。
2. 陷阱二:循环中用 += 拼接不可变序列
对于 str 和 bytes 这类不可变扁平序列,在循环中使用 += 拼接会导致每次循环都在内存中开辟新空间并复制过往全部内容,导致时间复杂度劣化至二次方 \(O(n^2)\)。
正确姿势:累积在列表后通过 "".join(str_list) 或 b"".join(bytes_list) 一次性聚合,或者在组包过程中全程使用 bytearray 原地扩增。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









