

Python原生列表怎么实现点乘(不依赖NumPy)
详细讲解在不依赖NumPy第三方库的环境下,如何利用Python原生列表、zip()函数与生成器表达式高效安全地实现向量点乘。深入剖析生成器与列表推导式的内存差异,提供长度防错校验及二维矩阵乘法扩展。
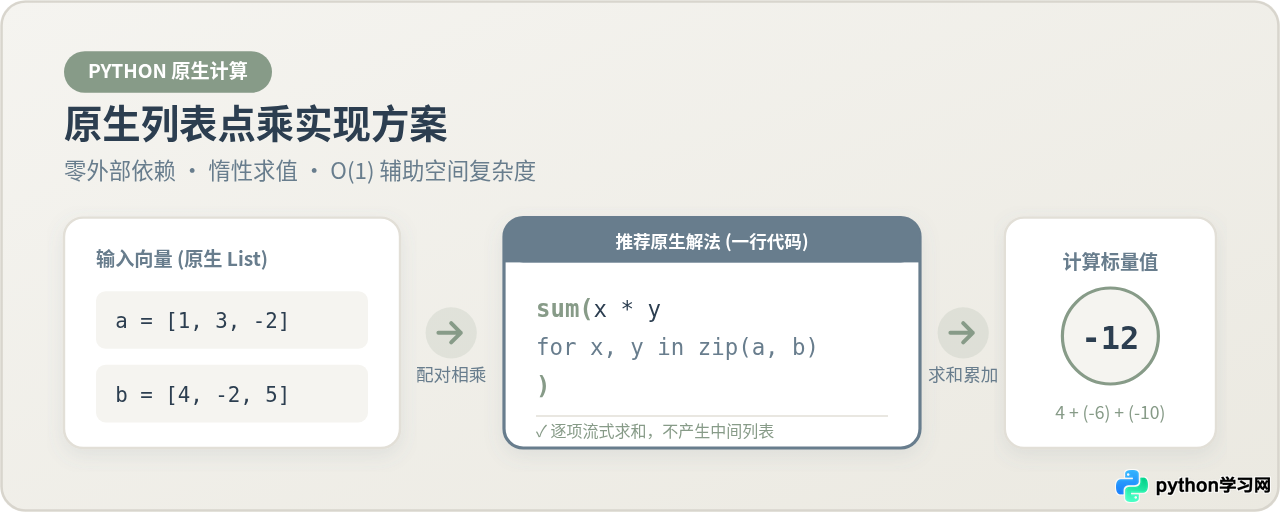
sum() 函数与 zip() 迭代器:sum(x * y for x, y in zip(a, b))。这种方式利用生成器表达式进行逐项相乘与流式累加,既保持了纯原生 Python 代码的简洁可读,又避免了额外创建中间列表的内存开销。本文将从数学原理与数据流拆解切入,详细对比不同实现手法的关键差异,并提供长度对齐校验与多维矩阵扩展的实用解决方案。
一、点乘的数学逻辑与原生实现路径
在代数学中,两个等长一维向量的点乘(Dot Product,又称数量积或内积)被定义为对应分量乘积的代数累加和。设向量 a 与向量 b 均包含 n 个元素,其数学公式为:
a · b = a[0]*b[0] + a[1]*b[1] + ··· + a[n-1]*b[n-1] = ∑ (a[i] × b[i])
点乘的最终产物是一个单一标量(数值),而不是新的序列。在原生 Python 中,实现这一过程需要完成两个核心环节:
- 按索引配对:将两个列表中相同下标位置的元素一一结对。原生内置函数
zip()正是用于并行动行遍历的理想工具。 - 求和聚合:将每对元素的乘积进行累加。内置的
sum()函数能够以极高的 C 语言底层速度遍历任何可迭代对象。
将上述两个环节通过生成器表达式组合,便构成了最经典的纯原生一行解法:
def dot_product(a: list, b: list) -> float:
    """使用原生列表计算两个一维向量的点乘"""
    return sum(x * y for x, y in zip(a, b))

# 示例数据
vec_a = [1, 3, -2]
vec_b = [4, -2, 5]

result = dot_product(vec_a, vec_b)
print("计算结果:", result)计算结果: -12
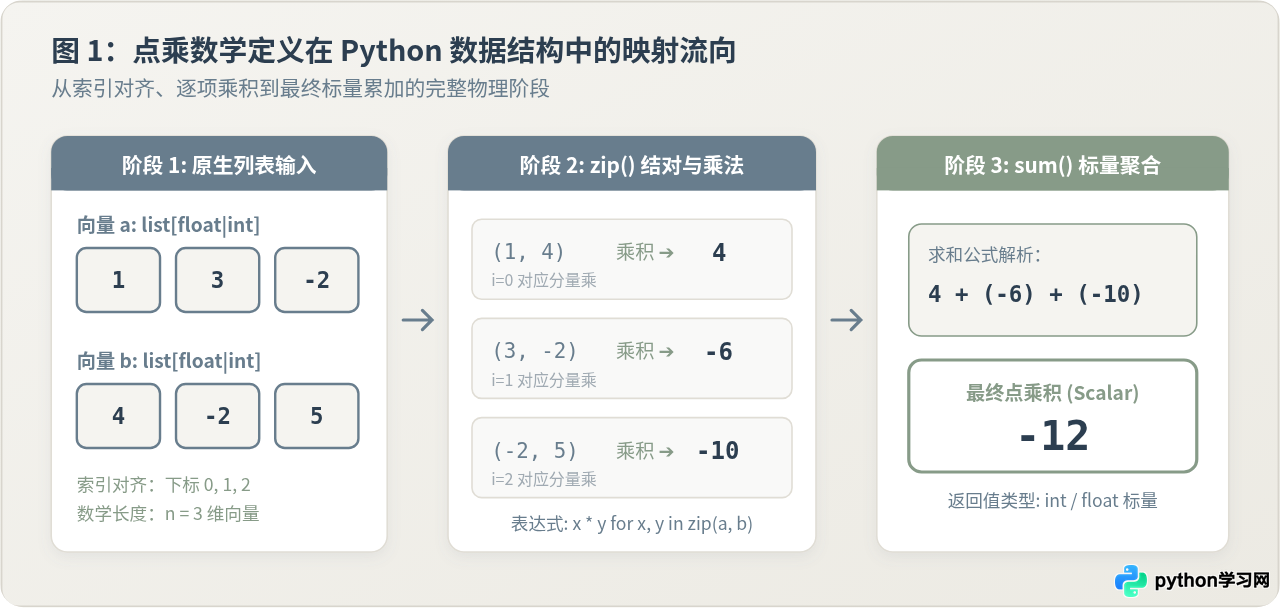
在此示例中,运算过程严格对应:1 * 4 + 3 * (-2) + (-2) * 5 = 4 - 6 - 10 = -12。为清晰呈现数据在内存与迭代器中的流动路径,下图拆解了该计算的全部物理阶段。
二、关键差异解析:生成器表达式 vs 列表推导式
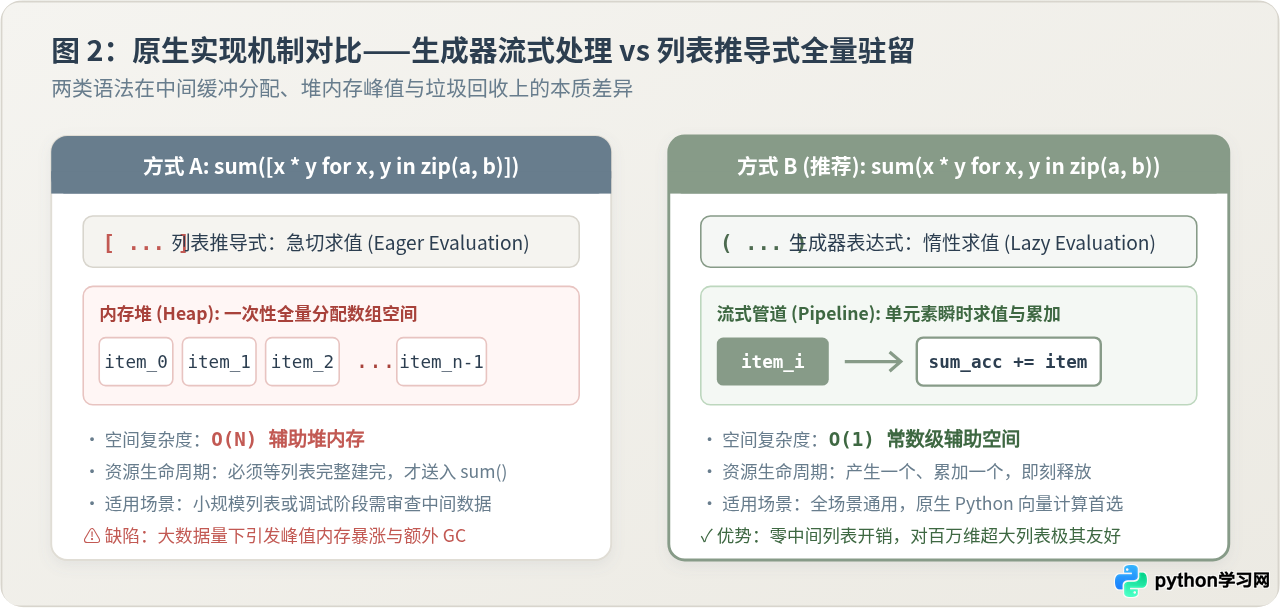
许多开发者在书写原生点乘时,会习惯性地写成列表推导式外包 sum():sum([x * y for x, y in zip(a, b)])。表面上看,这与生成器表达式 sum(x * y for x, y in zip(a, b)) 仅有一对中括号 [] 的差别,两者返回的数值结果也完全一致。然而,在底层执行机制、内存驻留模型与资源生命周期上,两者存在根本性的不同。
1. 关键差异:急切求值与流式管道的内存模型
-
列表推导式(急切求值 Eager Evaluation):
当执行
[x * y for x, y in zip(a, b)]时,Python 会在堆内存中立即开辟一块连续内存,完整生成并容纳所有乘积元素的新列表。等这个包含了 N 个元素的列表在内存中完全落定后,才交给sum()进行累加遍历。累加完毕后,该中间临时列表成为无用垃圾,等待垃圾回收器(GC)回收。其辅助空间复杂度为 O(N)。 -
生成器表达式(惰性求值 Lazy Evaluation):
省略括号直接传入
sum()的写法是一个生成器对象(Generator Object)。它不会预先开辟空间存储结果,而是构建了一个流式管道。sum()每向生成器要一个数,生成器才从zip中取出一组(x, y),计算一次乘积并立即交付给sum()累加,随后该临时数值立即释放。其辅助空间复杂度为严格的 O(1)。
2. 为什么这一差异非常重要?
很多开发者认为在向量维度较小(如 3 维坐标系)时,二者运行差异仅在微秒级别,但这并不意味着可以忽视写法的差异。在没有 NumPy 的轻量级容器、嵌入式环境或大规模特征向量分析场景中:
- 峰值内存开销:如果两个向量的长度达到数百万,列表推导式将凭空分配数兆甚至数十兆的临时列表。这种突发性的内存申请在并发请求下极易造成内存颠簸(Memory Spikes)。
- GC 压力与缓存命中:频繁创建大尺寸的瞬时临时对象会加剧 Python 垃圾回收子系统的遍历开销。生成器表达式保持单个浮点数的就地寄存器与累加更新,对 CPU 缓存极为友好。
| 评估维度 | 列表推导式:sum([...]) |
生成器表达式:sum(...) [推荐] |
关键差异影响 |
|---|---|---|---|
| 辅助空间复杂度 | O(N)(需存储全部中间乘积) | O(1)(常数级流式累加) | 大数据量下生成器不会引发内存激增 |
| 数据处理模式 | 全量装载、两遍扫描(构建+求和) | 单遍流式处理、边算边加 | 生成器流水线减少中间状态存储 |
| 垃圾回收负担 | 高(需销毁中间临时列表) | 极低(单变量生命周期极短) | 高频循环调用时生成器整体系统更稳健 |
| 代码简洁度 | 多一对方括号 [] |
语法地道,直接外借 sum 括号 | 生成器是 Python 社区公认的推荐惯用写法 |
三、容错与安全边界:向量维度的严格校验
在数学理论上,点乘运算仅在两个向量维度(长度)完全相同时成立。如果两个列表长度不等,数学上属于未定义操作。
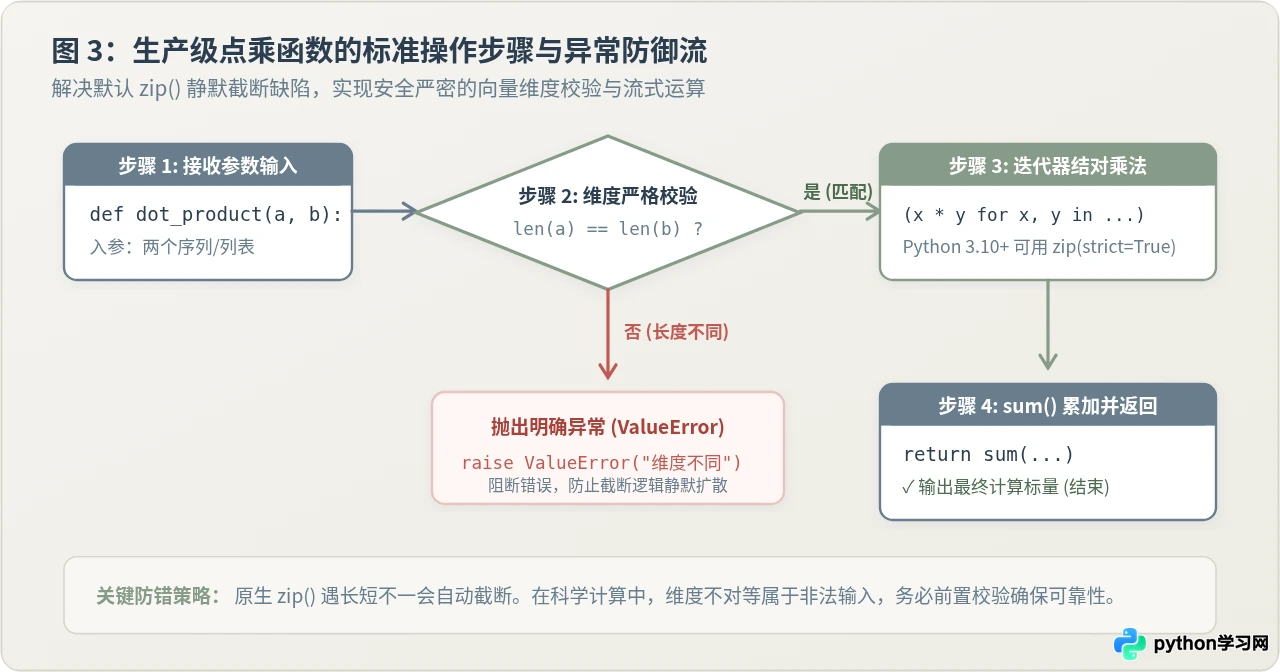
但在原生 Python 中,内置的 zip(a, b) 有一个默认行为特性:短板截断。当传入两个长度不等的迭代器时,zip() 会在较短者耗尽后静默停止迭代,并丢弃较长列表中的后续元素:
# 长度不一致的隐患示例
a = [1, 2, 3, 100]  # 4 维向量
b = [1, 2, 3]       # 3 维向量

# 默认 zip 会静默忽略元素 100
print(list(zip(a, b)))
# 输出: [(1, 1), (2, 2), (3, 3)]
# 点乘结果将错误地计算为 14,而未产生任何报错!生产级健壮点乘函数的标准实现
根据实际工程中运行的 Python 版本,有两种标准的防御方式:
- Python 3.10 及以上版本:直接启用
zip()内置的strict=True参数。当迭代器长度不一致时,Python 解释器会自动抛出ValueError。 - 通用跨版本(兼容 Python 3.6 - 3.9):在函数入口显式检查
len(a) != len(b)。
def safe_dot_product(a: list, b: list) -> float:
    """
    具备维度严格检查的安全点乘函数
    """
    # 方式一:显式长度对比(全版本兼容)
    if len(a) != len(b):
        raise ValueError(f"向量维度不匹配: a 长度为 {len(a)}, b 长度为 {len(b)}")

    return sum(x * y for x, y in zip(a, b))

    # 方式二:Python 3.10+ 原生语法糖(极简)
    # return sum(x * y for x, y in zip(a, b, strict=True))

# 正常调用测试
print("匹配测试:", safe_dot_product([2, 4], [3, 5]))

# 异常调用测试
try:
    safe_dot_product([1, 2, 3], [1, 2])
except ValueError as err:
print("捕获预期异常:", err)匹配测试: 26
捕获预期异常: 向量维度不匹配: a 长度为 3, b 长度为 2
四、场景扩展:从一维向量到二维矩阵点乘
掌握了一维向量点乘后,常遇到的进一步需求是:在没有 NumPy 的情况下,如何使用原生列表完成两个二维矩阵的点乘(矩阵乘法)?
设矩阵 A 大小为 M × K,矩阵 B 大小为 K × N。两者的矩阵乘积 C = A × B 大小为 M × N。矩阵乘法的本质规则,正是结果矩阵中的每一个元素 C[i][j],等于矩阵 A 的第 i 行向量与矩阵 B 的第 j 列向量的点乘。
在原生 Python 嵌套列表中,提取行向量极其简单(直接就是 A[i]),但提取列向量相对麻烦。此时,可以借助 zip(*B) 这一地道的 Python 技巧优雅地实现矩阵转置:
def matrix_dot_product(A: list[list], B: list[list]) -> list[list]:
    """
    使用原生列表实现二维矩阵乘法
    A 尺寸: M 行 K 列; B 尺寸: K 行 N 列
    """
    # 基础维度校验
    if not A or not B:
        return []
    if len(A[0]) != len(B):
        raise ValueError(f"无法相乘:A 的列数 ({len(A[0])}) 与 B 的行数 ({len(B)}) 不相等")

    # zip(*B) 巧妙将矩阵 B 的列转化为行(矩阵转置)
    B_transposed = list(zip(*B))

    # 嵌套推导式:对每一行和每一列复用一维点乘逻辑
    return [
        [sum(x * y for x, y in zip(row_a, col_b)) for col_b in B_transposed]
        for row_a in A
    ]

# 测试数据
matrix_a = [
    [1, 2],
    [3, 4]
]

matrix_b = [
    [5, 6],
    [7, 8]
]

matrix_c = matrix_dot_product(matrix_a, matrix_b)
print("矩阵乘积结果:")
for row in matrix_c:
print(row)矩阵乘积结果:
[19, 22]
[43, 50]
*B 将二维列表的每一行作为独立参数解包传给 zip()。zip() 按位置同时抓取每个传入参数的第 0 个元素组合为新元组,再抓取第 1 个元素组合……这正好将原来的“每一列”组合成了一个个“新行”,实现了优雅的免包矩阵转置。
五、知识总结与技术选型指南
在纯原生 Python 编程中,实现点乘并不需要冗长复杂的算法,但选择符合具体业务诉求的写法能够兼顾性能与安全。下图全面总结了常见原生手法的优劣势及选用场景:
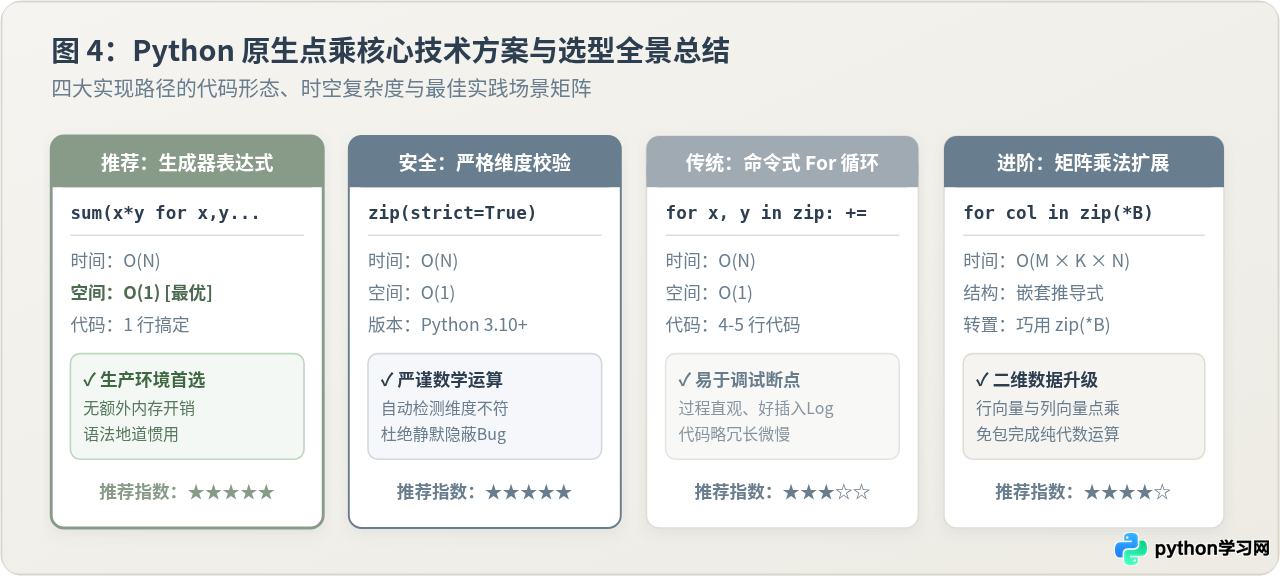
核心实践结论:
-
日常开发与通用脚本:
无脑优先选择
sum(x * y for x, y in zip(a, b))。这是 Pythonic 的典范写法,拥有 O(N) 时间复杂度与 O(1) 辅助空间复杂度。 -
严谨数学运算与生产服务:
绝不可依赖默认
zip()的静默截断机制。如果是 Python 3.10+,请养成追加strict=True的好习惯;低版本中务必添加前置len(a) == len(b)校验,确保非法维度能够尽早暴露。 -
教学与交互式调试:
显式
for x, y in zip(a, b): total += x * y语句结构虽然稍长,但便于在每一步迭代中设置断点或打印日志,适合用于教学演示与复杂边界排查。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









