

Python中str方法与内置函数的区别:len、str与对象方法的对比
深入对比Python中len()、str()等内置函数与字符串对象方法的本质区别,解析底层协议机制、CPython性能考量与开发中的选择依据。
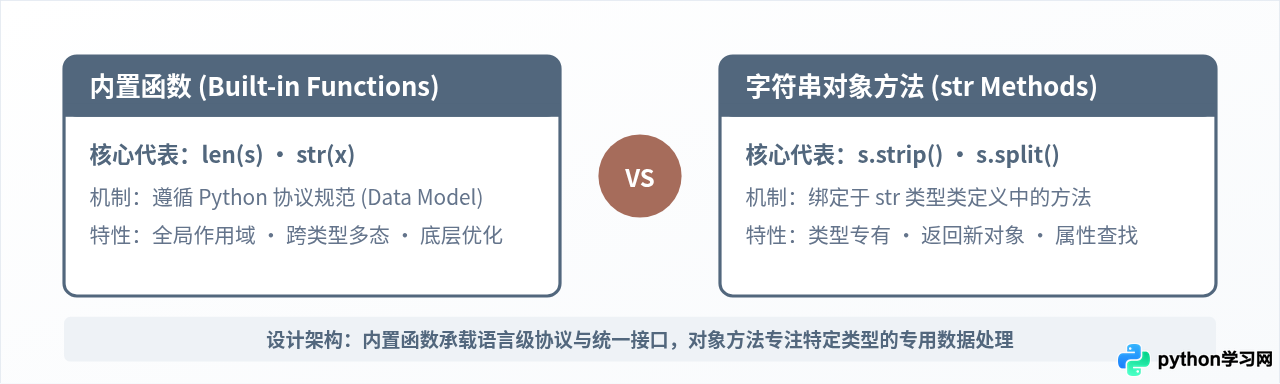
在 Python 中,想要获取字符串长度时需要写 len(s),将数据转为字符串时写 str(obj),而去除首尾空格却要写 s.strip()。这种“有些操作是外部函数传参,有些操作是点号调用方法”的现象,常常让初学者感到困惑。简而言之,内置函数(如 len、str)是 Python 语言级数据模型与特殊协议的统一入口,负责跨类型的通用操作并享有 CPython 底层性能直通车;而字符串对象方法(如 strip、split)则是专门绑定在 str 类型上的专有工具,负责处理文本特有的变换与解析。理解两者的分工与底层协作机制,是建立地道 Python 编程思维的关键基石。
一、调用语法背后的设计哲学:为什么不是 s.len()?
许多从其他面向对象语言(如 Java、JavaScript)转向 Python 的开发者,最常犯的错误之一就是尝试书写 s.length 或 s.len(),随后遭遇熟悉的 AttributeError。这种语法差别的背后,是 Python 之父 Guido van Rossum 对“纯粹面向对象”与“实用主义”之间的权衡。
在纯粹的面向对象理论中,一切操作都应作为对象的方法出现。但如果把获取长度全部做成方法,每个容器类都可能根据作者喜好定义不同的名称(例如有的叫 size(),有的叫 length(),有的叫 count())。Python 选择了**以协议为核心**的顶层设计:将 len() 定义为全局内置函数。无论是内置的 str、list、dict,还是第三方库中的 numpy.ndarray,只要希望表示“包含元素个数”,就统一使用 len(x)。
二、数据模型与特殊方法协议:内置函数如何运作
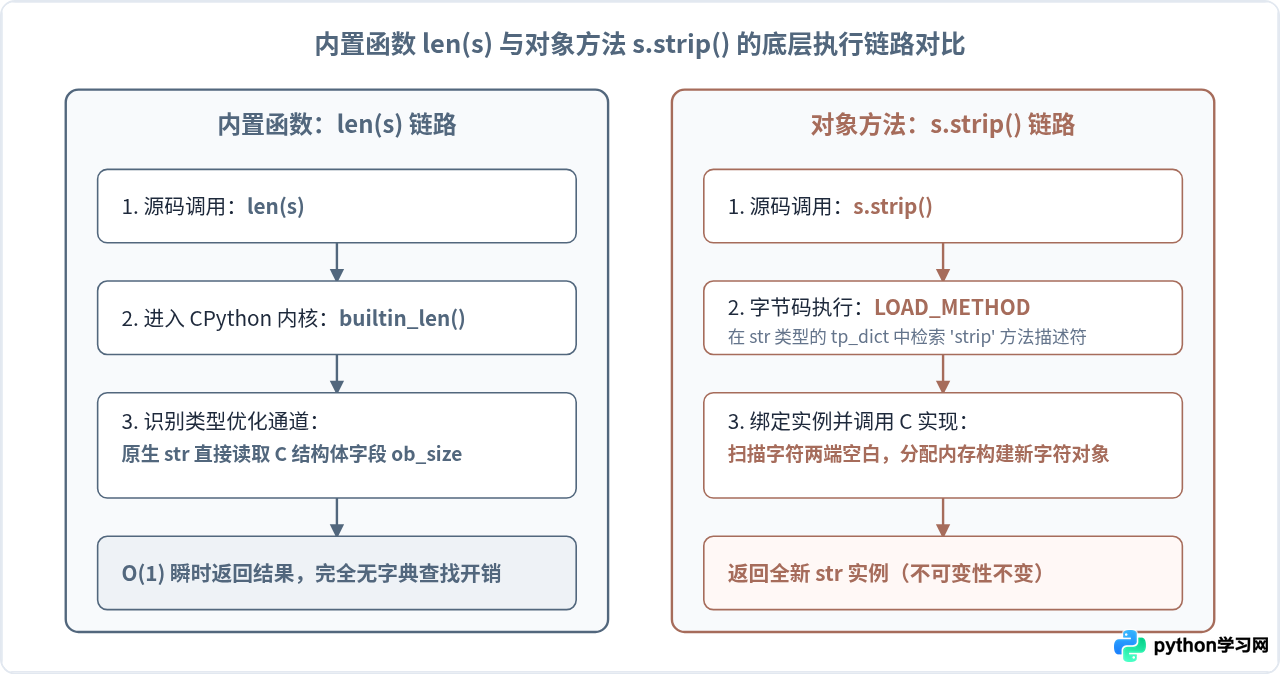
内置函数之所以能够表现出一致的多态行为,依赖于 Python 的核心机制——数据模型(Data Model)与特殊方法(通常称为 Dunder 方法,即以双下划线开头和结尾的方法)。
当你在代码中执行 len(s) 时,Python 解释器在标准流程下会自动将其转发为对目标对象 s.__len__() 的调用;同样,调用 str(x) 时,解释器会优先寻找 x.__str__(),若未定义则回退至 x.__repr__()。
# 协议映射的直观验证示例
s = "hello python"

# 1. 内置函数标准调用(推荐做法)
length_standard = len(s)      # 输出: 12

# 2. 协议底层的魔术方法(内部机制,实际开发切勿直接书写)
length_underlying = s.__len__()  # 输出: 12

assert length_standard == length_underlying
为什么永远不应该直接写 s.__len__()?
既然 len(s) 本质上调用了 __len__(),那么直接写 s.__len__() 岂不是省略了中间层?事实恰恰相反,直接调用双下划线方法存在三大严重缺陷:
- 缺失协议安全校验:
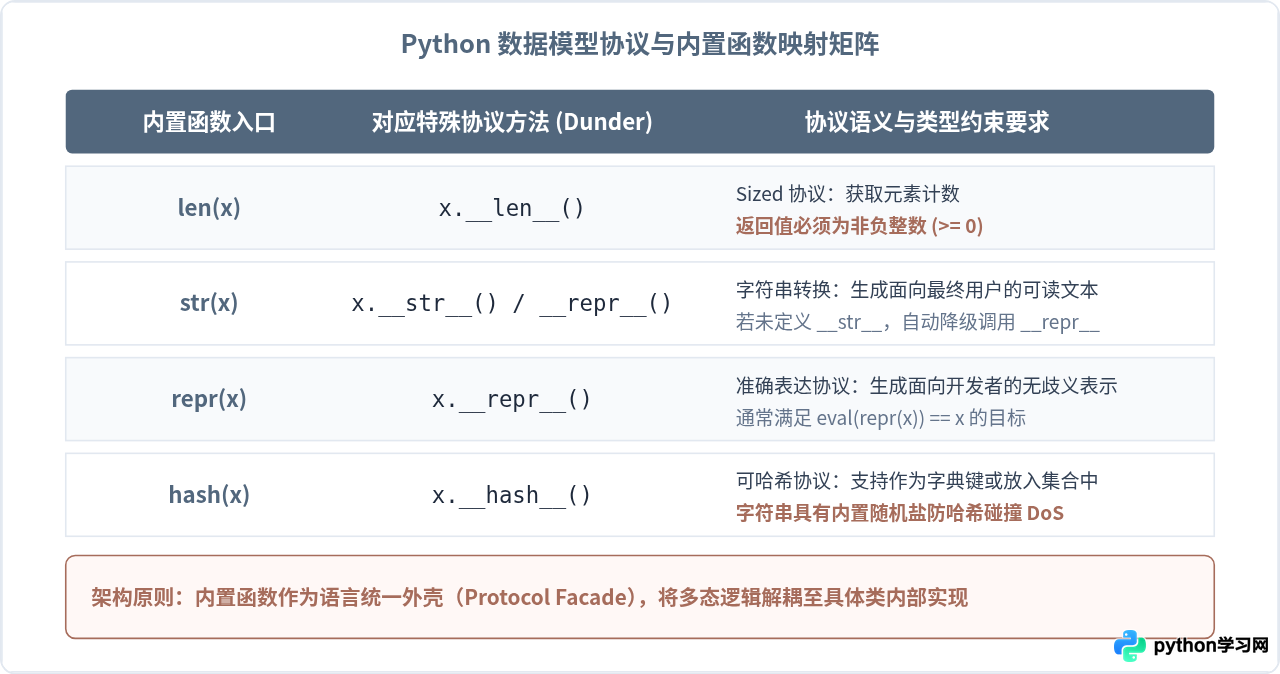
len()内置函数会对返回值进行类型安全约束,强制要求__len__()必须返回一个大于等于 0 的整数。如果返回值不是整数或小于 0,len()会直接抛出TypeError或ValueError;而手动调用s.__len__()则完全绕开了这一保护网。 - 丧失 CPython 原生性能优化:在官方 CPython 实现中,如果参数是原生内置类型(如
str、list、tuple、dict),解释器并不会真的去查找并执行 Python 级别的__len__方法,而是直接读取底层 C 结构体PyVarObject的ob_size字段。这种 O(1) 的字段直读开销微乎其微;而如果直接写s.__len__(),反而迫使解释器执行完整的属性查找、方法绑定与虚拟机调用,性能大幅下降。 - 违背 Python 编码规范:根据 PEP 8 规范,双下划线魔术方法属于解释器钩子(Hooks),应当由解释器自身来调度,业务代码应当始终使用顶层内置函数。
三、内置函数 str() 与 str 类对象方法的职能划分
在技术概念上,str 既是一个内置类(类型构造器),又是我们日常调用时表现出的内置函数形态;而 s.upper()、s.strip() 则是绑定在 str 类上的实例方法。它们在职能与设计定位上有明确边界:
1. 内置函数/类型构造器 str():跨越类型的“转化桥梁”
str() 的核心职责是跨类型的格式标准化与表现。它可以接收任意类型的对象作为参数(如整数、浮点数、列表、字典、自定义类的实例甚至 None),并输出该对象的合法字符串形态。
# str() 能够处理任意类型的参数
val_int = str(1024)          # '1024'
val_list = str([1, 2, 3])      # '[1, 2, 3]'
val_none = str(None)         # 'None'
2. str 对象方法:专注文本处理的“工具箱”
相比于 str() 的通用性,str 的对象方法则是深度定制的专有工具。只要对象本身已经是 str 实例,就可以调用这些方法对字符数据进行检索、清洗、变换和切分。
- 内容修剪与清洗:
strip()、lstrip()、rstrip()用于消除首尾空白或指定字符。 - 切分与组合:
split()将字符串按分隔符切割为列表;join()则由分隔符主导将可迭代容器拼接成新字符串。 - 大小写与形态变换:
upper()、lower()、title()、capitalize()等。 - 状态断言与检索:
startswith()、endswith()、find()、isdigit()等。
Python 中的字符串是不可变对象。因此,任何 str 对象方法都绝不会修改原有字符串本身,而是分配新的内存空间并返回一个新的字符串实例。调用 s.strip() 后如果不将结果重新赋值给变量(如 s = s.strip()),原始字符串将保持原封不动。
四、开发中的选择路径与常见误区排查
在编写日常代码或设计自己的类时,究竟什么时候该用内置函数?什么时候该设计对象方法?以下排查逻辑与决策路径能够提供清晰指导:
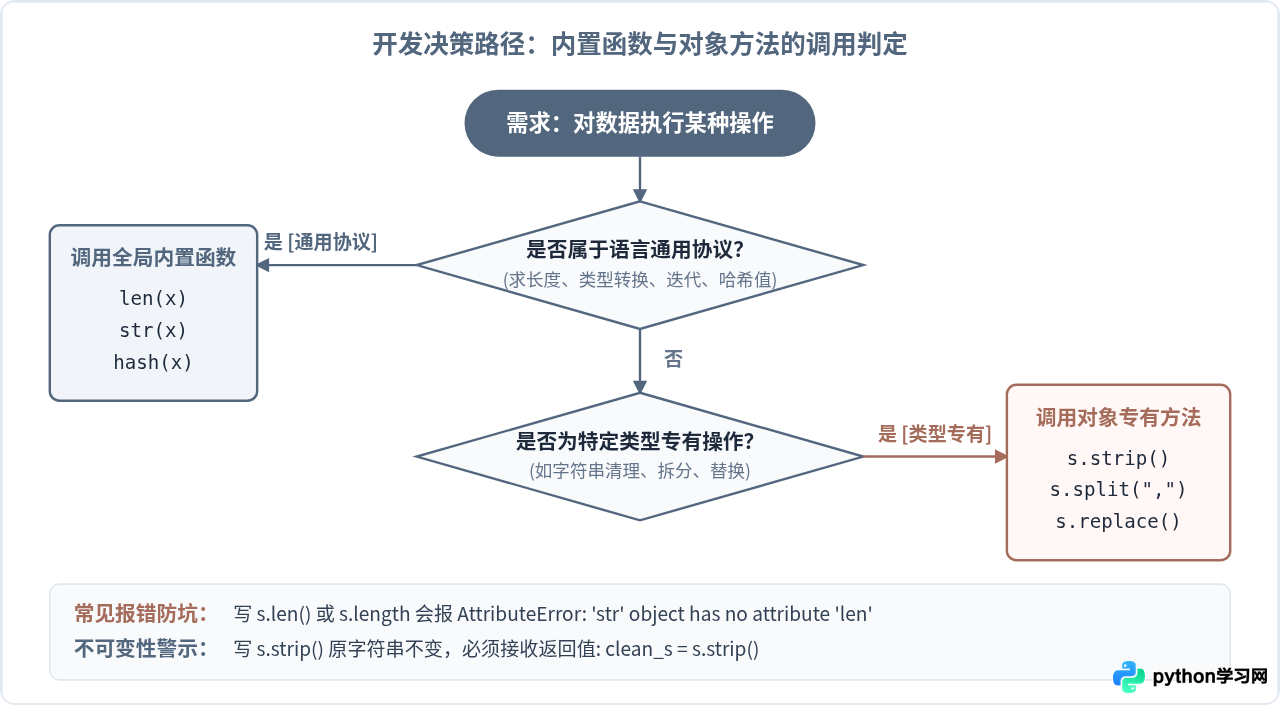
实战中的经典场景辨析
场景 A:计算字符串长度与统计子串出现次数
获取总长度是通用容器特征,因此用 len(s);而计算子字符串 "abc" 在文本中出现的频次则是典型的文本检索算法,因此使用专有的对象方法 s.count("abc")。
场景 B:在自定义类中支持这些功能
如果你自己编写了一个类,例如管理学生名单的 Classroom,希望让它能够通过 len() 获取人数,并能通过 str() 打印摘要,你不需要去为它发明奇怪的名字,只要实现 __len__ 和 __str__ 即可直接接入 Python 整个语言生态:
class Classroom:
    def __init__(self, students):
        self.students = list(students)

    # 接入 len() 协议
    def __len__(self):
        return len(self.students)

    # 接入 str() 协议
    def __str__(self):
        return f"班级共包含 {len(self)} 名学生"

room = Classroom(["Alice", "Bob", "Charlie"])
print(len(room))  # 输出: 3
print(str(room))  # 输出: 班级共包含 3 名学生
五、全维度对比总结与选型矩阵
为了系统梳理两者的核心差异,下表从语法、多态、底层开销和扩展机制五个核心维度进行了量化对比:
| 对比维度 | 全局内置函数(如 len, str) | 字符串对象方法(如 strip, split) |
|---|---|---|
| 语法形式 | 前缀动词形式:len(s), str(obj) |
对象中缀/链式形式:s.strip().lower() |
| 作用域与归属 | 内建命名空间(builtins),全局随处可用 | 封装在具体类(str)命名空间中 |
| 多态实现方式 | 基于数据模型的通用双下划线协议(Duck Typing) | 基于类继承或具体类型内部定义的方法分发 |
| CPython 底层效率 | 原生类型可直接读取 C 字段(如 ob_size),极度高效 |
标准属性查找(LOAD_METHOD / 字典检索)与方法绑定 |
| 自定义扩展方式 | 在自定义类中覆写 __len__、__str__ 即可无缝接入 |
需继承 str 或在具体业务类中自行实现独立方法 |
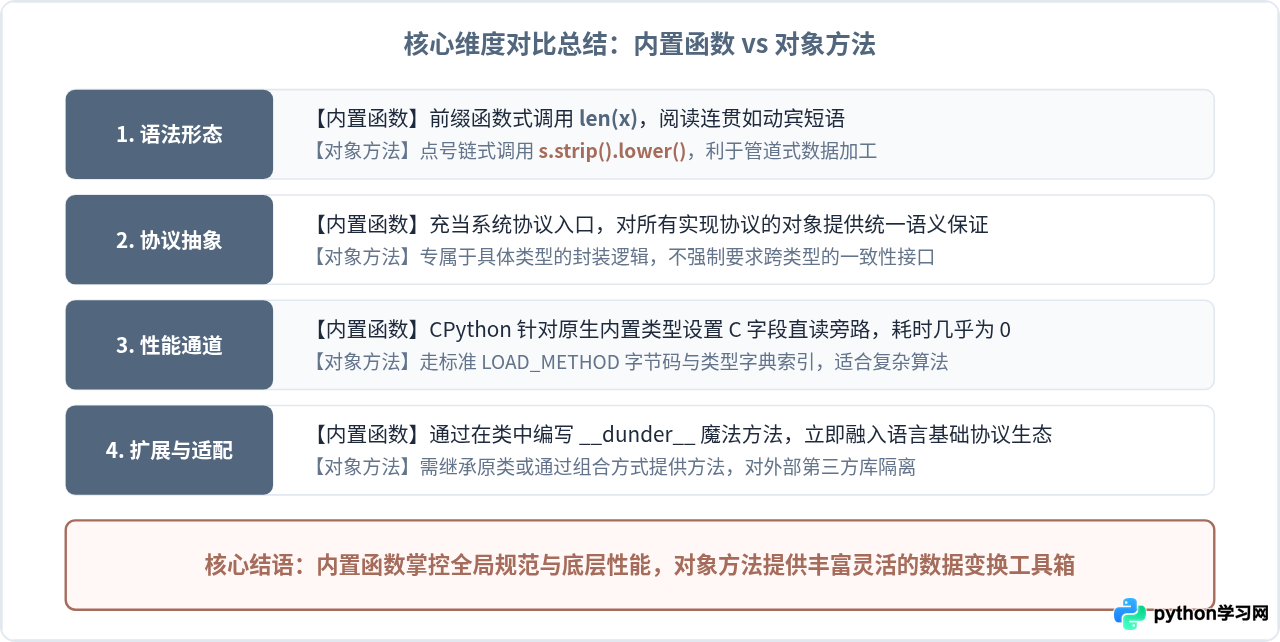
总结而言,Python 并不盲目追求形式上的“万物皆方法”。内置函数是 Python 语言数据模型的协议代言人,确保了跨数据类型的统一交互范式与底层执行效率;而 str 等类型上的对象方法,则是服务于该领域专属逻辑的精密齿轮。在实际编码中,牢记“通用协议用内置函数,专有变换找对象方法”,不仅能写出更优雅地道的 Python 代码,更能从底层原理出发,避开性能损耗与意外报错。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









