

NumPy数组运算详解:Python数据分析的数值计算基础
深入解析NumPy数组运算的核心机制与实践应用,全面覆盖底层内存结构、向量化执行、逐元素计算、广播机制推导规则、矩阵线性代数与多维轴向聚合,助你构建扎实高效的Python数值分析基础。
NumPy(Numerical Python)是 Python 数据科学与科学计算生态的基础基石,Pandas、SciPy、Scikit-learn 以及众多深度学习框架均直接依赖或兼容其核心数据结构 ndarray。在数据分析任务中,面对百万甚至千万级别的数据,使用原生 Python 列表的循环遍历往往会导致严重的性能瓶颈;而借助 NumPy 的向量化运算与紧凑内存设计,计算速度往往能获得几十倍至上百倍的提升。本文直接从底层存储原理、向量化逐元素计算、广播机制推导规则、矩阵线性代数与多维聚合等核心维度展开,详细拆解 NumPy 数组运算的具体机制与关键细节。
一、底层存储原理:为什么 NumPy 运算远快于原生列表
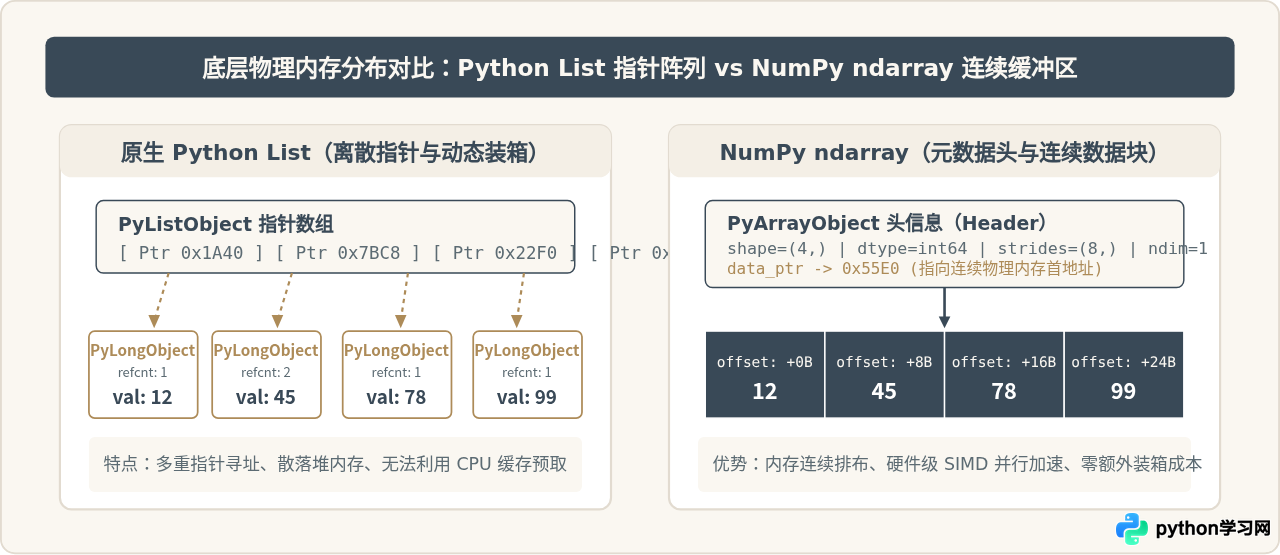
在理解各类数组运算之前,需要先建立清晰的底层物理内存心智模型。Python 内置的 list 本质上是一个可变长度的指针数组。列表中的每一个元素并不是纯数值,而是一个包装过的完整 PyObject 结构体,其中包含引用计数、类型对象指针以及具体数值。
这种设计带来了极高的灵活性,允许在同一个列表中混杂整数、字符串或自定义对象,但在批量数值运算时伴随着显著的性能代价:每次读取数据都需要通过指针进行间接寻址,数据散落在不同的堆内存区域中,导致 CPU 高速缓存(L1/L2/L3 Cache)命中率极低,且每次运算都需要由解释器进行动态类型推断与解包。
相比之下,NumPy 的 ndarray 在内存中分配的是一块严格连续的字节缓冲区(Contiguous Memory Buffer),并且要求所有元素必须具有相同的同质数据类型(如 int64 或 float64)。数组的元数据(包括维度 shape、数据类型 dtype 以及各轴步长 strides)统一保存在独立的头信息结构(Header)中。这种设计不仅消除了海量对象的指针开销,更使得现代 CPU 可以直接利用 SIMD(单指令多数据流)向量化寄存器,在单周期内并发处理多个数值。
二、逐元素算术与通用函数(ufuncs)
在 NumPy 中,最直接也是最常用的运算形态是逐元素运算(Element-wise Operations)。当对相同形状(Shape)的两个数组执行常见的数学运算符时,NumPy 会将该运算施加到对应坐标的每一个元素上。
1. 算术运算符重载与通用函数映射
NumPy 重载了 Python 的基础算术运算符,所有标准符号底层都直接对应于经过高度优化的通用函数(Universal Functions,简称 ufuncs):
| 重载运算符 | 等效 ufunc 函数 | 功能说明 | 示例表达式 |
|---|---|---|---|
+ |
np.add(a, b) |
对应位置元素相加 | a + b |
- |
np.subtract(a, b) |
对应位置元素相减 | a - b |
* |
np.multiply(a, b) |
对应位置元素相乘(注意非矩阵乘法) | a * b |
/ |
np.divide(a, b) |
对应位置元素真除法(返回浮点数) | a / b |
// |
np.floor_divide(a, b) |
对应位置元素向下整除 | a // b |
** |
np.power(a, b) |
计算对应位置元素的指数幂 | a ** b |
% |
np.mod(a, b) |
计算对应位置元素的模数/余数 | a % b |
代码示例如下:
import numpy as np

# 创建两个相同形状的一维数组
a = np.array([10, 20, 30, 40], dtype=np.int32)
b = np.array([1, 2, 3, 4], dtype=np.int32)

# 逐元素加法与乘法
print("a + b =", a + b)  # 示例输出:[11 22 33 44]
print("a * b =", a * b)  # 示例输出:[ 10  40  90 160]

# 比较运算同样是逐元素的,输出布尔类型数组
print("a > 25 =", a > 25)  # 示例输出:[False False  True  True]
2. 原地运算与内存开销优化
在处理大规模数据集时,频繁创建中间数组会迅速消耗机器内存并触发垃圾回收。NumPy 支持原地运算(In-place Operation),通过直接修改原有缓冲区来规避内存重复分配:
- 使用复合赋值操作符(如
a += b、a *= 2)会在已有数组a的内存地址上就地修改。 - 直接赋值表达式
a = a + b则会首先在内存中开辟一块新的缓冲区计算a + b,随后将变量名a重新指向新地址,旧内存成为垃圾。 - 所有 ufunc 函数均提供了
out参数。例如np.add(a, b, out=a)等价于原地累加,非常适合预分配好结果缓冲区的批量运算场景。
原地运算无法自动执行向上类型转换(Type Promotion)。如果 a 是整型数组(int32),执行 a += 1.5 将会引发 UFuncTypeError: Cannot cast ufunc 'add' output from dtype('float64') to dtype('int32') with casting rule 'same_kind' 异常,因为原地写入无法改变原缓冲区的字节宽度。
三、广播机制(Broadcasting):不同形状数组运算的推导法则
当参与运算的两个数组形状不一致时,NumPy 并不会立即报错,而是会尝试通过广播机制(Broadcasting)将较小形状的数组在逻辑上“拉伸”或“广播”,以匹配较大数组的维度。
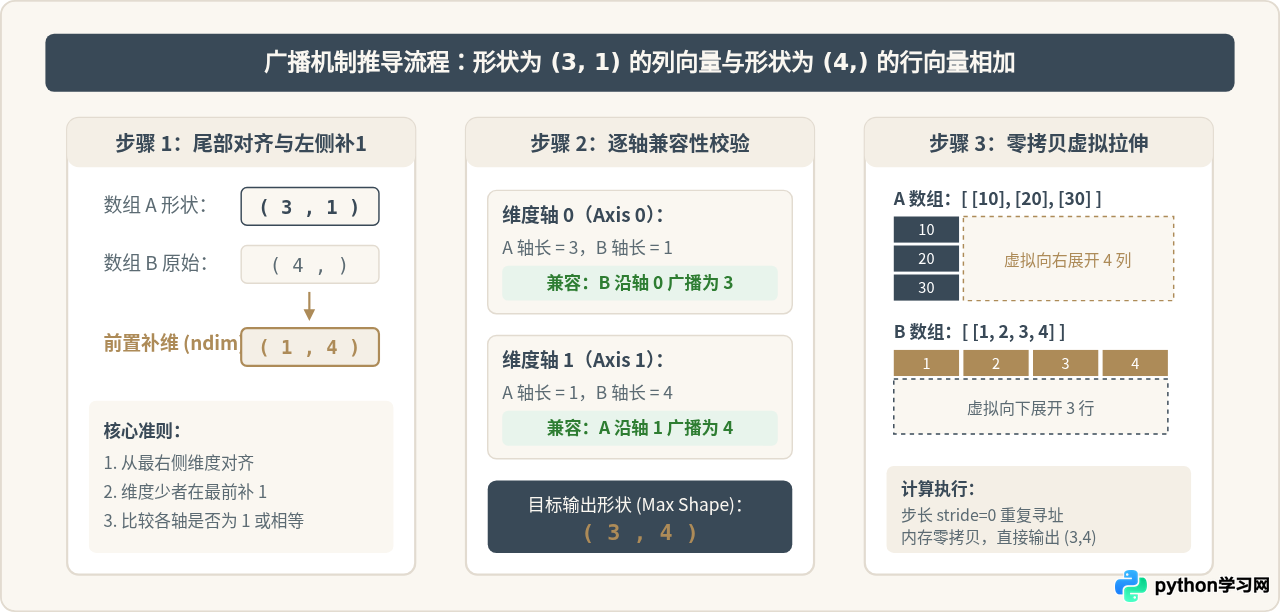
关键在于:广播机制完全是在虚拟步长(Strides)层面实现的,它绝对不会在物理内存中真正复制数据。NumPy 仅需将该轴的步长设置为 0,即可让多次计算重复读取相同的物理内存地址,既节省了内存,又保证了运算速度。
1. 广播兼容性的两大准则
要确定两个数组能否成功广播,NumPy 遵循一套非常严格的维度对比规则:
- 维度右对齐(从尾部轴向前比对):将两个数组的
shape元组从最右侧(最低维度 / Trailing Dimension)开始向左对齐。若其中一个数组的维度较少,则在左侧补 1。 - 逐维度兼容判定:对于每一个对齐的维度位置,必须满足以下两个条件之一,该维度才算兼容:
- 两个数组在该维度的尺寸完全相等(
dim_A == dim_B); - 或者其中一个数组在该维度的尺寸为 1(
dim_A == 1或dim_B == 1)。
- 两个数组在该维度的尺寸完全相等(
如果遍历完所有维度均满足上述条件,则广播合法,最终输出数组的形状为各维度上的最大值;只要存在任何一个维度既不相等且都不为 1,NumPy 便会直接抛出 ValueError: operands could not be broadcast together 异常。
2. 代码实战与典型推导
通过以下代码可以验证上述广播推导全过程:
import numpy as np

# A: 形状为 (3, 1) 的二维数组(列向量)
A = np.array([[10],
              [20],
              [30]])

# B: 形状为 (4,) 的一维数组(行向量)
B = np.array([1, 2, 3, 4])

# 执行加法:B 被自动补齐为 (1, 4),随后 A 拉伸为 (3, 4),B 拉伸为 (3, 4)
C = A + B

print("输出形状:", C.shape)  # 示例输出:(3, 4)
print("计算结果:\n", C)
# 示例输出:
# [[11 12 13 14]
#  [21 22 23 24]
#  [31 32 33 34]]
四、矩阵乘法与线性代数运算
在数据分析与机器学习建模中,二维矩阵运算极其频繁。初学者最容易混淆的概念是:星号运算符 * 与矩阵乘法运算符 @ 的本质区别。
1. 逐元素乘积与矩阵乘法(Hadamard vs Matrix Product)
A * B:逐元素相乘(Hadamard Product)。要求A和B满足上述广播条件,运算结果中坐标(i, j)的值仅仅是A[i, j] * B[i, j]。A @ B或np.matmul(A, B):严格的线性代数矩阵乘法。要求前者的列数等于后者的行数,即A.shape[-1] == B.shape[-2]。若A的形状为(M, K),B的形状为(K, N),则计算结果形状为(M, N),结果中的每个元素是A的第i行与B的第j列对应的点积和。
import numpy as np

M1 = np.array([[1, 2],
               [3, 4]])

M2 = np.array([[5, 6],
               [7, 8]])

# 1. 逐元素对应相乘
print("逐元素乘积 (M1 * M2):\n", M1 * M2)
# 示例输出:
# [[ 5 12]
#  [21 32]]

# 2. 矩阵乘法 (点积)
print("矩阵乘积 (M1 @ M2):\n", M1 @ M2)
# 示例输出:
# [[19 22]
#  [43 50]]
# 计算逻辑:第一行第一列 = 1*5 + 2*7 = 19;第一行第二列 = 1*6 + 2*8 = 22
2. 常用线性代数核心接口
NumPy 在子模块 np.linalg 中封装了基于 BLAS/LAPACK 高度优化的线性代数算法族:
- 矩阵转置:使用属性
M.T或函数np.transpose(M),直接颠倒轴顺序,只改变 Strides,不产生内存拷贝。 - 矩阵求逆:
np.linalg.inv(M)。计算方阵的逆矩阵;对于奇异矩阵(行列式为 0),会抛出LinAlgError,此时可用伪逆np.linalg.pinv(M)代替。 - 解线性方程组:针对线性方程组
Ax = b,优先使用np.linalg.solve(A, b),其内部采用 LU 分解算法,在数值精度和速度上显著优于显式求逆inv(A) @ b。
五、多维轴向聚合与统计计算(Axis Reductions)
在数据清洗与特征工程中,经常需要对数组沿特定方向进行求和、求均值、求方差等聚合降维操作。掌握 axis 参数的核心含义至关重要。
1. 轴(Axis)的几何压缩机理
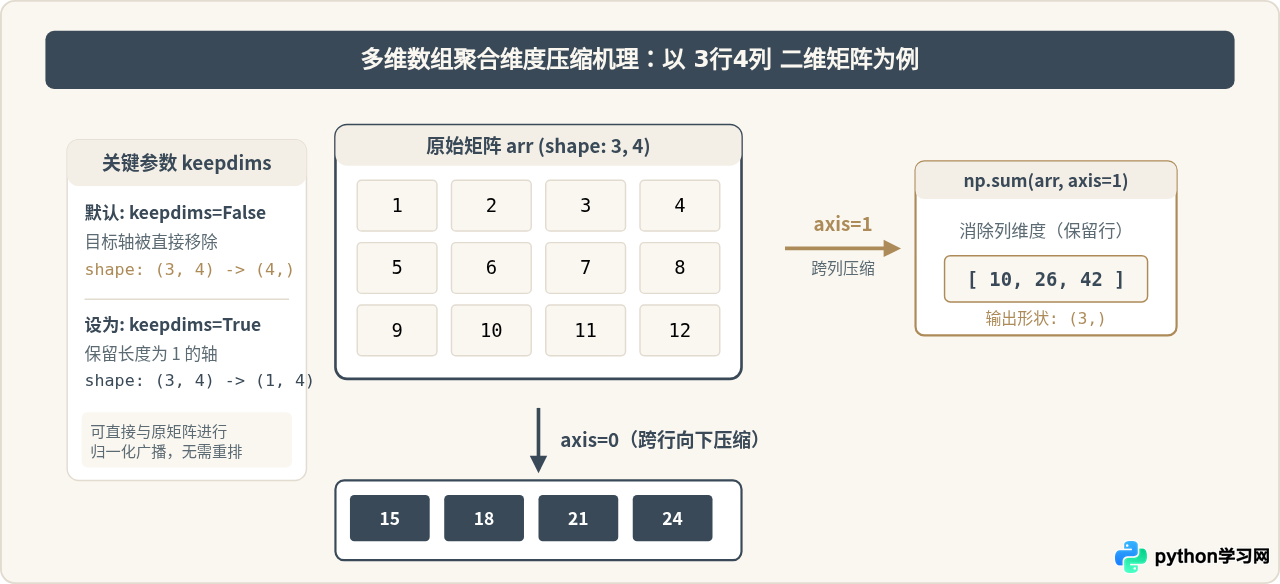
一个极其经典且容易混淆的疑问是:“axis=0 到底代表行还是列?”最清晰且统一的记忆方式是:axis=k 表示沿着第 k 维进行压缩或消除(Collapse):
- 对于二维数组
(rows, cols):axis=0:消除第 0 轴(行维度)。运算沿着垂直方向跨行移动,分别汇总每一列的数据,最终输出形状为(cols,)。axis=1:消除第 1 轴(列维度)。运算沿着水平方向跨列移动,分别汇总每一行的数据,最终输出形状为(rows,)。
2. 参数 keepdims=True 的工程价值
在数据标准化(如特征缩放、Z-Score 归一化)中,我们需要计算每一列的均值,并用原矩阵减去该均值。如果直接调用 mean = arr.mean(axis=0),得到的形状是 (4,)。虽然由于广播规则一维向量能与 (3, 4) 兼容,但如果计算的是行均值 mean_row = arr.mean(axis=1),得到形状 (3,),若直接执行 arr - mean_row 则会发生广播失败(因为 (3, 4) 与 (3,) 尾部不匹配)。
此时,只需加上 keepdims=True:
import numpy as np

data = np.array([[1.0, 2.0, 3.0],
                 [4.0, 5.0, 6.0]])

# 计算每行的均值,并保持维度
row_mean = data.mean(axis=1, keepdims=True)
print("均值形状:", row_mean.shape)  # 示例输出:(2, 1)

# 利用广播机制直接实现每行零均值中心化
centered_data = data - row_mean
print("去中心化结果:\n", centered_data)
# 示例输出:
# [[-1.  0.  1.]
#  [-1.  0.  1.]]
六、高性能计算避坑与工程最佳实践
虽然 NumPy 的底层经过高度调优,但若调用姿势不当,依然可能退化为与原生 Python 一样缓慢。以下是工程实践中最关键的避坑指南:
1. 杜绝在 Python 循环中逐元素修改 ndarray
NumPy 的加速来源于底层 C 代码内部对连续内存的遍历。如果在 Python 层写 for i in range(len(arr)): arr[i] += 1,不仅无法利用 SIMD,反而因为每次索引都要经由 NumPy 包装层校验索引与边界,导致其速度比原生 Python 列表的循环还要慢 2~3 倍。始终优先使用全数组的向量化表达式。
2. 明确区分视图(View)与副本(Copy)
NumPy 切片(Slicing,例如 b = a[1:5])默认返回的是原数组的视图(View),两者共享同一块底层内存缓冲区。修改 b 中的元素会同步改变 a。只有布尔索引(Boolean Masking,如 a[a > 5])、花式索引(Fancy Indexing,如 a[[0, 2, 3]])或者显式调用 .copy() 时,才会生成独立的新内存副本。在涉及原地修改的场景中,务必确认当前操作对象是否为预期副本。
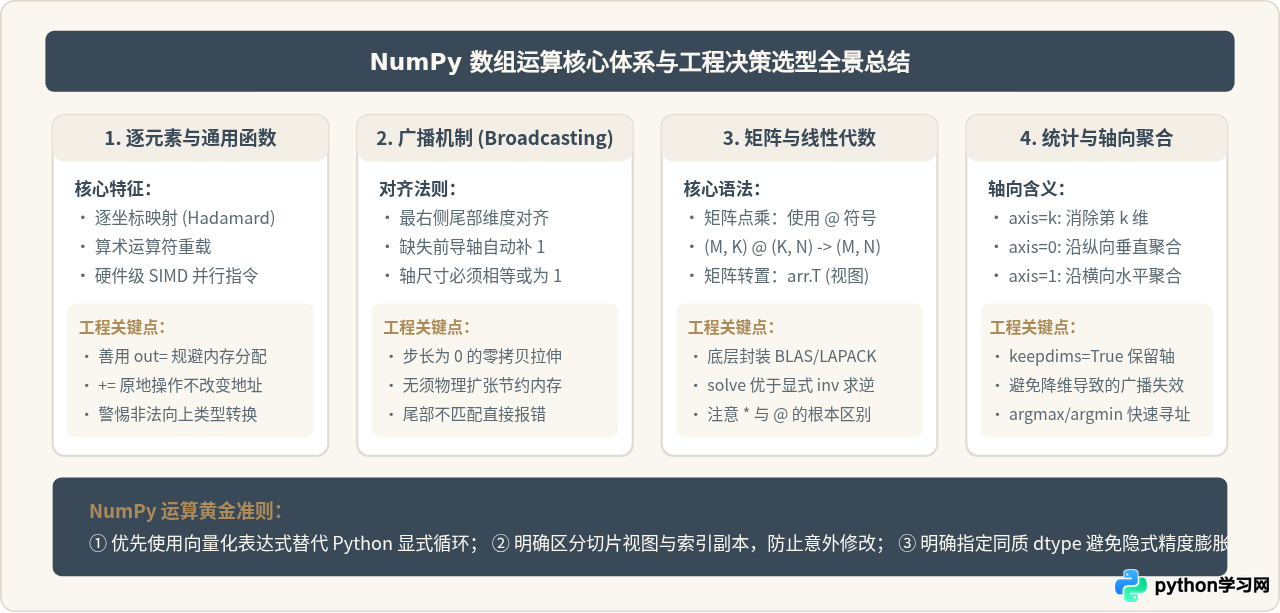
七、总结
NumPy 数组运算之所以成为整个 Python 科学计算大厦的基石,其精髓在于将底层编译级语言的高效内存布局(连续字节块、固定步长、硬件级 SIMD 并发)与高层脚本语言的简洁表达完美结合。在实际数据分析与机器学习开发中,牢牢把握“同质连续存储”、“广播维度对齐”、“矩阵乘法与点乘区分”以及“轴向消除机制”这四大核心逻辑,不仅能够写出性能强悍的数值处理代码,更能从容排查各类复杂的形状不兼容与内存隐式泄漏问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









