

Python代码里误用了中文冒号导致报错怎么办
针对Python开发中因误输入中文全角冒号引发SyntaxError报错的问题,深入解析Unicode编码成因与版本差异,提供终端行号定位、全局批量替换的操作步骤,以及编辑器高亮与输入法防范配置方案。
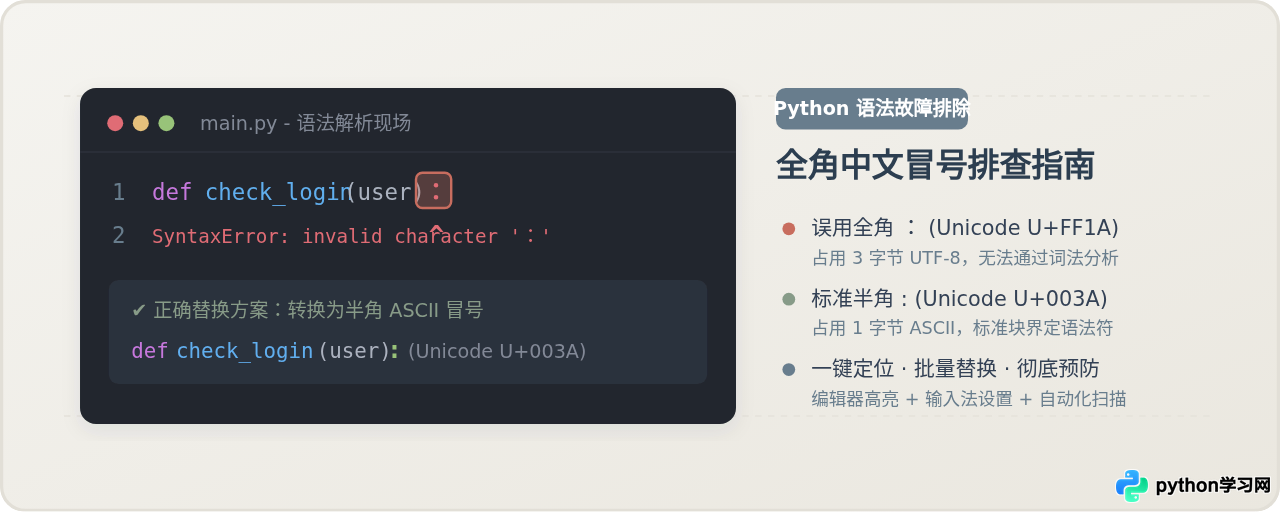
def、if、for、class 等复合语句末尾误输入了中文全角冒号(:),解释器会在词法解析阶段直接中断并抛出 SyntaxError。核心解决路径非常明确:根据终端报错信息提示的行号跳转至源文件位置,将全角冒号删除并替换为半角英文冒号(:);若项目涉及多处遗漏,可通过编辑器的查找替换功能全局清理,并在输入法或 IDE 中开启自动防范设置以彻底杜绝此类失误。
一、报错具体表现与底层原因解析
在 Python 语法规则中,冒号是具有核心结构意义的语法保留字,专门用于引导新的代码缩进块(如条件判断、循环体、函数定义、类声明等)以及分隔字典的键与值。初学者在编写代码过程中,由于频繁在中文注释、中文字符串与英文代码之间切换输入法,极易在行末误敲入全角中文冒号,从而触发解释器的语法错误。
1. 不同 Python 版本的报错输出特征
遇到报错时,终端输出的错误描述会因安装的 Python 解释器版本而有所差异,但排查逻辑完全一致:
- Python 3.10 及以上版本(增强型报错):
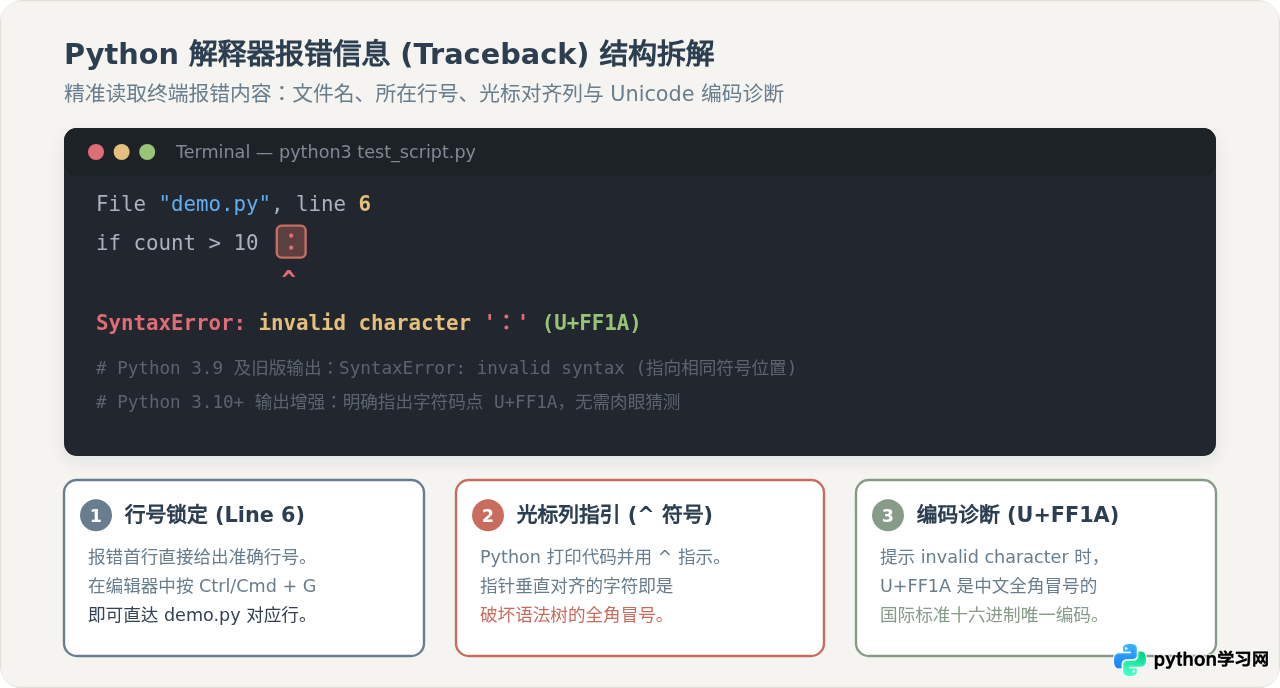
新版 Python 增强了解释器的错误定位机制,不仅用File "main.py", line 4 if score >= 60: ^ SyntaxError: invalid character ':' (U+FF1A)^指针精确对齐到非法符号,更直接指出了非法字符是 Unicode 码点为U+FF1A的字符,信息清晰直观。 - Python 3.9 及更早版本(通用语法报错):
早期版本仅输出通用的File "main.py", line 4 if score >= 60: ^ SyntaxError: invalid syntaxinvalid syntax(语法无效)。虽然没有明确提示字符名称,但下方的^箭头依然会准确指出出错列的位置。
2. 两种冒号的微观差异与解释器处理机制
为什么仅仅一个标点符号的输入状态不同,就会导致整个程序无法执行?这取决于 Python 词法分析器(Lexer/Tokenizer)对字节流的处理规则。下表详细对比了两种冒号在计算层面的关键差异:
| 对比维度 | 英文半角冒号(正确) | 中文全角冒号(导致报错) | 差异带来的影响 |
|---|---|---|---|
| 字形展示 | : |
: |
全角字符在等宽字体下占据两个英文字符宽度,视觉上有额外间距 |
| Unicode 码点 | U+003A (十进制 58) |
U+FF1A (十进制 65306) |
码点完全不同,分属基础 ASCII 区与全角标点符号区 |
| UTF-8 存储 | 单字节:0x3A |
三字节:0xEF 0xBC 0x9A |
内存与磁盘中实际保存的底层二进制数据完全不同 |
| 词法分析结果 | 转换为 COLON 语法标记 |
判定为非法字符或语法未完成 | 词法解析器无法将全角字符识别为操作符,导致语法树构建失败 |
| 合法出现场景 | 代码语法结构、字符串、注释 | 仅允许在字符串常量与注释中 | 作为语法结构符时必然触发 SyntaxError |
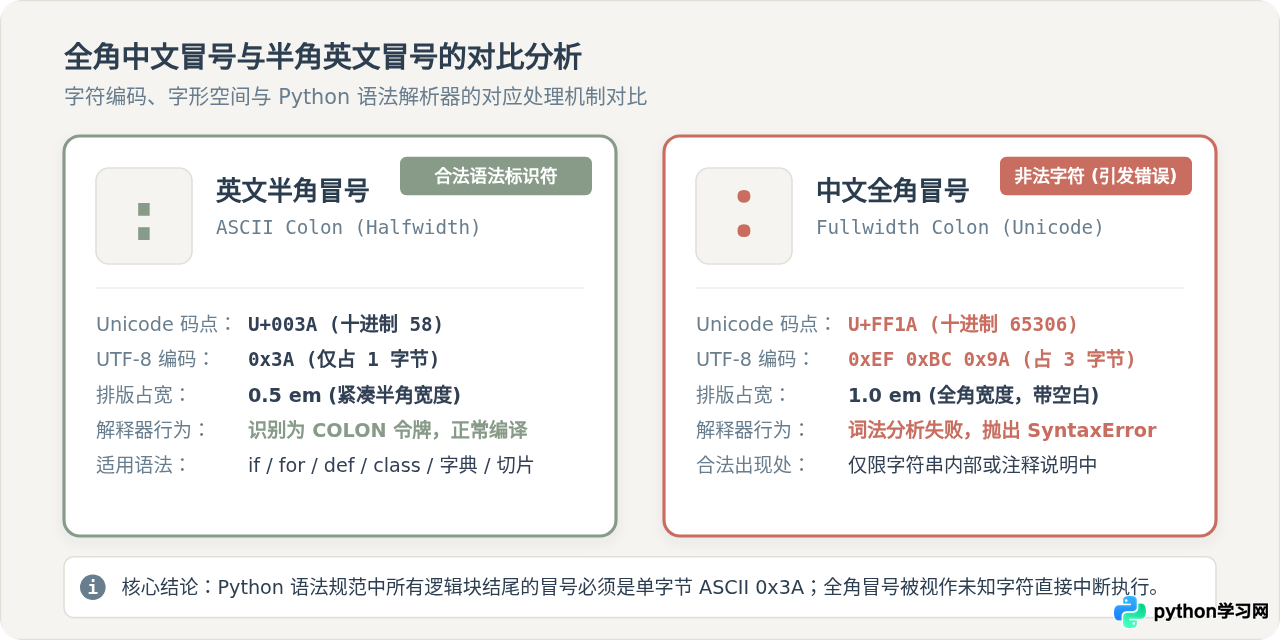
在 Python 执行源码时,源代码首先经过词法分析器转换为标记流(Tokens)。当分析器读取到行末的 U+FF1A 时,由于它不是合法的标识符组成部分,也不是合法的标点符号,解释器无法将其归入已知的词法类别,因而会在第一阶段直接报错退出,甚至根本不会进入代码的实际执行阶段。
二、快速定位与完整修复步骤
修复中文冒号报错不需要复杂的重构,按照“阅读报错定位 → 手动/批量更正 → 再次运行验证”的标准化四步即可彻底解决。
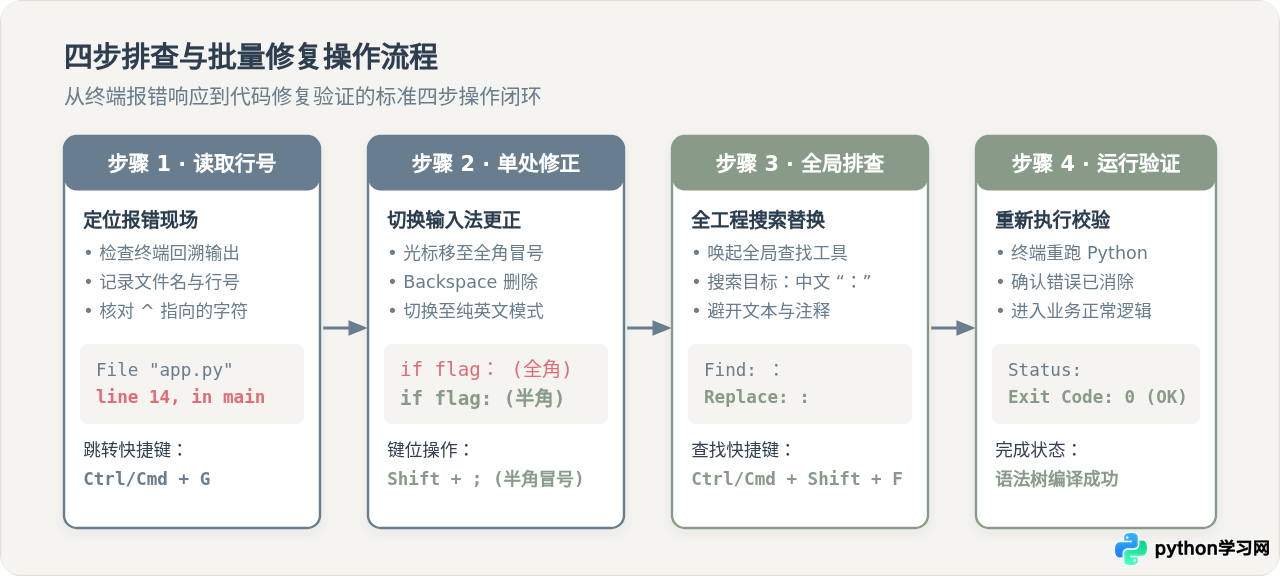
步骤一:根据 Traceback 准确定位文件与行号
不要慌乱地从第一行肉眼翻看整个代码文件。直接观察终端最后打印的报错块:
- 找到类似
File "user_service.py", line 42的字样,明确报错发生在user_service.py文件的第 42 行。 - 打开代码编辑器(如 VS Code、PyCharm、Cursor 等),使用行号跳转快捷键(Windows/Linux 上按
Ctrl + G,macOS 上按Cmd + G),输入行号42并回车,光标便会直接停在出错行。 - 核对终端中
^箭头所指的具体字符位置。
步骤二:单处手动更正
在编辑器中将光标移动至该行末尾的中文冒号处:
- 按下退格键(
Backspace)删除全角冒号:。 - 确认当前输入法处于半角英文输入状态(按下键盘上的
Caps Lock或通过Shift临时切换)。 - 按住
Shift键并敲击分号键,重新键入半角英文冒号:。 - 此时在代码编辑器的等宽字体渲染下,半角冒号将紧随括号或变量后方,呈现紧凑规整的半角宽度。
步骤三:全局排查与批量清理
如果当前文件或整个项目是一次性编写完成的,作者往往在同一个输入状态下连续写了多处分支语句。为了防止修改完一行后运行又在下一行报错,推荐使用全局搜索进行彻底清理:
- 单文件批量替换:在编辑器内按
Ctrl + F(macOSCmd + F),展开替换面板。在查找框输入中文冒号:,在替换框输入英文冒号:。 - 逐处核对确认:不要盲目点击“全部替换”(Replace All)。使用“逐个替换”(Next & Replace)功能,避开字符串常量(例如
print("提示:请输入用户名"))中的合法中文冒号,仅对代码行末的结构冒号进行替换。 - 使用正则表达式精准匹配(推荐进阶做法):在查找框启用正则模式(图标
.*),搜索位于行末并带有可选空白的中文冒号:
将其替换为标准半角冒号::\s*$
该正则能精准命中所有位于语句结尾作为代码块引导符的全角冒号,完全不会误伤字符串内部的说明性文本。:
步骤四:保存并重新执行验证
完成替换后保存文件(Ctrl + S 或 Cmd + S),切换回终端重新运行启动命令:
python3 user_service.py若终端不再输出 SyntaxError 并顺利打印出预期运行结果或进入交互循环,即证明语法错误已彻底消除。
三、常见场景与特殊边界说明
在 Python 语法中,并非所有出现中文冒号的地方都会报错。理解合法的边界条件有助于避免过度清理:
1. 容易出现中文冒号的高频语法结构
以下所有控制流与定义语句末尾,均要求必须使用半角英文冒号:
- 条件判断:
if condition:、elif condition:、else: - 循环结构:
for item in sequence:、while expression: - 函数与类定义:
def function_name(args):、class MyClass: - 异常处理:
try:、except Exception as e:、finally: - 上下文管理:
with open(filepath) as f: - 字典字面量键值对分隔:
{"name": "Alice", "age": 18}(若误写为中文冒号同样会报错) - 列表与字符串切片:
items[0:5](若误写为中文冒号会被解析为非法语法)
2. 合法允许保留中文冒号的场景
在以下两类场景中,中文全角冒号是完全合法的文本数据,切勿误替换:
- 字符串字面量内部:
# 完全合法,因为引号内部的内容属于纯文本数据 welcome_message = "系统提示:登录成功!" log_entry = f"当前时间:{now},状态码:{status}" - 单行及多行注释中:
# 注意事项:此处必须确保输入参数非空
"""
参数说明:
  user_id: 用户唯一标识符
"""
3. 为什么有时报错箭头指向了下一行?
有些开发者会遇到一种特殊情况:报错提示在第 15 行,但仔细核对第 15 行并无任何问题,实际错误却在第 14 行末尾。这是因为在 Python 3.9 之前的某些复杂语句解析中,解释器在读取完第 14 行后未获得合法的闭合符号,会继续读入下一行的缩进,直到下一行开始时才意识到前序语句的语法结构破损,从而将报错行定位在下一行的开头。遇到此类情况时,只要看到报错行首部缺乏引导,应习惯性向前检查上一行末尾是否遗漏或误用了全角符号。
四、从源头根除:编辑器与输入法的防范机制
要从根本上避免中文冒号带来的低效排错,应当构建包含“输入法设置”、“编辑器实时高亮”和“工程自动化检查”在内的三层防御体系。
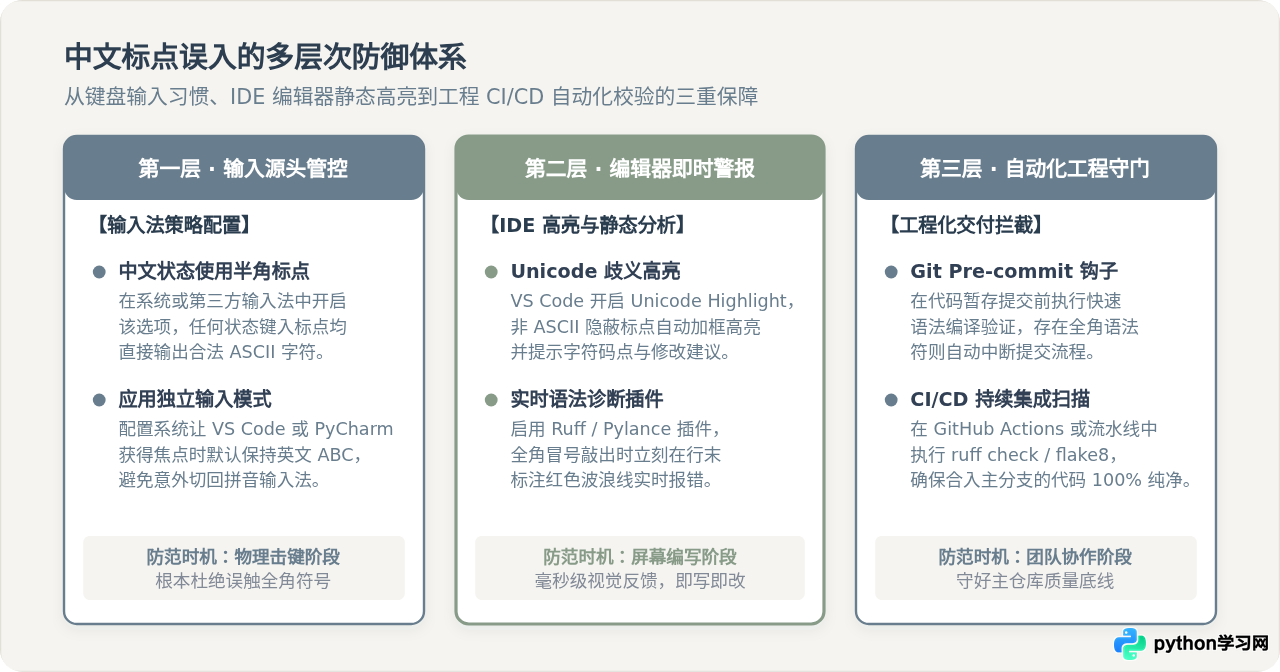
1. 第一道防线:优化输入法设置
- 开启“中文输入使用半角/英文标点”:主流输入法(如 macOS 自带输入法、搜狗输入法、微信输入法等)均提供标点输出选项。勾选该设置后,即使处于拼音打字状态,按下
:、,、.等键时输出的依然是标准半角 ASCII 字符。 - 应用级输入法锁定:在系统设置中为常用开发工具(VS Code、PyCharm、终端)配置默认英文键盘布局,避免在切入编辑器时默认处于中文状态。
2. 第二道防线:现代 IDE 隐蔽字符高亮检测
现代代码编辑器内置了强劲的 Unicode 混淆字符检测功能。以 VS Code 为例,在设置中搜索并确认以下配置项处于启用状态:
{
  "editor.unicodeHighlight.ambiguousCharacters": true,
  "editor.unicodeHighlight.invisibleCharacters": true,
  "editor.unicodeHighlight.nonBasicASCII": true
}
开启后,任何混入代码逻辑的中文冒号、中文逗号或全角空格,编辑器都会立即以黄色边框将其醒目标记,并弹出悬浮提示窗明确标明 字符 ":" 可能与 ASCII 字符 ":" 混淆,让问题在敲下的第一秒就被肉眼识破。
3. 第三道防线:静态检查与 Git 钩子拦截
在团队协作或较为规范的个人工程中,可以通过集成静态代码分析工具(如 Ruff 或 Flake8),在保存文件或提交代码时自动进行语法合规性检查:
- 在项目中安装极速静态检查器:
pip install ruff - 配置 Git Pre-commit 钩子,使代码在
git commit时自动执行语法检查。一旦代码中存在SyntaxError,提交过程将被立即阻断,确保存在低级语法错误的代码绝不流入版本库。
五、总结
Python 中误用中文冒号是输入法状态切换带来的典型失误。解决这一问题的核心在于:充分利用终端 Traceback 提供的行号与光标指示直接定位,通过 Ctrl/Cmd + G 跳转并修正为半角 :;对大型文件利用带有行尾锚点的正则表达式 :\s*$ 批量安全清理;同时在编辑器中启用 Unicode 混淆高亮与 Linter 实时诊断,从根源上将此类排错成本降为零。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









