

Python嵌套循环执行逻辑与矩阵操作案例

在 Python 编程中,嵌套循环的本质是多维步进控制:外层循环每推进一次迭代,内层循环便从头到尾完整执行一整轮。当我们将这种控制流映射到由列表组成的二维数据结构(矩阵)时,外层循环变量天然对应矩阵的行坐标,内层循环变量则对应列坐标。理解嵌套循环的关键不仅在于掌握双层 for 语句的执行时序,还在于理清内存中嵌套列表的独立性与引用关系。本文将从嵌套循环的时序推导与状态流转入手,深入剖析 Python 二维列表创建时的浅拷贝引用陷阱,并通过行优先与列优先遍历、矩阵转置、对应元素相加及矩阵乘法等经典案例,帮助读者建立清晰规范的多维数据处理能力。
一、嵌套循环的核心执行逻辑与时序推导
很多初学者在初次接触双重循环时,容易对循环变量的变化节奏产生混淆,误以为外层与内层是同时推进的。事实上,嵌套循环遵循极其严格的“层次驱动”规律。我们可以将其比作机械钟表的分针与时针:外层循环如同“时针”,走得慢;内层循环如同“分针”,走得快。外层循环每向前步进一格,内层循环就必须在当前外层状态的约束下,从起始值到终止值完整旋转一整圈。
考虑以下基础的两层嵌套循环代码:
# 双层嵌套循环的基础执行演示
for i in range(2):
    print(f"--- 外层循环步进: i = {i} ---")
    for j in range(3):
        print(f"    内层执行: i = {i}, j = {j}")
这段代码的执行输出如下:
--- 外层循环步进: i = 0 ---
    内层执行: i = 0, j = 0
    内层执行: i = 0, j = 1
    内层执行: i = 0, j = 2
--- 外层循环步进: i = 1 ---
    内层执行: i = 1, j = 0
    内层执行: i = 1, j = 1
    内层执行: i = 1, j = 2
从输出轨迹中可以清晰观察到执行时序的核心特征:在 i = 0 时,内层循环独立完成了三次迭代(j = 0, 1, 2);直到内层循环完全遍历完毕并正常退出后,控制权才交还给外层循环,使 i 递增为 1;接着,内层循环被重新初始化,j 再次从 0 开始执行至 2。因此,总执行次数严格等于外层迭代次数与内层迭代次数的乘积($2 \times 3 = 6$ 次)。
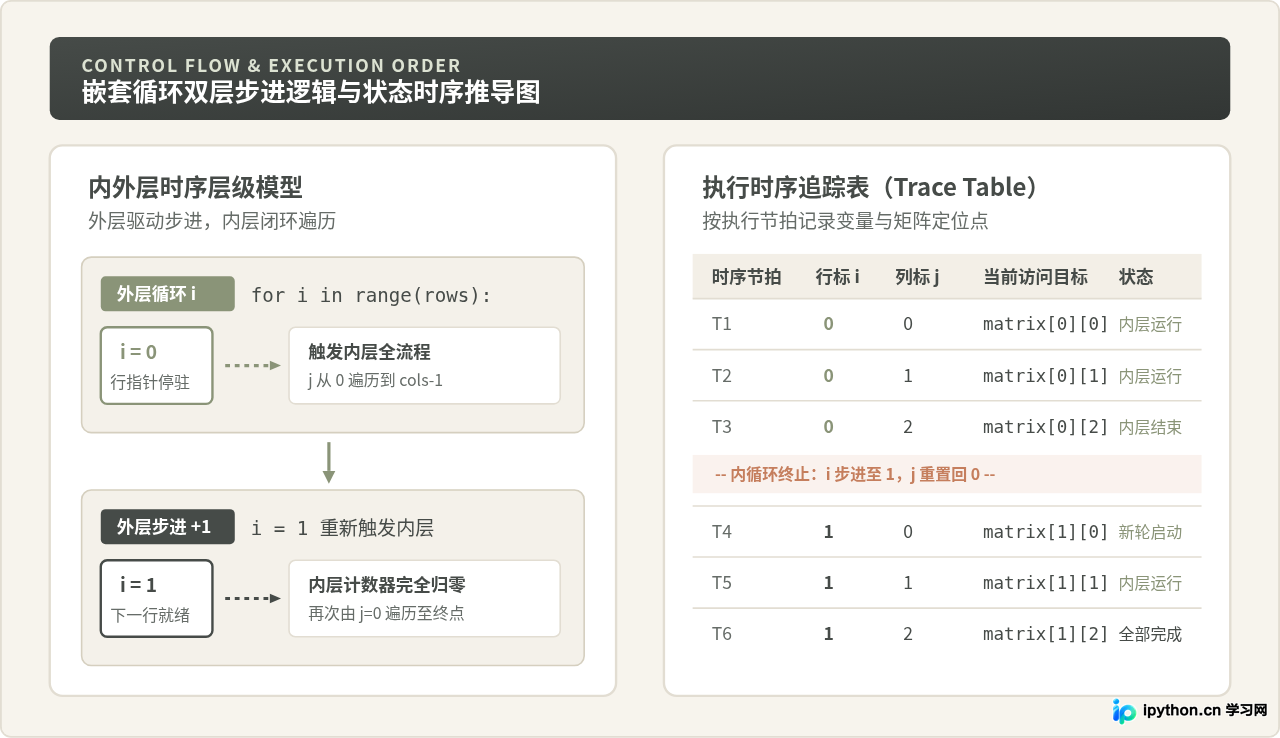
在理解这一时序规律时,需要注意一个关于 Python 迭代器的常见认知细节:在循环体内对迭代变量(如 i = i + 10)进行重新赋值,并不会改变下一次迭代的步进值。因为 Python 的 for 循环直接依赖底层迭代器协议(即 iter() 与 next()),每次进入循环时都会从迭代器中拉取下一个元素覆盖当前变量名。因此,不要试图通过修改循环变量来跳过某些迭代步,如果需要动态跳转或跳步,应当使用 continue 或改用 while 循环。
二、二维列表(矩阵)的创建与内存引用避坑
在 Python 中,标准库并没有专门的内置二维数组类型,通常使用“列表的列表”(List of Lists)来表示二维矩阵。例如,一个具有 3 行 3 列的方阵表示为 matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]。每个子列表对应矩阵的一行,而子列表内的元素对应具体列。
很多初学者为了简洁,常常写出类似
matrix = [[0] * 3] * 3 的代码来初始化一个 $3 \times 3$ 的全零矩阵。这种写法在表面上输出了正确的结果,但在后续修改元素时会引发严重的逻辑错误!
我们来看实际测试代码与运行结果:
# 陷阱写法测试
bad_matrix = [[0] * 3] * 3
print("初始化状态:", bad_matrix)

# 仅试图修改第 0 行第 0 列的元素
bad_matrix[0][0] = 9
print("修改 [0][0] 后的结果:", bad_matrix)
输出结果会出乎许多人的意料:
初始化状态: [[0, 0, 0], [0, 0, 0], [0, 0, 0]]
修改 [0][0] 后的结果: [[9, 0, 0], [9, 0, 0], [9, 0, 0]]
为什么明明只修改了 bad_matrix[0][0],每一行的第一个元素却全都被修改成了 9?
其根本原因在于 Python 的内存引用模型。表达式 [0] * 3 在内存中创建了一个包含三个零的列表对象(例如内存地址 0x10A)。而外层的 * 3 并不是在深拷贝这个列表,而是把这个列表对象的内存引用地址复制了 3 份并放入外层列表。也就是说,bad_matrix[0]、bad_matrix[1] 和 bad_matrix[2] 实际上是指向同一块物理内存的三个别名指针!通过 id(bad_matrix[0]) == id(bad_matrix[1]) 可以证实它们的内存地址完全相同。
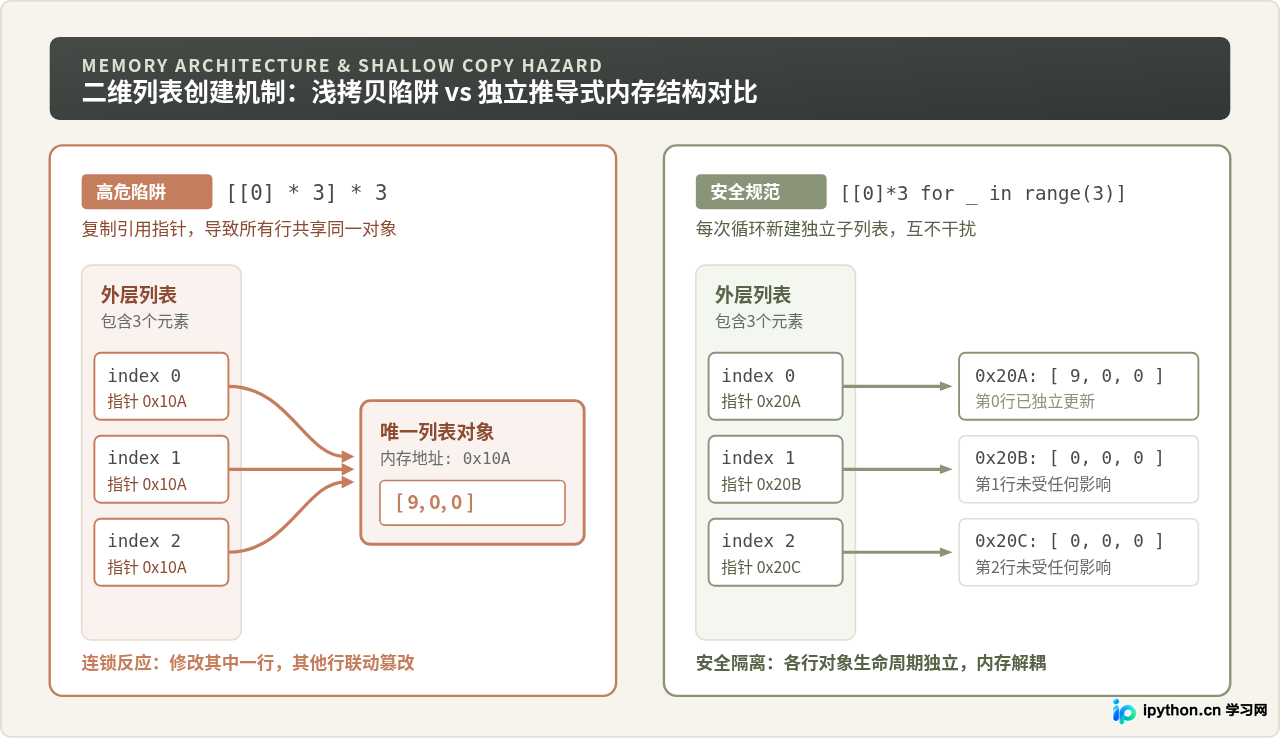
正确的二维矩阵初始化范式:使用列表推导式(List Comprehension)。列表推导式在每一次外部迭代执行时,都会执行一次表达式计算,从而生成一个全新的独立列表对象:
# 推荐的标准初始化写法:创建 rows 行 cols 列的独立矩阵
rows, cols = 3, 3
correct_matrix = [[0] * cols for _ in range(rows)]

# 验证修改
correct_matrix[0][0] = 9
print("安全修改后的结果:", correct_matrix)
# 输出: [[9, 0, 0], [0, 0, 0], [0, 0, 0]]
三、矩阵的基础遍历与元素访问规范
掌握了安全的矩阵创建方式后,如何读取和更新矩阵中的元素是进行各类算法运算的基础。在二维坐标系中,我们用 matrix[r][c] 来访问第 r 行第 c 列的元素。
1. 行优先遍历(Row-Major Traversal)
行优先遍历是最符合直觉和 Python 底层存储特性的遍历方式。其特点是:外层循环遍历行索引,内层循环遍历列索引。在处理完当前行的所有列之后,再移步到下一行:
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

num_rows = len(matrix)
num_cols = len(matrix[0]) if num_rows > 0 else 0

print("行优先遍历输出:")
for r in range(num_rows):
    for c in range(num_cols):
        print(f"坐标 ({r}, {c}) -> {matrix[r][c]}")
2. 列优先遍历(Column-Major Traversal)
在某些数据分析或图像变换场景下,我们需要按列垂直读取数据(例如提取某一维度的特征或按列求均值)。此时只需反转循环层级:外层循环遍历列索引,内层循环遍历行索引:
print("列优先遍历输出:")
for c in range(num_cols):
    for r in range(num_rows):
        print(f"坐标 ({r}, {c}) -> {matrix[r][c]}")
在动态访问矩阵前,务必先确认矩阵非空:
num_rows = len(matrix)。若矩阵可能为空列表 [],直接调用 len(matrix[0]) 会引发 IndexError: list index out of range。此外,如果在非矩形的不规则列表(Ragged Array)中遍历,各行长度不一致,应当以内层当前行的 len(matrix[r]) 作为边界。
四、经典操作案例一:矩阵转置(行变列映射)
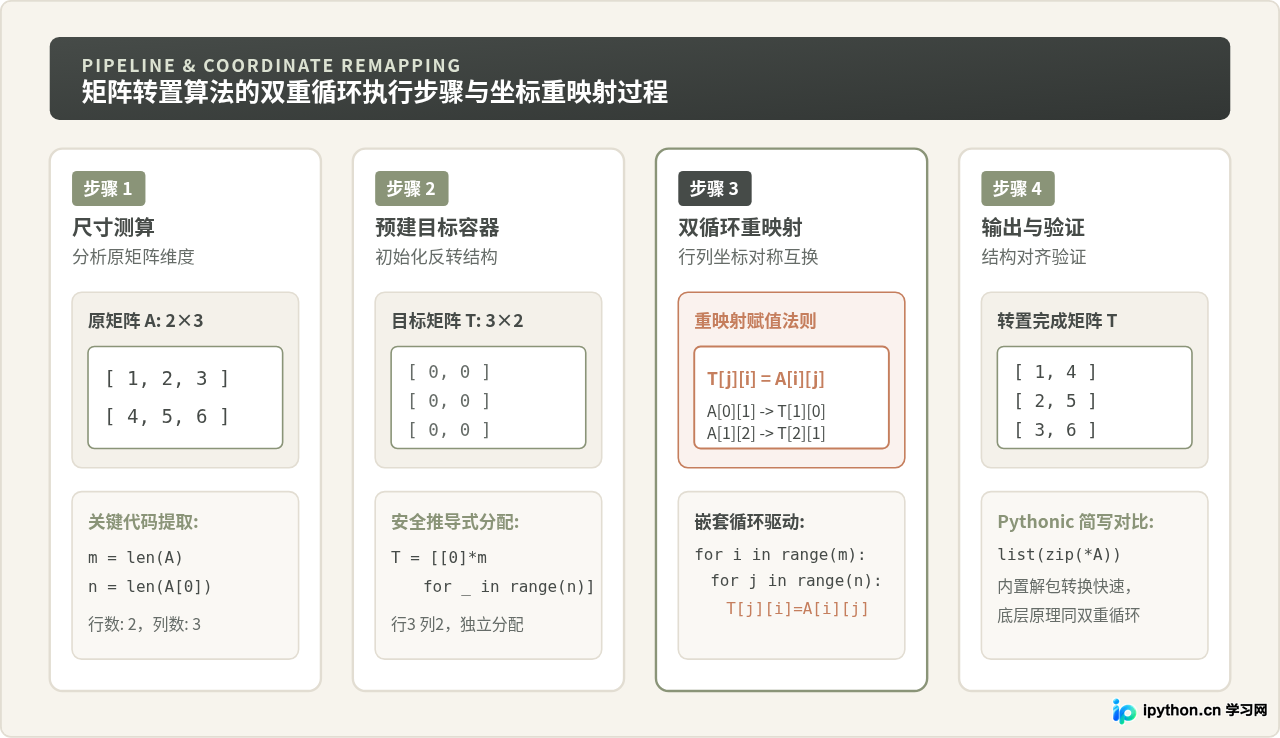
矩阵转置(Matrix Transpose)是线性代数与几何变换中最基础的操作之一。转置操作将一个 $M \times N$ 的矩阵变换为一个 $N \times M$ 的新矩阵,原矩阵的行变换为新矩阵的列,满足数学映射关系:$T[j][i] = A[i][j]$。
实现矩阵转置标准算法的操作步骤包括:
- 测量原矩阵尺寸:获取原矩阵的行数
m和列数n; - 预分配转置矩阵容器:创建一个尺寸为
n行m列的全新独立空矩阵; - 双重循环重映射:外层遍历原行标
i,内层遍历原列标j,将matrix[i][j]写入transposed[j][i]; - 校验结果维度与数据一致性。
下面是完整可运行的矩阵转置代码示例:
def transpose_matrix(matrix):
    """
    使用双重嵌套循环执行矩阵转置
    :param matrix: 二维列表 List[List[Any]]
    :return: 转置后的全新二维列表
    """
    if not matrix or not matrix[0]:
        return []

    rows = len(matrix)
    cols = len(matrix[0])

    # 步骤 2:分配 cols 行 rows 列的独立二维容器
    transposed = [[0] * rows for _ in range(cols)]

    # 步骤 3:双重循环重映射
    for i in range(rows):
        for j in range(cols):
            transposed[j][i] = matrix[i][j]

    return transposed

# 示例数据验证
original = [
    [1, 2, 3],
    [4, 5, 6]
]
transposed_res = transpose_matrix(original)
print("原矩阵 (2x3):", original)
print("转置矩阵 (3x2):", transposed_res)
在 Python 进阶技巧中,我们经常能看到利用 zip(*matrix) 实现转置的一行代码写法:[list(col) for col in zip(*matrix)]。星号 * 会把原列表中的每个子列表作为独立参数解包传入 zip(),而 zip() 每次从各个子列表中提取同索引元素打包成元组,其内在遍历逻辑正是列优先访问与转置映射。理解双重循环的底层实现,能让我们更透彻地理解高级语法的运行机制。
五、经典操作案例二:矩阵相加与条件变换
两个矩阵能够相加的数学先决条件是:两者的维度必须完全相同(即具有相同的行数和列数)。在同型矩阵的前提下,相加操作只需将对应位置 $(i, j)$ 的元素相加并填入结果矩阵。
在工程实践中,严谨的代码必须包含输入维度的校验逻辑:
def add_matrices(mat_a, mat_b):
    """
    计算两个同型矩阵的和
    """
    # 维度健全性校验
    if not mat_a or not mat_b:
        raise ValueError("输入矩阵不能为空")

    rows_a, cols_a = len(mat_a), len(mat_a[0])
    rows_b, cols_b = len(mat_b), len(mat_b[0])

    if rows_a != rows_b or cols_a != cols_b:
        raise ValueError(f"矩阵维度不匹配,无法相加: ({rows_a}x{cols_a}) vs ({rows_b}x{cols_b})")

    # 使用列表推导式直接生成求和矩阵
    result = [
        [mat_a[i][j] + mat_b[i][j] for j in range(cols_a)]
        for i in range(rows_a)
    ]
    return result

# 示例运行
a = [[1, 3], [5, 7]]
b = [[2, 4], [6, 8]]
sum_res = add_matrices(a, b)
print("矩阵加法结果:", sum_res)  # 输出: [[3, 7], [11, 15]]
同样地,通过嵌套循环也可以轻松实现矩阵的条件掩码变换。例如将主对角线元素(i == j)翻倍,或者将小于特定阈值的元素置零:
def mask_matrix(mat, threshold=5):
    """将小于阈值的元素置零,主对角线元素放大两倍"""
    rows, cols = len(mat), len(mat[0])
    res = [[0] * cols for _ in range(rows)]
    for i in range(rows):
        for j in range(cols):
            val = mat[i][j]
            if i == j:
                res[i][j] = val * 2
            elif val >= threshold:
                res[i][j] = val
            else:
                res[i][j] = 0
    return res
六、经典操作案例三:矩阵乘法(三重循环点积拆解)
如果说矩阵加法和转置展示了双重循环的威力,那么矩阵乘法(Matrix Multiplication)则是展示多层嵌套逻辑的终极典型案例。矩阵乘法不仅要求多层嵌套循环,更涉及精密的维度相容约束与累加逻辑。
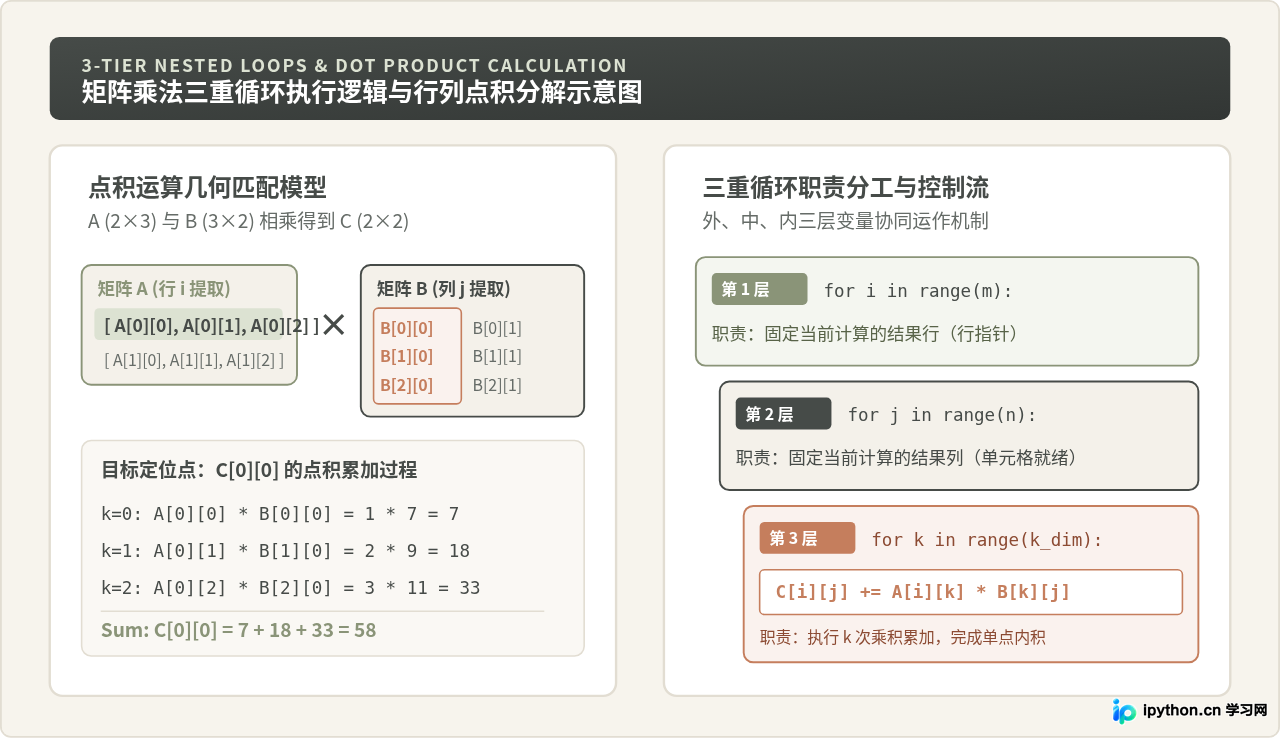
根据线性代数定义,只有当矩阵 $A$ 的列数等于矩阵 $B$ 的行数时,两个矩阵才能相乘。设 $A$ 为 $m \times k$ 矩阵,$B$ 为 $k \times n$ 矩阵,则乘积 $C = A \times B$ 是一个 $m \times n$ 矩阵。其中每个元素 $C[i][j]$ 是 $A$ 的第 $i$ 行向量与 $B$ 的第 $j$ 列向量的点积(对应元素乘积之和):
$$C[i][j] = \sum_{p=0}^{k-1} A[i][p] \times B[p][j]$$
映射到程序执行流程中,这需要三重嵌套循环:
- 第一层循环(变量
i):遍历结果矩阵的行索引,范围为0到m-1; - 第二层循环(变量
j):遍历结果矩阵的列索引,范围为0到n-1; - 第三层循环(变量
k):遍历内部共享维度,累加第i行与第j列各分量的乘积。
下面是矩阵乘法的完整标准实现代码:
def multiply_matrices(mat_a, mat_b):
    """
    计算两个矩阵的乘积 A x B
    :param mat_a: 尺寸为 m x k 的二维矩阵
    :param mat_b: 尺寸为 k x n 的二维矩阵
    :return: 尺寸为 m x n 的乘积矩阵
    """
    if not mat_a or not mat_b or not mat_a[0] or not mat_b[0]:
        raise ValueError("输入矩阵不能为空")

    m = len(mat_a)
    k_a = len(mat_a[0])
    k_b = len(mat_b)
    n = len(mat_b[0])

    # 核心约束:A的列数必须等于B的行数
    if k_a != k_b:
        raise ValueError(f"无法进行矩阵乘法:A 的列数 ({k_a}) 不等于 B 的行数 ({k_b})")

    # 1. 预分配结果矩阵 C,尺寸为 m x n
    result = [[0] * n for _ in range(m)]

    # 2. 三重循环计算点积
    for i in range(m):          # 第一层:遍历 A 的行
        for j in range(n):      # 第二层:遍历 B 的列
            dot_sum = 0
            for k in range(k_a): # 第三层:沿共享维度累加
                dot_sum += mat_a[i][k] * mat_b[k][j]
            result[i][j] = dot_sum

    return result

# 验证测试
matrix_a = [
    [1, 2, 3],
    [4, 5, 6]
]  # 2x3

matrix_b = [
    [7, 8],
    [9, 1],
    [2, 3]
]  # 3x2

product = multiply_matrices(matrix_a, matrix_b)
print("矩阵相乘结果 (2x2):", product)
# 计算验证:
# C[0][0] = 1*7 + 2*9 + 3*2 = 7 + 18 + 6 = 31
# C[0][1] = 1*8 + 2*1 + 3*3 = 8 + 2 + 9 = 19
# C[1][0] = 4*7 + 5*9 + 6*2 = 28 + 45 + 12 = 85
# C[1][1] = 4*8 + 5*1 + 6*3 = 32 + 5 + 18 = 55
# 实际输出: [[31, 19], [85, 55]]
七、执行效率、控制跳转与最佳实践总结
在编写包含嵌套循环的程序时,随着嵌套层数的增加,代码的时间复杂度和控制逻辑复杂度都会急剧上升。为了写出健壮且高效的代码,我们需要在控制流与工程性能上遵循以下准则:
1. 提前退出与多层循环打断(Break)
Python 中的 break 语句仅会跳出其所在的那一层直接循环。在嵌套循环中,如果在内层循环遇到 break,程序只是终止了当前的内层遍历,外层循环仍然会继续推进到下一个 i。如果业务场景需要在找到目标元素后一次性彻底跳出全部循环,常见且优雅的处理方案有两种:
- 方案一:封装为独立函数,使用
return直接返回。这是最为清晰、最 Pythonic 的做法; - 方案二:使用标志位(Flag)或
for...else结构。在内层找到目标后设置found = True并break,外层随后检查该标志位决定是否再次break。
# 方案一示例:在矩阵中检索目标坐标并直接返回
def find_element(matrix, target):
    for r, row in enumerate(matrix):
        for c, val in enumerate(row):
            if val == target:
                return (r, c)  # 直接退出所有嵌套层级
    return None
2. 时间复杂度与性能规模考量
双重嵌套循环的时间复杂度通常为 $O(M \times N)$,在方阵情况下为 $O(N^2)$;而三重嵌套循环的矩阵乘法复杂度为 $O(M \times K \times N)$,在 $N \times N$ 矩阵下为 $O(N^3)$。当数据规模较小时(例如行、列在百级以内),纯 Python 列表运行毫无压力;但当矩阵规模达到千级以上时,纯 Python 解释器在动态类型解包和对象寻址上的开销将十分显著。
在面对大规模科学计算、深度学习或高频图像矩阵处理时,应当在明确算法原理后,无缝迁移至 C 语言底层加速的 NumPy 库(使用 numpy.dot() 或 @ 操作符),它能通过连续内存块分配和 SIMD 指令集实现数百倍的吞吐提升。
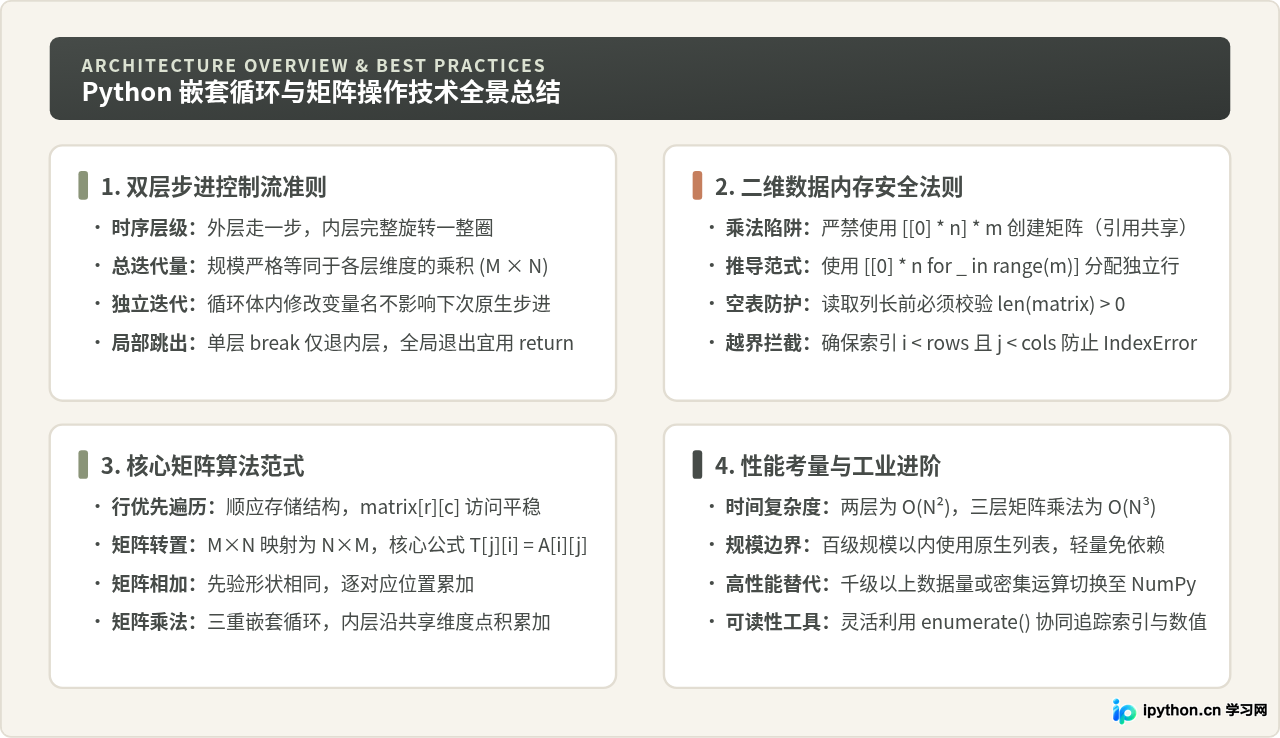
综上所述,Python 嵌套循环的本质在于精确的层次驱动与状态推进。在进行矩阵操作时,只要时刻警惕浅拷贝引用陷阱、规范使用列表推导式,并在多维运算中理清内外层索引的物理意义,便能游刃有余地完成各类复杂的二维数据处理任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









