

Python批量生成随机小数的Numpy实现技巧
详细介绍使用 Python 的 Numpy 库批量高效生成随机小数的核心技术与实现技巧,涵盖现代 Generator 接口、指定区间映射、多维张量生成、离散步长控制与内存优化实践。
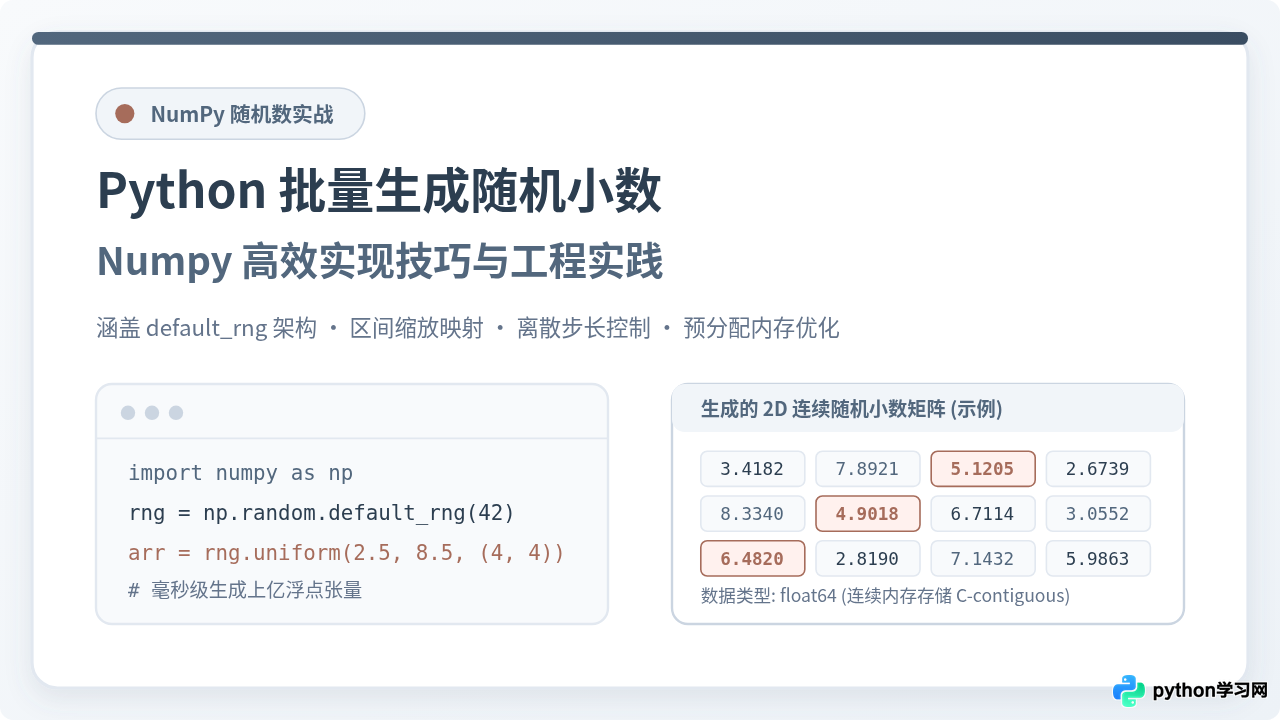
random.random() 在单次标量调用时非常直观,但面对数十万甚至上亿规模的批量数据时,列表推导与解释器循环会带来高昂的性能瓶颈。NumPy 提供了基于 C 语言底层的紧凑连续内存存储和高度矢量化的生成引擎。本文将围绕 NumPy 官方推荐的现代 Generator 接口,全面解析从标准区间、任意区间映射、离散步长控制到内存预分配的完整实现技巧。
一、现代生成器核心接口与标准区间批量生成
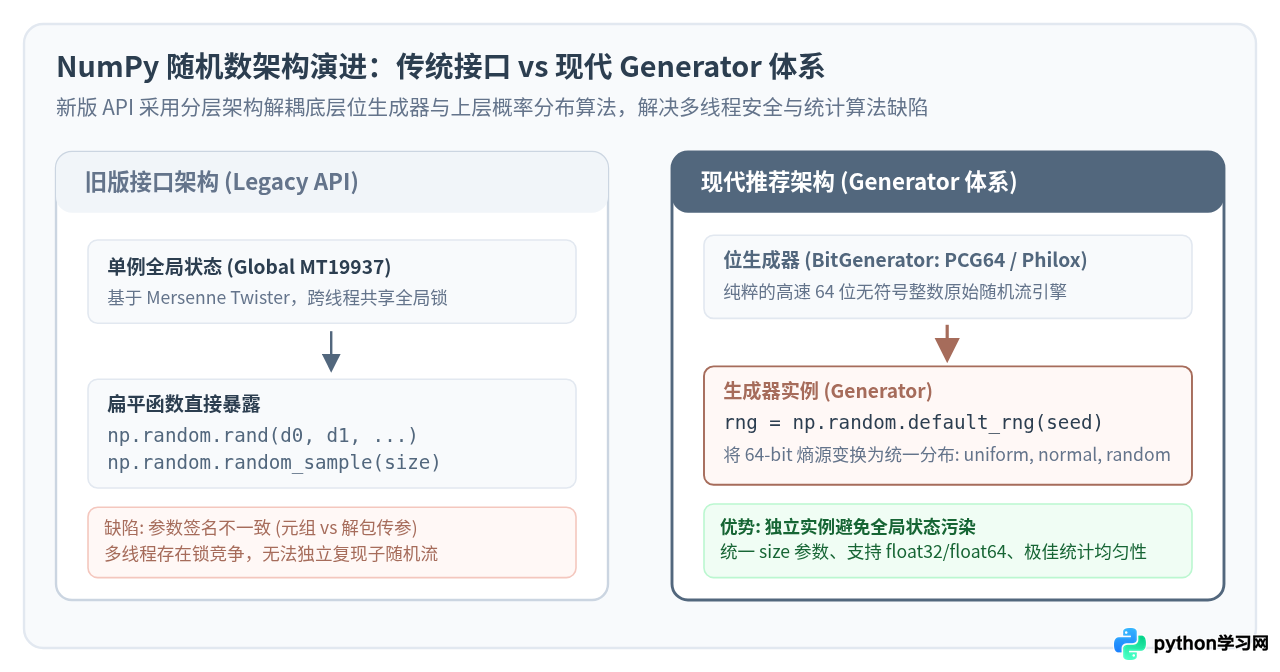
从 NumPy 1.17 开始,NumPy 重构了随机数子系统,引入了分层架构:底层使用高效的位生成器(默认为 PCG64 引擎),上层提供面向对象的 Generator 实例。与早期的全局函数相比,现代 API 具有独立的内部状态、更好的统计随机性质,并且天然支持多线程无锁并发。
1. 实例化生成器与基础调用
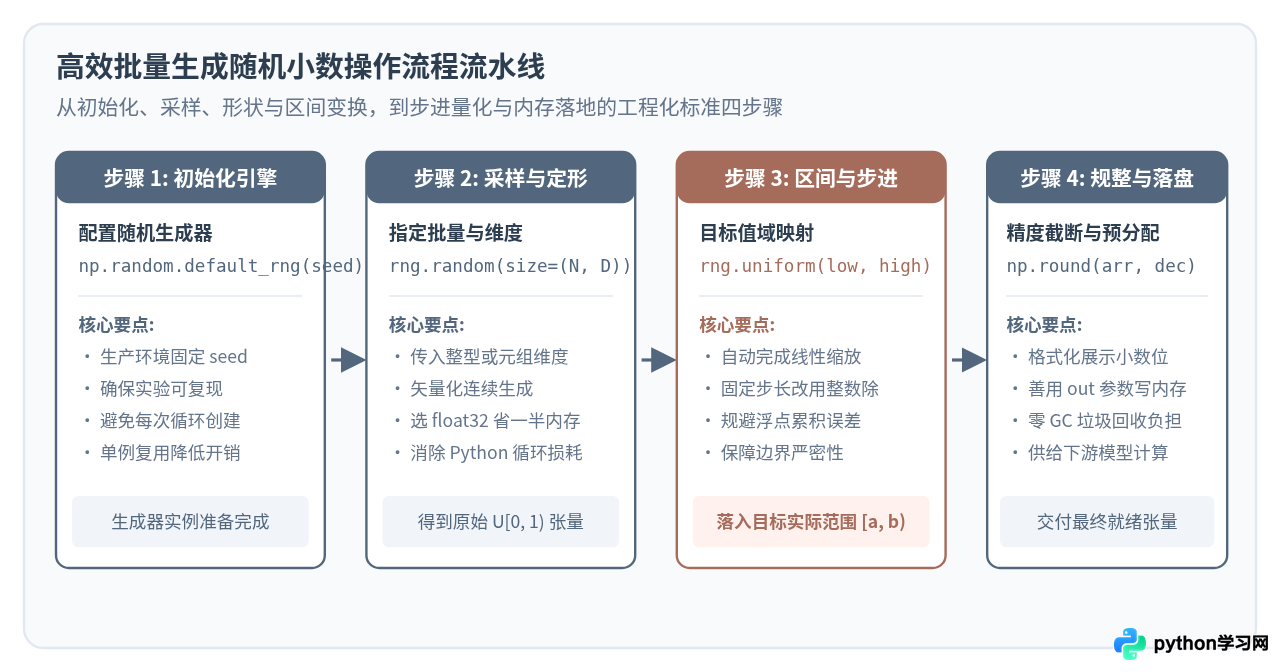
批量生成随机小数的第一步是创建生成器实例。通过调用 np.random.default_rng() 即可获取:
import numpy as np

# 实例化现代生成器,传入固定种子确保实验结果可重复
rng = np.random.default_rng(seed=42)

# 批量生成 5 个位于 [0.0, 1.0) 之间的标准浮点数
floats_1d = rng.random(size=5)
print("一维数组输出示例:", floats_1d)
# 示例输出: [0.77395605 0.43887844 0.85859792 0.69736803 0.09417735]
rng.random(size) 是生成半开区间 [0.0, 1.0) 内均匀分布连续小数的基础函数。这里的 size 参数不仅支持整数,还支持表示多维维度的元组。例如 size=(3, 4) 即可直接生成 3 行 4 列的二维随机矩阵,无需后续调用 reshape(),数据在内存中以连续的 C-contiguous 结构一次性排布完成。
2. 精度控制:单精度 float32 与双精度 float64
默认情况下,rng.random() 输出双精度浮点数(np.float64,占用 8 字节)。但在深度学习张量初始化或大规模蒙特卡洛模拟场景下,单精度浮点数(np.float32,占用 4 字节)已能满足大多数精度要求,且能直接节省一半的系统内存与显存带宽。
# 生成单精度 float32 随机小数张量
floats_32 = rng.random(size=(1000, 1000), dtype=np.float32)
print("数据类型:", floats_32.dtype, "内存占用(MB):", floats_32.nbytes / (1024 * 1024))
# 示例输出: 数据类型: float32 内存占用(MB): 3.814697265625np.random.rand()?
旧版接口中的 np.random.rand(d0, d1, ...) 接受变长解包参数而非元组,与 NumPy 其他函数风格脱节;更关键的是,旧版 API 共享全局 Mersenne Twister 状态,在多线程环境下需要加互斥锁,且可能导致不可预期的伪随机序列污染。新版 default_rng 的分层结构彻底解决了这一历史包袱。
二、任意区间 [a, b) 映射与分布采样技巧
在实际业务中,我们很少直接使用 [0.0, 1.0) 的原始数据,更多场景需要生成特定范围的小数,例如温度传感器读数 [-20.0, 50.0) 或概率权重 [0.1, 0.9)。
1. 专用方法:rng.uniform()
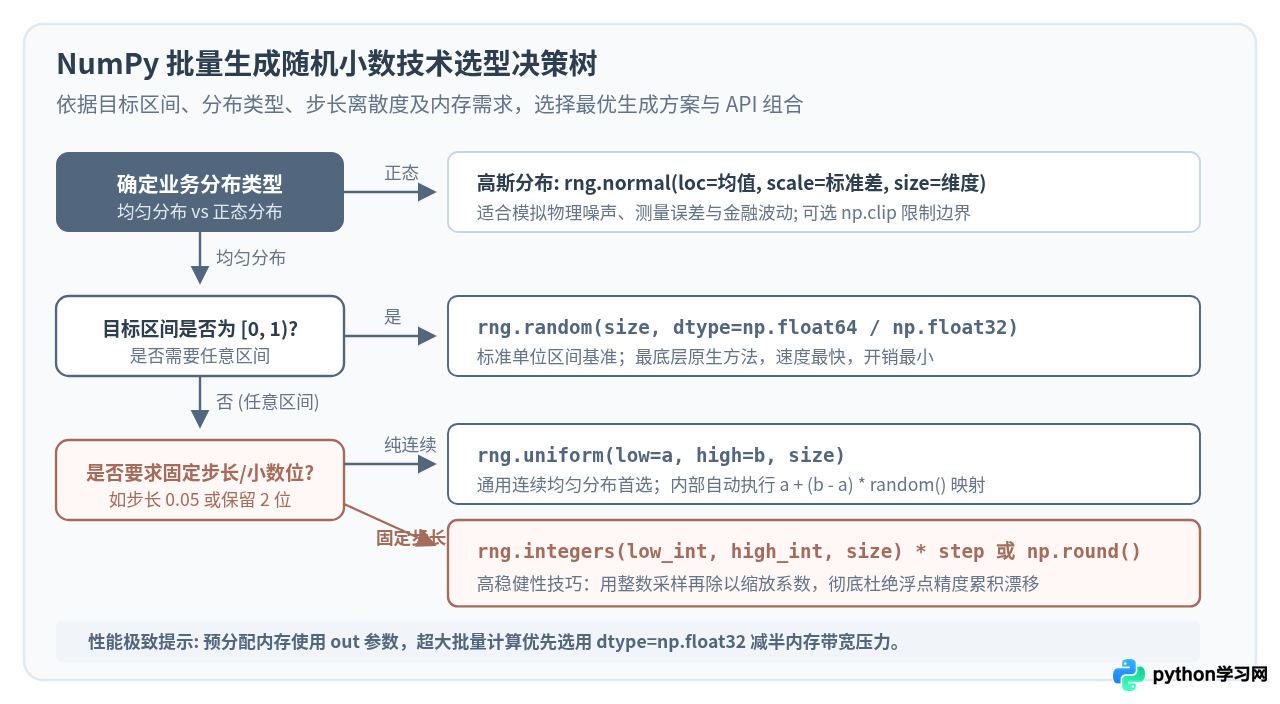
NumPy 提供了专门用于生成指定区间连续均匀随机数的函数 uniform(low, high, size):
# 在区间 [2.5, 8.5) 内批量生成 4x4 的随机小数矩阵
matrix_uniform = rng.uniform(low=2.5, high=8.5, size=(4, 4))
print("均匀区间矩阵:")
print(matrix_uniform)
2. 底层数学映射原理与矢量化实现
理解 uniform 的底层数学逻辑有助于在自定义计算图中进行高效拓展。设标量或张量随机变量 $X \sim U[0, 1)$,要将其平移缩放到区间 $[a, b)$,其线性代数变换公式为:
$Y = a + (b - a) imes X$
借助 NumPy 的广播机制,我们可以用一行代码实现不同通道具有不同区间上下界的批量变换:
# 场景:三个不同特征分别需要不同的区间范围
lows = np.array([10.0, 100.0, -5.0])
highs = np.array([20.0, 200.0, 5.0])

# 生成 5 行 3 列的标准随机小数,并利用广播一次性完成各列的缩放
raw_floats = rng.random(size=(5, 3))
scaled_floats = lows + (highs - lows) * raw_floats
print("多通道自适应缩放结果 shape:", scaled_floats.shape)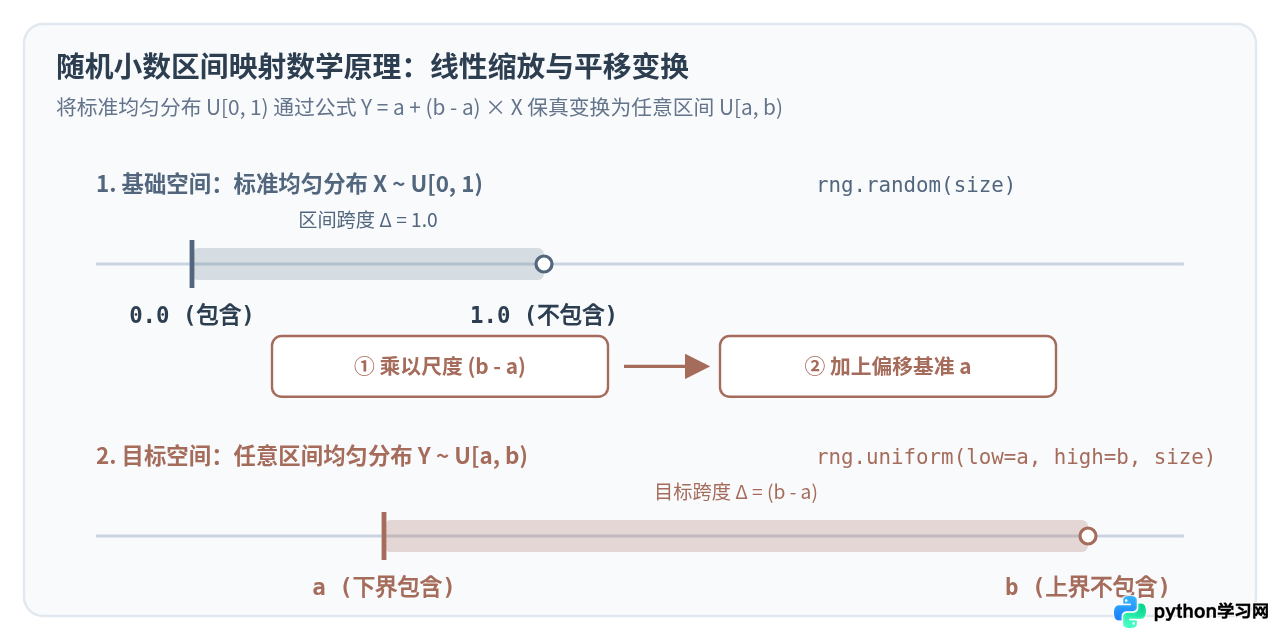
三、控制有效小数位数与生成固定步长小数
随机小数的“位数”在计算机底层实质上是浮点数格式化与量化的问题。IEEE 754 标准下浮点数以二进制科学计数法存储,直接使用浮点运算经常会出现 0.1 + 0.2 = 0.30000000000000004 的精度微差。
1. 四舍五入保留指定小数位:np.round()
如果目的是将连续随机小数规整到常见的小数位数(如价格保留 2 位小数、坐标保留 4 位小数),直接使用 np.round() 即可:
raw = rng.uniform(low=10.0, high=20.0, size=5)
# 保留 2 位小数
rounded_2dec = np.round(raw, decimals=2)
print("原始浮点:", raw)
print("保留两位:", rounded_2dec)
# 示例输出: 保留两位: [14.28 18.91 11.53 17.65 13.04]
NumPy 的 np.round 采用“四舍六入五成双”(Round half to even)规则。当遇到尾数为精确的 5 时,会向最近的偶数舍入(例如 1.5 舍入为 2.0,2.5 同样舍入为 2.0)。这在大量统计运算中能有效消除系统性正向偏差,与日常口算四舍五入略有不同。
2. 生成严格固定步长小数的高级技巧(整数缩放法)
若业务要求生成的随机小数必须以固定步长跳跃(例如 0.05 步长:只能产生 1.00, 1.05, 1.10, ...),通过浮点连续生成后再取舍容易因二进制精度缺失出现偏差。工程上最稳健、最高性能的做法是:先抽取离散整数,再整体除以缩放系数。
# 目标:在 [1.00, 5.00] 区间内生成步长为 0.05 的随机小数
step = 0.05
multiplier = int(1 / step)  # 20
min_val, max_val = 1.0, 5.0

# 转换为整数范围: 20 到 100
low_int = int(min_val * multiplier)
high_int = int(max_val * multiplier) + 1  # 半开区间需加 1

# 批量抽取整数并矢量化缩放
random_integers = rng.integers(low=low_int, high=high_int, size=6)
stepped_floats = random_integers / multiplier

print("固定步长 0.05 随机小数序列:", stepped_floats)
# 示例输出: [3.45 1.20 4.85 2.15 5.00 1.95]
这种“整数离散采样 + 标量缩放”的方法保证了每一个生成的浮点数都严格落在步长格点上,且由于 rng.integers 的内部算法经过严格优化,运行速度比连续浮点取整更加迅速。
四、工程实战:内存预分配、性能基准与避坑指南
当数据吞吐量上升至亿级规模,或者在需要每秒迭代数百次的在线模拟程序中,频繁分配与销毁大数组会频繁触发 Python 垃圾回收机制(GC),显著拉低系统响应。
1. 预分配内存与 out 参数复用
NumPy 的 random 与大多数数学函数均支持 out 参数。通过复用同一块预先分配好的连续内存缓冲区,可实现完全无动态内存申请的流式数据生成:
# 预分配 10,000,000 个 float32 元素的共享缓冲区
buffer = np.empty(shape=(10_000_000,), dtype=np.float32)

# 循环中复用同一块内存,避免反复向 OS 申请与释放堆空间
for batch_id in range(3):
    rng.random(out=buffer)  # 直接将生成的随机数就地覆写到 buffer 中
    # 模拟下游计算逻辑: 如统计首个元素
    print(f"批次 {batch_id} 首元素:", buffer[0])
2. 性能对比:NumPy 矢量化 vs 原生 Python 循环
为了直观展现矢量化的威力,我们在相同环境下生成 10,000,000 个在 [0.0, 100.0) 区间的小数:
| 实现方案 | 典型执行耗时 (1000万数据) | 相对加速比 | 内存控制特性 |
|---|---|---|---|
原生 [random.uniform(0, 100) for _ in range(N)] |
约 1850 ms | 1.0x (基准) | 产生千万级 Python 浮点对象,开销巨大 |
传统旧接口 np.random.uniform(0, 100, N) |
约 68 ms | ~27x | 连续内存,存在全局锁限制 |
现代接口 rng.uniform(0, 100, N) (float64) |
约 42 ms | ~44x | 无锁独立实例,PCG64 高速引擎 |
现代接口 rng.random(N, dtype=np.float32) * 100 |
约 21 ms | ~88x 加速 | 内存减半,矢量化 SIMD 寄存器吞吐最大化 |
五、常见问题排查与注意事项
-
多进程环境产生重复随机数:如果使用 Python 的
multiprocessing模块,在主进程中创建好rng后再fork到子进程,子进程将继承完全相同的生成器内部状态,导致各子进程生成一模一样的数据。正确做法是在每个子进程的入口函数中通过np.random.default_rng()独立初始化,或使用SeedSequence.spawn()派生独立的子随机种子流。 -
区间端点闭合性问题:无论是
rng.random()还是rng.uniform(low, high),在数学定义上均为左闭右开区间 $[low, high)$。由于浮点数在接近上限时的离散间隙,理论上极小概率可能因舍入逼近甚至触及上限,若业务逻辑对右边界有严格隔离要求,建议通过np.clip(arr, low, high - 1e-9)进行防御性约束。 -
避免与 Python 标量函数混用:切勿对已生成的 NumPy 数组使用 Python 内置的
round()函数或通过for x in arr进行逐项格式化,这会把连续高效的 C 底层数组强行拆解回庞大的 Python 标量对象,导致矢量化性能完全丧失。请始终保持在 NumPy 提供的数组方法(如np.round,np.floor,np.trunc)体系内操作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









