

Python处理海量复杂CSV数据:多进程与算法优化实战

发布时间:2026-10-15| 3人浏览过
本文深入解析Python处理海量且逻辑复杂的CSV文件方案。针对千万级数据,采用分批读取、多进程计算与多线程I/O结合策略,利用chunksize与category类型优化内存。通过类对象映射、遍历算法重构及NumPy函数加速,显著提升处理效率,实现从小时级到分钟级的性能跨越。
项目简介
受限于项目保密协议,此处仅概述核心挑战。
- 数据规模庞大:本项目涉及CSV文件处理,其显著特征为数据量极大。首个示例文件包含110余万行,属常规规模;第二个文件增至4500万行;据推测,第三个文件体量约为第二个的40倍,可能高达二十亿行,虽未获取完整样本,但体量之巨可见一斑。
- 业务逻辑繁琐:需对CSV每行数据的多种组合进行判断,业务规则复杂。在确保高处理效率的前提下解决复杂逻辑,是主要难点之一。
项目笔记与心得
1. 分批处理结合多进程与多线程加速
- 鉴于数据量巨大,必须分批处理,否则不仅效率低下,更可能因内存不足导致失败。需使用chunksize参数分块读取。此外,为节省内存并提升效率,文本类数据建议存储为“category”格式:
- 项目整体属于计算密集型任务,因此需引入多进程以充分利用CPU多核性能;
- 采用多线程负责数据的读取与写入,其中写入操作利用to_csv的增量写入功能,将mode参数设置为'a';
- 多进程与多线程通常以死循环形式运行,需在适当位置插入结束信号,以便处理完成后安全退出进程或线程。
"""鉴于项目保密需要,以下代码仅为示例"""
import time
import pathlib as pl
import pandas as pd
from threading import Thread
from multiprocessing import Queue, Process, cpu_count
# 导入多线程Thread,多进程的队列Queue,多进程Process,CPU核数cpu_count
# 存放分段读取的数据队列,注:maxsize控制队列的最大数量,避免一次性读取到内存中的数据量太大
data_queue = Queue(maxsize=cpu_count() * 2)
# 存放等待写入磁盘的数据队列
write_queue = Queue()
def read_data(path: pl.Path, data_queue: Queue, size: int = 10000):
    """
    读取数据放入队列的方法
    :return:
    """
    data_obj = pd.read_csv(path, sep=',', header=0, chunksize=size, dtype='category')
    for idx, df in enumerate(data_obj):
        while data_queue.full():  # 如果队列满了,那就等待
            time.sleep(1)
        data_queue.put((idx + 1, df))
    data_queue.put((None, None))  # 放入结束信号
def write_data(out_path: pl.Path, write_queue: Queue):
    """
    将数据增量写入CSV的方法
    :return:
    """
    while True:
        while write_queue.empty():
            time.sleep(1)
        idx, df = write_queue.get()
        if df is None:
            return  # 结束退出
        df.to_csv(out_path, mode='a', header=None, index=False, encoding='ansi')  # 输出CSV
def parse_data(data_queue: Queue, write_queue: Queue):
    """
    从队列中取出数据,并加工的方法
    :return:
    """
    while True:
        while write_queue.empty():
            time.sleep(1)
        idx, df = data_queue.get()
        if df is None:  # 如果是空的结束信号,则结束退出进程,
        # 特别注意结束前把结束信号放回队列,以便其他进程也能接收到结束信号!!!
            data_queue.put((idx, df))
            return
        """处理数据的业务逻辑略过"""
        write_queue.put((idx, df))  # 将处理后的数据放入写队列
# 创建一个读取数据的线程
read_pool = Thread(target=read_data, args=(read_data_queue, *args))
read_pool.start()  # 开启读取线程
# 创建一个增量写入CSV数据的线程
write_pool = Thread(target=write_data, args=(write_data_queue, *args))
write_pool.start()  # 开启写进程
pools = []  # 存放解析进程的队列
for i in range(cpu_count()):  # 循环开启多进程,不确定开多少个进程合适的情况下,那么按CPU的核数开比较合理
    pool = Process(target=parse_data, args=(read_data_queue, write_data_queue, *args))
    pool.start()  # 启动进程
    pools.append(pool)  # 加入队列
for pool in pools:
    pool.join()  # 等待所有解析进程完成
# 所有解析进程完成后,在写队列放入结束写线程的信号
write_data_queue.put((None, None))
write_pool.join()  # 等待写线程结束
print('任务完成')
2. 优化算法以提高效率
将类对象存入DataFrame列
经过多种方案尝试,最终确定将类对象存入DataFrame列,通过map方法运行类方法,并将结果展开至多列。该方案在本项目中实现了最佳处理效率。
"""鉴于保密需要,以下代码仅为示例"""
class Obj:
    def __init__(self, ser: pd.Series):
        """
        初始化类对象
        :param ser: 传入series
        """
        self.ser = ser  # 行数据
        self.attrs1 = []  # 属性1
        self.attrs2 = []  # 属性2
        self.attrs3 = []  # 属性3
    def __repr__(self):
        """
        自定义输出
        """
        attrs1 = '_'.join([str(a) for a in self.attrs1])
        attrs2 = '_'.join([str(a) for a in self.attrs2])
        attrs3 = '_'.join([str(a) for a in self.attrs3])
        return '_'.join([attrs1, attrs2, attrs3])
    def run(self):
        """运行业务逻辑"""
# 创建obj列,存入类对象
data['obj'] = data.apply(lambda x: Obj(x), axis=1)
# 运行obj列中的类方法获得判断结果
data['obj'] = data['obj'].map(lambda x: x.run())
# 链式调用,1将类对象文本化->2拆分到多列->3删除空列->4转换为category格式
data[['col1', 'col2', 'col3', ...省略]] = data['obj'].map(str).str.split('_', expand=True).dropna(axis=1).astype('category')
# 删除obj列
data.drop(columns='obj', inplace=True)
减少计算次数以提升运行效率
在整体优化过程中,对运行效率提升贡献最大的两项措施如下:
- 一是改进遍历算法,改为直接对整行数据进行综合判断,大幅减少了原本需遍历22种组合的计算与判断次数;
- 二是预先计算特征组合并制成字典,后续直接查询结果,避免重复计算。
使用NumPy加速计算
NumPy仍是数据处理利器,其内置方法效率远高于自定义实现。本项目中使用了bincount、argsort、argmax、flipud、in1d、all等函数,既提升了运行效率,又简化了逻辑判断:
"""numpy方法使用示例"""
import numpy as np
# 计算数字的个数组合bincount
np.bincount([9, 2, 13, 12, 9, 10, 11])
# 输出结果:array([0, 0, 1, 0, 0, 0, 0, 0, 0, 2, 1, 1, 1, 1], dtype=int64)
# 取得个数最多的数字argmax
np.argmax(np.bincount([9, 2, 13, 12, 9, 10, 11]))
# 输出结果: 9
# 将数字按照个数优先,其次大小进行排序argsort
np.argsort(np.bincount([9, 2, 13, 12, 9, 10, 11]))
# 输出结果:array([ 0,  1,  3,  4,  5,  6,  7,  8,  2, 10, 11, 12, 13,  9], dtype=int64)
# 翻转列表flipud
np.flipud(np.argsort(np.bincount([9, 2, 13, 12, 9, 10, 11])))
# 输出结果: array([ 9, 13, 12, 11, 10,  2,  8,  7,  6,  5,  4,  3,  1,  0], dtype=int64)
# 查找相同值in1d
np.in1d([2, 3, 4], [2, 9, 3])
# 输出结果: array([ True,  True, False]) 注:指2,3True,4False
np.all(np.in1d([2, 3], [2, 9, 3]))
# 输出结果: array([ True,  True])
# 是否全是all
np.all(np.in1d([2, 3, 4], [2, 9, 3]))  # 判断组合1是否包含在组合2中
# 输出结果: False
np.all(np.in1d([2, 3], [2, 9, 3]))
# 输出结果: True
优化前后的效率对比
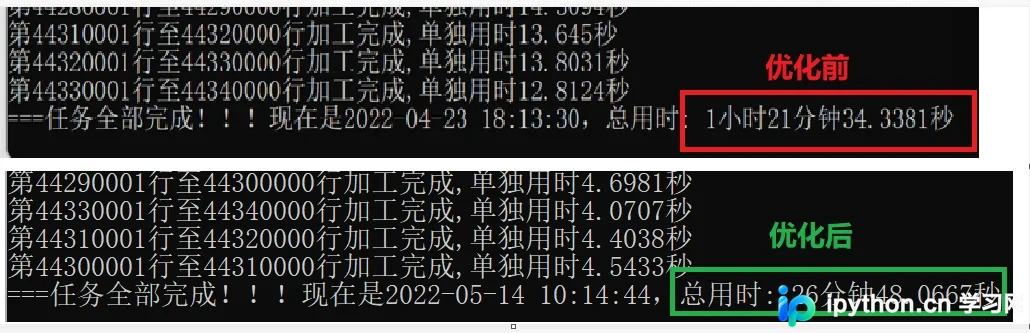
总结
算法优化是本项目耗时最多的工作(无出其右)。4月12日接单,约10天完成初稿,虽可运行但存在两个问题:一是有bug需修正,二是运行效率低(4500万行数据耗时1小时21分钟,若仅在此版本上增加判断条件debug,效率只会更低)。随后20多天持续优化算法并修正bug,最终版本处理相同数据耗时不足30分钟,效率提升一倍以上。回顾来看,尽管调优耗时较长,但每一次尝试,无论成败,均为宝贵经验积累。
至此,关于Python详解复杂CSV文件处理的文章介绍完毕。如需了解更多Python CSV文件处理相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









