

新手学Python爬虫先学哪个库:Requests还是Scrapy
针对Python爬虫初学者的技术选型指南。深入对比Requests与Scrapy的核心定位、运行架构、认知门槛与实操体验,给出明确的入门选型结论与循序渐进的学习演进路线。
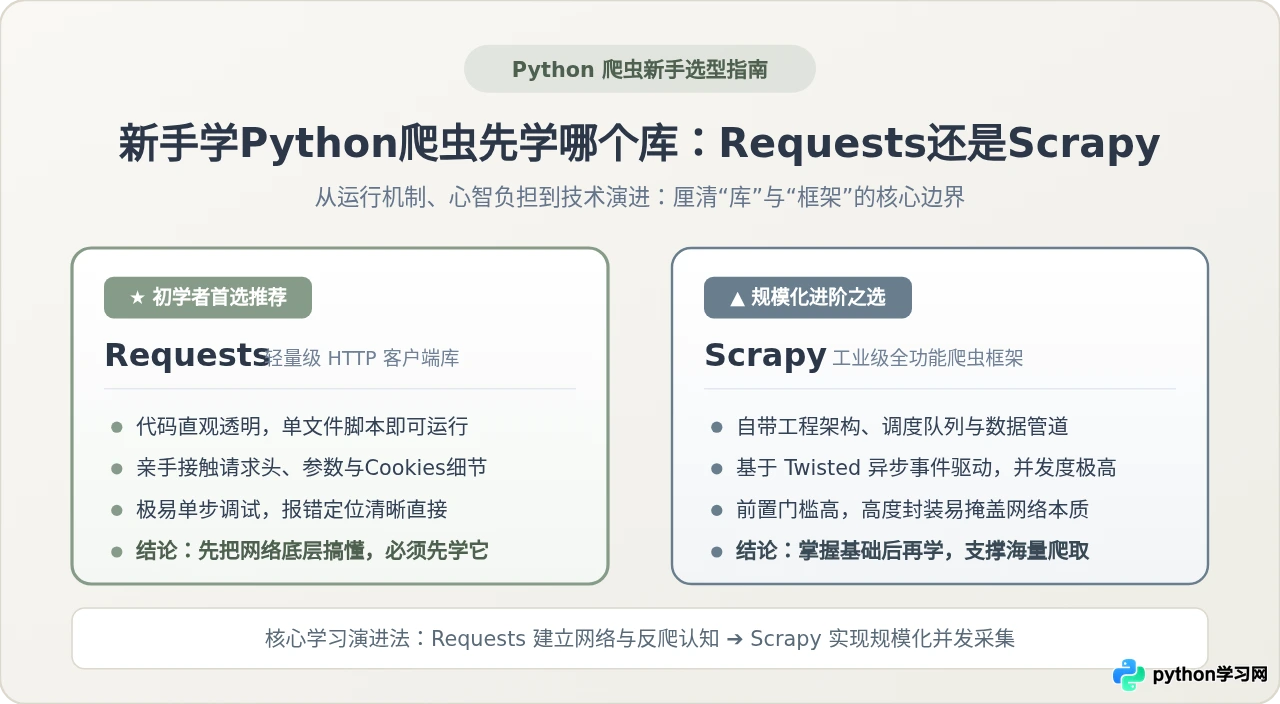
一、定位与设计哲学:“单点工具”与“工程框架”的本质区别
初学者在纠结 Requests 与 Scrapy 时,常误以为它们是同一个维度的“替代品”。事实上,二者在软件设计哲学与抽象层级上完全不同:
- Requests(工具库):它只管网络通信。Requests 的定位是“为人类设计的 HTTP 库”,它的职责边界非常明确——把你的请求参数封装成合法的 HTTP 报文发给服务器,并把服务器返回的字节流解析为状态码、响应头和文本内容。至于页面抓回来之后如何提取字段、如何过滤重复 URL、如何入库保存,Requests 概不干涉,完全由开发者自由搭配 BeautifulSoup、lxml 或 re 完成。
- Scrapy(应用框架):它统领整个爬虫生命周期。Scrapy 不是一个单点函数库,而是一套完整的自动化数据抓取解决方案。它内置了基于 Twisted 的异步事件引擎、请求调度去重队列、Downloader 下载器、中间件拦截链路以及 Item Pipeline 持久化管道。在 Scrapy 中,控制权属于框架(控制反转),开发者必须按照其制定的规范编写 Spider 类、配置中间件和管道。
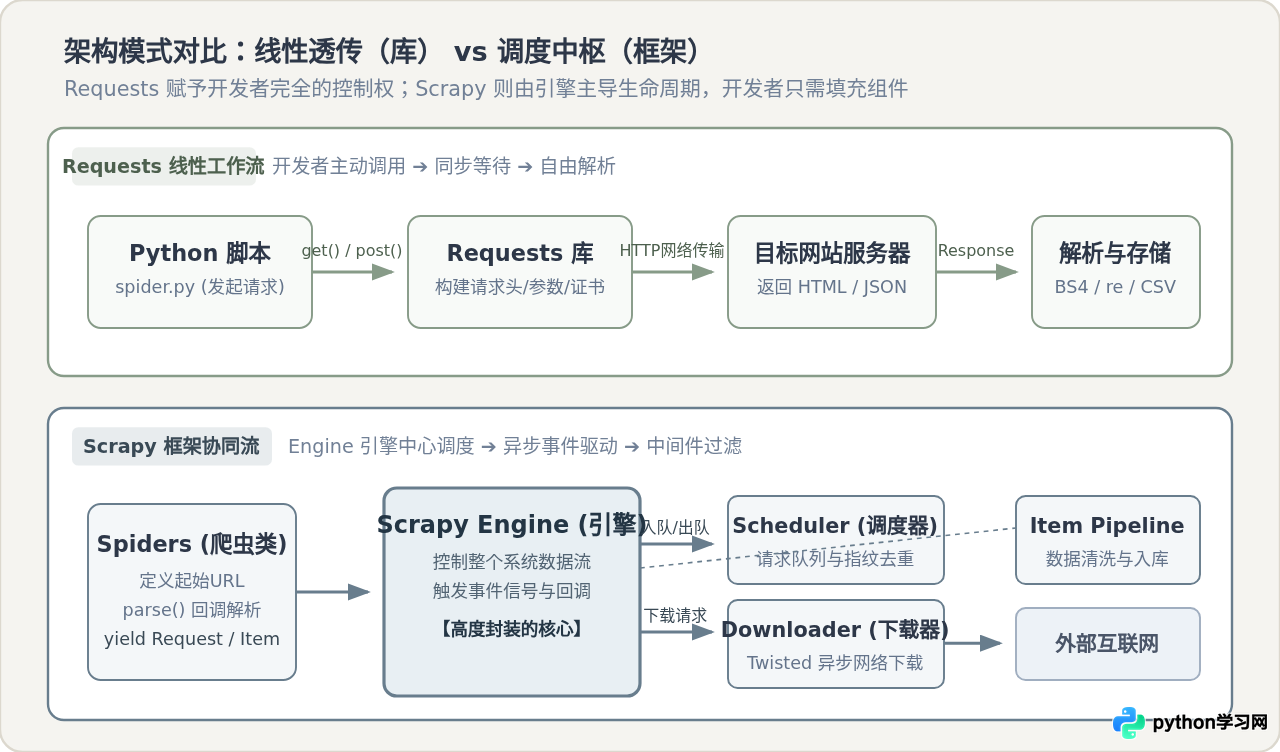
如上图所示,Requests 的运行逻辑是透明且线性的:脚本发起调用,网络传回响应,代码顺次解析。每个变量从哪里来、到哪里去,在本地作用域内一清二楚。而 Scrapy 是事件驱动与中枢调度:爬虫产出请求交由调度器排队,下载器在底层异步取数后回调指定解析函数,中间还穿插了层层中间件。这种设计在面对千万级页面采集时威力巨大,但对初学者而言无异于一座复杂的“黑盒迷宫”。
二、初学者认知负荷对比:为什么直接学 Scrapy 极易被劝退?
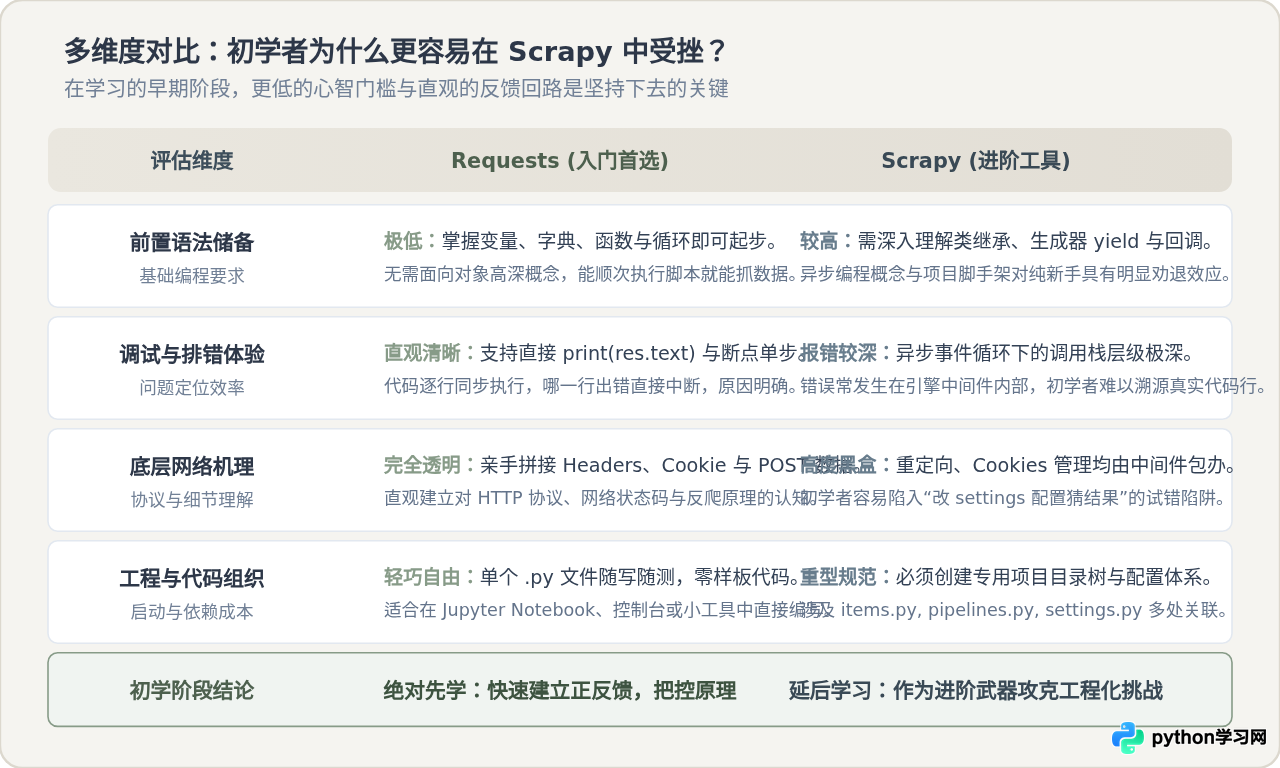
学习任何一门技术,保持“即时正反馈”是坚持下去的核心动力。新手如果跳过基础直接接触 Scrapy,通常会遭遇三座陡峭的认知大山:
1. 前置编程知识的跨度过大
掌握 Requests 只需要具备 Python 基础语法(变量、列表、字典、循环和基本函数)。哪怕是一个只学了两周 Python 的新手,也能顺畅写出 response = requests.get('https://example.com') 并打印结果。而 Scrapy 要求开发者熟练掌握面向对象类继承、生成器 yield、异步回调函数,甚至需要熟悉命令行终端脚手架操作。大量与爬虫核心业务无关的概念同时涌入,会导致新手的大脑快速过载。
2. 异常调试与排错难度悬殊
在 Requests 脚本中,如果爬取出现问题(例如返回 403 状态码或内容为空),开发者可以随时随地插入 print(response.headers)、print(response.text[:200]),或者使用 IDE 的单步断点逐行跟踪。每一行代码的执行结果都是确定的、同步的。但在 Scrapy 的异步事件循环中,一个未捕获的异常往往会喷出数十行深不见底的 Twisted 异步堆栈,错误位置往往隐匿在框架内部组件中,新手很难一眼看出究竟是选择器写错了、中间件被拦截了,还是请求头没有生效。
3. 网络通信底层机理被框架“过度掩盖”
编写爬虫的真正硬功夫,是对 HTTP 协议细节、反爬虫机制对抗的理解。使用 Requests 时,开发者必须亲手构建 headers={'User-Agent': '...'}、亲手管理 requests.Session() 的 Cookies,或者显式配置 proxies 参数。正是这种“亲历其境”的编码过程,让初学者切实掌握了浏览器与服务端的交互机理。若直接使用 Scrapy,自动处理重定向、自动保持 Cookies、自动遵守 robots.txt 等特性会把这些核心细节全盘接管,导致学习者知其然不知其所以然,一旦遭遇定制化反爬便束手无策。
三、实操体验对照:抓取同一个网页的代码差异
为了直观感受两者的上手体验差异,我们以一个最基础的典型任务为例:从一个示例技术博客页面抓取所有文章的标题和链接。
做法 A:使用 Requests + BeautifulSoup(单文件即写即测)
在同级目录下创建一个名为 simple_spider.py 的文件,编写如下 18 行代码即可完成全部抓取任务:
# 环境准备:pip install requests beautifulsoup4
import requests
from bs4 import BeautifulSoup

url = "https://quotes.toscrape.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 1. 发送请求
response = requests.get(url, headers=headers, timeout=10)
response.encoding = "utf-8"

# 2. 解析 HTML 节点
soup = BeautifulSoup(response.text, "html.parser")
quote_items = soup.select("div.quote")

# 3. 提取字段并输出
for item in quote_items:
    text = item.select_one("span.text").get_text(strip=True)
    author = item.select_one("small.author").get_text(strip=True)
print(f"名言:{text} —— 作者:{author}")名言:“The world as we have created it is a process of our thinking...” —— 作者:Albert Einstein
名言:“It is our choices, Harry, that show what we truly are...” —— 作者:J.K. Rowling
名言:“There are only two ways to live your life. One is as though nothing is a miracle...” —— 作者:Albert Einstein
做法 B:使用 Scrapy 框架(必须遵循工程规范)
若使用 Scrapy 完成上述同样的需求,操作步骤则必须遵循其规范化流水线:
- 在终端运行命令创建项目骨架:
scrapy startproject myproject; - 进入项目目录生成爬虫模板:
scrapy genspider quote_spider quotes.toscrape.com; - 编辑
items.py定义字段契约:声明text与author字段; - 编辑
spiders/quote_spider.py编写爬虫类,使用yield返回数据字典或 Item; - 如果需要保存,还需在终端指定输出格式或在
settings.py中开启ITEM_PIPELINES; - 在项目根目录下通过命令行启动:
scrapy crawl quote_spider。
# 文件位置:myproject/spiders/quote_spider.py
import scrapy

class QuoteSpider(scrapy.Spider):
    name = "quote_spider"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["https://quotes.toscrape.com/"]

    def parse(self, response):
        for item in response.css("div.quote"):
            yield {
                "text": item.css("span.text::text").get(),
                "author": item.css("small.author::text").get(),
}四、循序渐进的科学路线:从 Requests 到 Scrapy 的平滑演进
决定了“先学 Requests”并不代表排斥 Scrapy。相反,合理的学习策略是分阶段构建知识图谱,在每一个阶段用最简单工具攻克当前瓶颈:
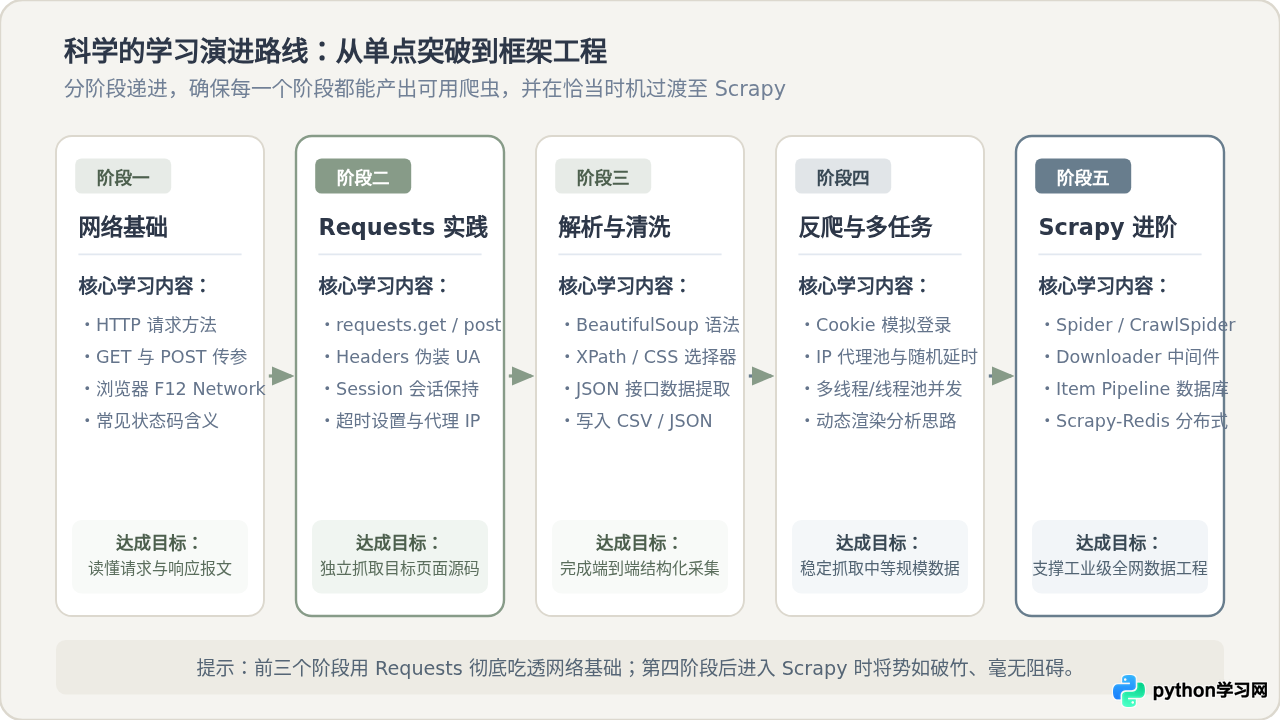
阶段一:网络基础与浏览器抓包(0.5 周)
不写任何代码,打开 Chrome 浏览器的开发者工具(F12)进入 Network(网络)标签页。观察每次页面刷新时浏览器发出的请求列表:理解 URL 地址的组成部分、Query 查询参数、请求头(User-Agent、Referer、Cookie)以及服务端返回的状态码(200、301、403、404、500 等)。把网络交互的本来看清,是写好爬虫的前提。
阶段二:精通 Requests 核心操作(1 周)
在这个阶段,熟练运用 Requests 库完成常见网络通信任务:
- 掌握
requests.get()与requests.post()的参数构造(params与data/json); - 掌握自定义
headers伪装浏览器指纹,解决最基础的防盗链与防护; - 掌握使用
requests.Session()维持登录会话状态与 Cookie 自动流转; - 掌握超时设置
timeout、异常捕获requests.exceptions.RequestException与代理 IP 挂载proxies。
阶段三:HTML 节点解析与数据清洗(1 周)
拿到 response.text 只是爬虫的第一步,接下来需要将非结构化的 HTML 转化为清晰的数据结构。重点练习 BeautifulSoup 或 XPath (lxml)。学会根据 Class、ID 或层级关系精确定位 DOM 节点,提取文本与属性,并将结果保存至本地 CSV、Excel 或 SQLite 数据库中。至此,你已经具备了独立完成 80% 中小型日常数据采集任务的能力。
阶段四:反爬机制对抗与多任务并发(1 周)
当尝试抓取上万条数据或遇到目标站点的安全策略时,开始深入学习:请求频率控制与随机等待、User-Agent 池轮换、IP 代理池集成,以及使用 Python 标准库 concurrent.futures.ThreadPoolExecutor 实现简单的多线程并发提速。
阶段五:进阶 Scrapy 攻坚工业级工程(2 周以上)
当你拥有了扎实的 HTTP 基础与解析经验后,再打开 Scrapy 官方文档,你会发现一切顺理成章:
- 你不再对请求头该写在哪感到困惑,因为你早就知道
DEFAULT_REQUEST_HEADERS映射的就是 HTTP 请求头; - 你对调度器去重的必要性深有体会,因为你在写脚本时早就被重复 URL 困扰过;
- 你明白 Pipeline 管道为什么要把网络IO和数据库写入解耦,因为你自己做过数据持久化;
- 此时的 Scrapy 对你而言不再是难以琢磨的黑盒,而是一个帮你省去大量样板代码的高性能发动机。
五、新手高频疑问与避坑指南
解答:完全不能。直接硬啃 Scrapy 的初学者,通常有 70% 都在前两周因环境配置报错、命令行操作失误、或搞不清 yield 逻辑而中途放弃。更严重的是,即使照着教程敲出了运行代码,一旦目标网站稍作反爬调整(例如加了自定义 Header 或 Token 校验),初学者根本不知道去哪里下断点排查。先学 Requests 不是绕弯路,而是建立排错直觉的必修课。
解答:依然是绝对核心。新手容易陷入“看到动态加载就上 Selenium/Playwright 模拟浏览器”的误区。实际上,成熟的爬虫工程师面对动态网页,第一选择永远是通过 Network 抓包寻找后台返回数据的 JSON 接口。如果能直接用 Requests 或 Scrapy 请求这个底层 API,抓取效率通常是启动无头浏览器的数十倍以上。只有在接口加密极其复杂、逆向成本过高时,才考虑引入自动化浏览器作为兜底方案。
解答:同步并不意味着无法并发。在过渡到 Scrapy 之前,通过 Python 内置的
ThreadPoolExecutor 配合 Requests,或者使用异步库 aiohttp / httpx,就可以轻松跑满普通宽带的连接数。在实际业务中,许多数据量在 10 万以内、结构定制化高的任务,工程师依然优先选择 Requests 脚本,因为开发加维护的总耗时往往比搭建维护一个 Scrapy 工程还要划算。
六、选型决策指南与总结
为了在日后的实际需求中快速作出判断,下表整理了不同场景下的选型参考依据:
| 考量维度 | 选用 Requests(+ 解析库) | 选用 Scrapy 框架 |
|---|---|---|
| 当前技术阶段 | 初学者、刚接触网络爬虫与 HTTP 基础 | 已有稳定爬虫经验,熟悉网络通信机理 |
| 数据量与范围 | 几百至数万页,单站或特定固定列表 | 百万至千万级以上,整站全量多层级抓取 |
| 项目形态 | 单文件轻量脚本、定时小工具、数据分析前期取数 | 企业级长期运行的抓取系统、规范化工程仓库 |
| 页面链接关系 | URL 规律明确(如分页 page=1..100) | 网状多深度自动跟进链接(CrawlSpider 深度遍历) |
| 开发与维护成本 | 极低,随写随测,5 分钟内快速产出可用脚本 | 适中,需要遵循规范创建项目、配置管道与设置项 |
| 分布式扩展 | 需手动编写 Redis 任务队列与消费进程 | 天然支持搭配 Scrapy-Redis 实现多机器分布式调度 |
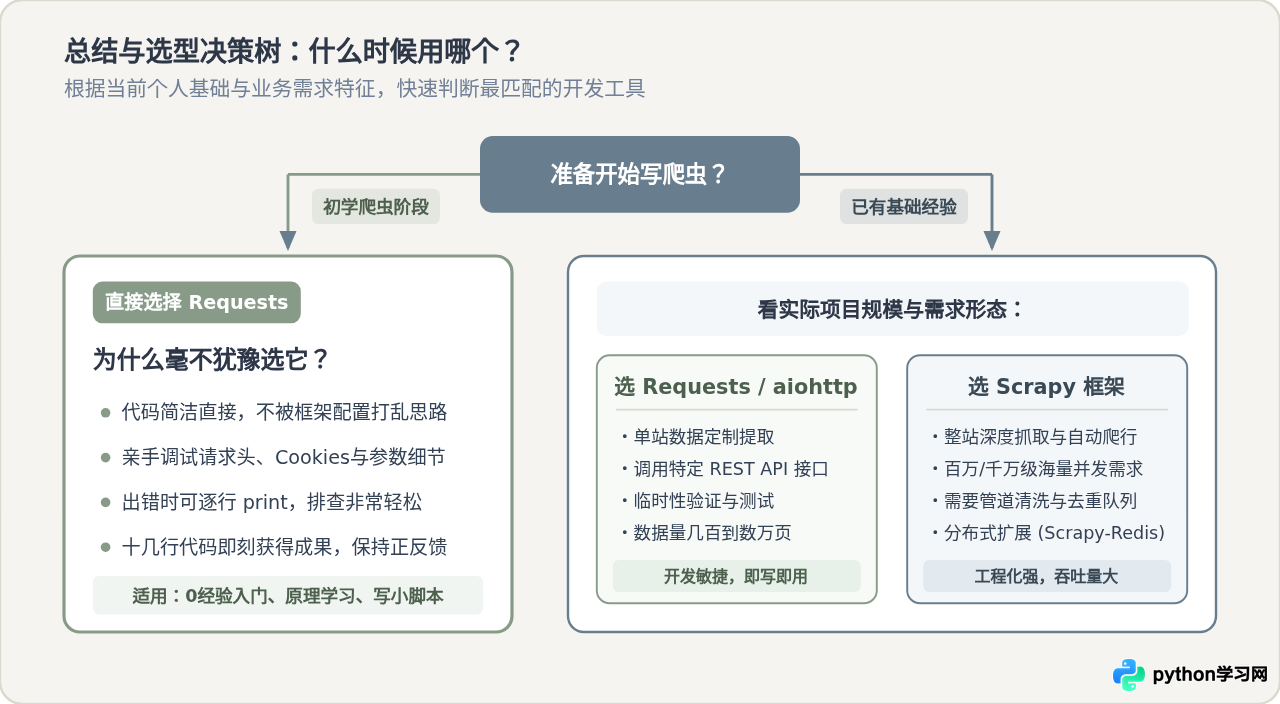
总结而言,“新手学爬虫先学哪个库”这道单选题,答案唯一且明确:先学 Requests。先用 Requests + BeautifulSoup 打通任督二脉,将网络协议、状态处理、反爬原理内化为你肌肉记忆中的一部分;当你真正遇到大规模全站采集、海量队列调度、分布式多机爬取的业务瓶颈时,再祭出 Scrapy 这把重型武器,方能做到游刃有余、事半功倍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









