

Python怎么对列表批量计算绝对值:列表推导式与NumPy方案

在 Python 中对包含多个数值的列表批量计算绝对值,核心解决路径通常分为两种:如果追求原生无依赖、代码直观轻巧,首选 Python 原生内置的列表推导式(List Comprehension)配合 abs() 函数;如果面向科学计算、数据分析或数据量达到十万级以上,则应当采用 NumPy 的向量化函数 np.abs()。本文将分别展开这两套方案的具体实现代码、底层运作原理、性能差异以及在面对混合脏数据时的防护措施,让读者能够在实际工程中准确选型。
一、原生无依赖方案:列表推导式(List Comprehension)
Python 标准库提供了内置函数 abs(),该函数接收单个数值(整数、浮点数或复数)并返回其绝对值。当需要将该操作一次性应用到列表中的所有元素时,列表推导式是 Python 社区最为推荐的 Idiomatic(符合惯用法)实现。
1. 基础用法与代码示例
使用 [abs(x) for x in raw_list] 即可完成逐项映射,生成一个全新的列表,原列表不会被修改:
# 示例:使用列表推导式批量求绝对值
raw_list = [-12, 45, 0, -8.5, 33, -100.2]

# 列表推导式核心表达式
abs_list = [abs(x) for x in raw_list]

print("原始列表:", raw_list)
print("绝对值列表:", abs_list)
# 示例输出:
# 原始列表: [-12, 45, 0, -8.5, 33, -100.2]
# 绝对值列表: [12, 45, 0, 8.5, 33, 100.2]轻量补充:除列表推导式外,Python 还支持 list(map(abs, raw_list))。在纯速度测试中,map(abs, ...) 在 CPython 底层直接调用 C 语言函数指针,执行效率略高于推导式;但列表推导式在可读性、添加过滤条件(如 if 分支)以及符合现代 Python 规范方面更受青睐。
2. 列表推导式的执行过程剖析
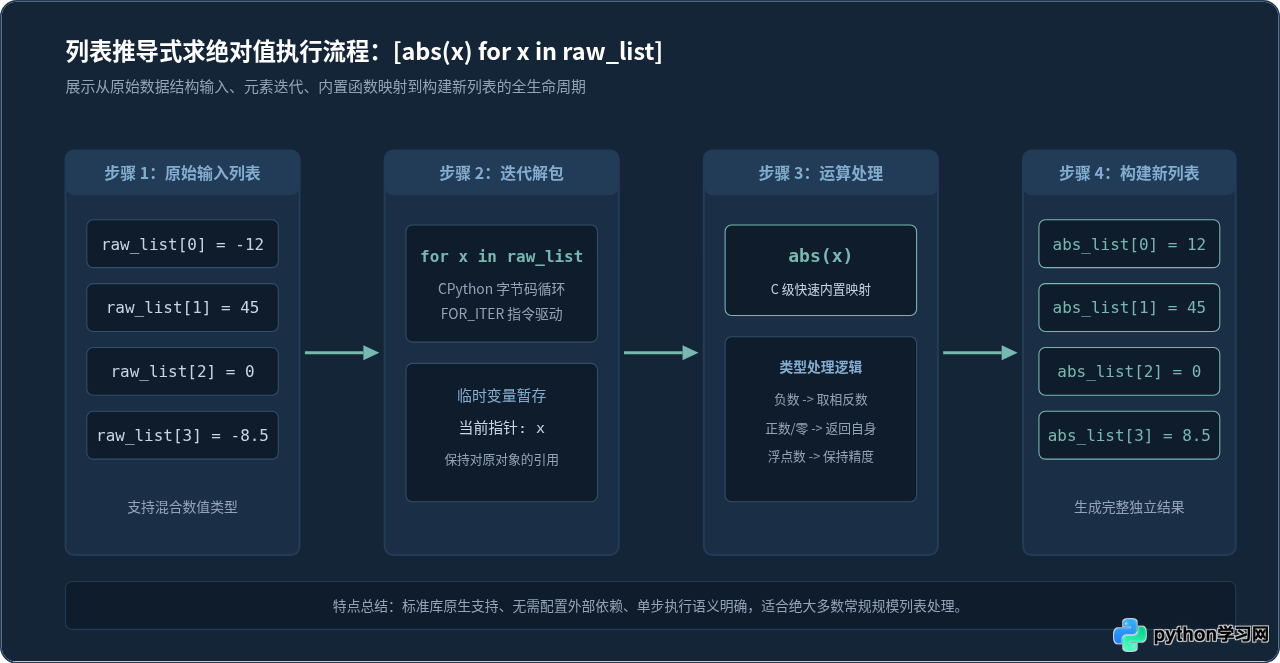
理解列表推导式的关键在于把握其遍历与收集机制:解释器首先申请一块新的列表存储空间,然后基于原列表的迭代器协议依次取出元素指针,调用 C 语言实现的 PyNumber_Absolute 获取绝对值新对象,最后将引用追加进新列表。下图清晰呈现了这一流程:
二、海量数据高性能方案:NumPy 向量化计算
当列表元素规模突破十万级或百万级时,Python 原生列表的底层机制将面临性能瓶颈。Python 原生 list 存储的是对象的引用指针,各对象离散分布在内存堆中,批量求值时 CPU 缓存命中率低,且伴随着 Python 虚拟机反复解包装箱的解释开销。此时,引入科学计算库 NumPy 的 np.abs() 或 np.absolute() 是工业级标准做法。
1. 依赖安装与基础操作代码
若环境中尚未安装 NumPy,需先通过包管理器完成安装:
pip install numpy完成安装后,将原生列表转换为 NumPy 数组(ndarray),调用向量化绝对值函数:
import numpy as np

# 原始大列表
raw_list = [-10, 25, -30, 45, -55, 60]

# 步骤 1:转换为 NumPy 数组并执行向量化求绝对值
arr = np.array(raw_list)
abs_arr = np.abs(arr)

# 步骤 2(可选):如业务必须返回 Python 原生 list
abs_list = abs_arr.tolist()

print("NumPy 计算结果 (ndarray):", abs_arr)
print("转回原生列表:", abs_list)
# 示例输出:
# NumPy 计算结果 (ndarray): [10 25 30 45 55 60]
# 转回原生列表: [10, 25, 30, 45, 55, 60]
2. 内存模型与向量化计算优势对比
NumPy 之所以能够实现数十倍的运算加速,核心在于其底层的连续内存布局与 SIMD(单指令多数据流)向量化硬件支持。下图将 Python 原生列表与 NumPy 数组在底层的内存结构与计算方式进行了清晰的对照:
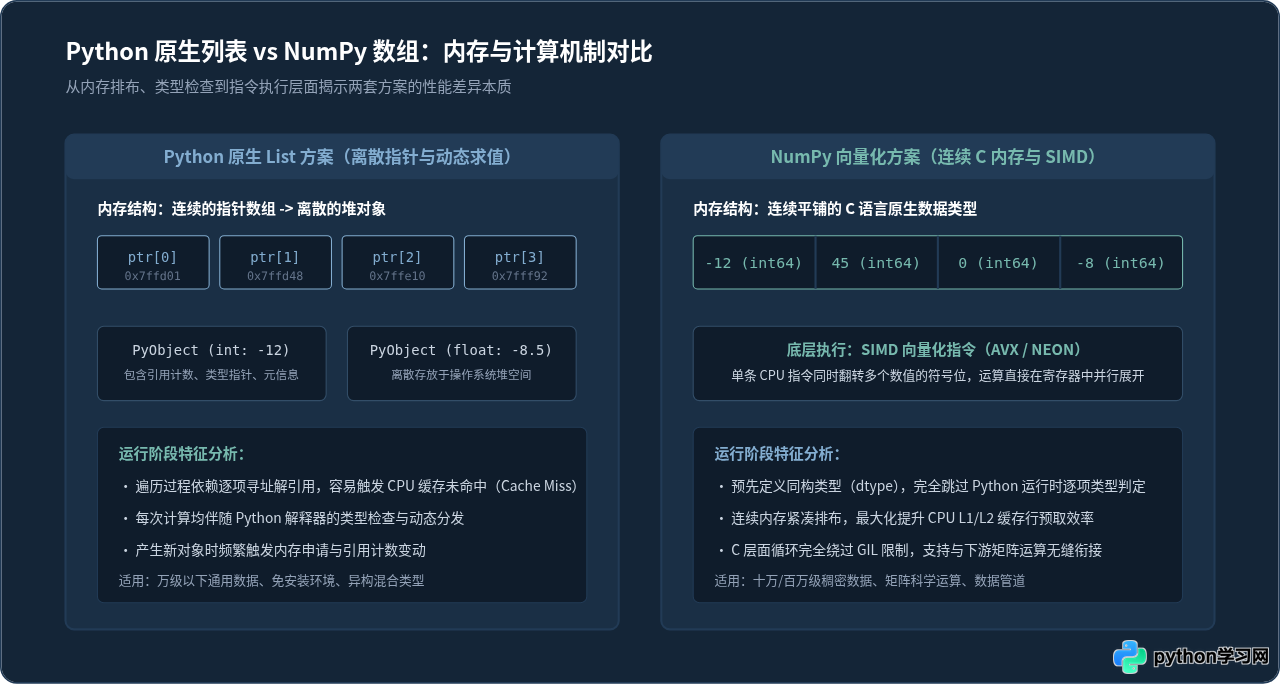
注意类型转换成本:如果原始数据本来就是原生 Python list,且计算完成后业务代码强依赖原生 list 返回,那么执行 np.array(raw_list) 与最后的 .tolist() 都需要遍历并复制内存。因此,在小数据量(例如几千项以内)时,转换开销可能抵消向量化带来的收益;而在持续使用 ndarray 的流水线中,NumPy 拥有压倒性优势。
三、工程实践决策树与防御性处理
在实际生产环境中,列表中的数据往往不仅包含纯粹的数值,还可能混入缺失值 None 或意外的非法类型(如字符串)。此外,选择推导式还是 NumPy,需要综合考虑数据规模与项目依赖约束。
1. 选型流程与决策路径
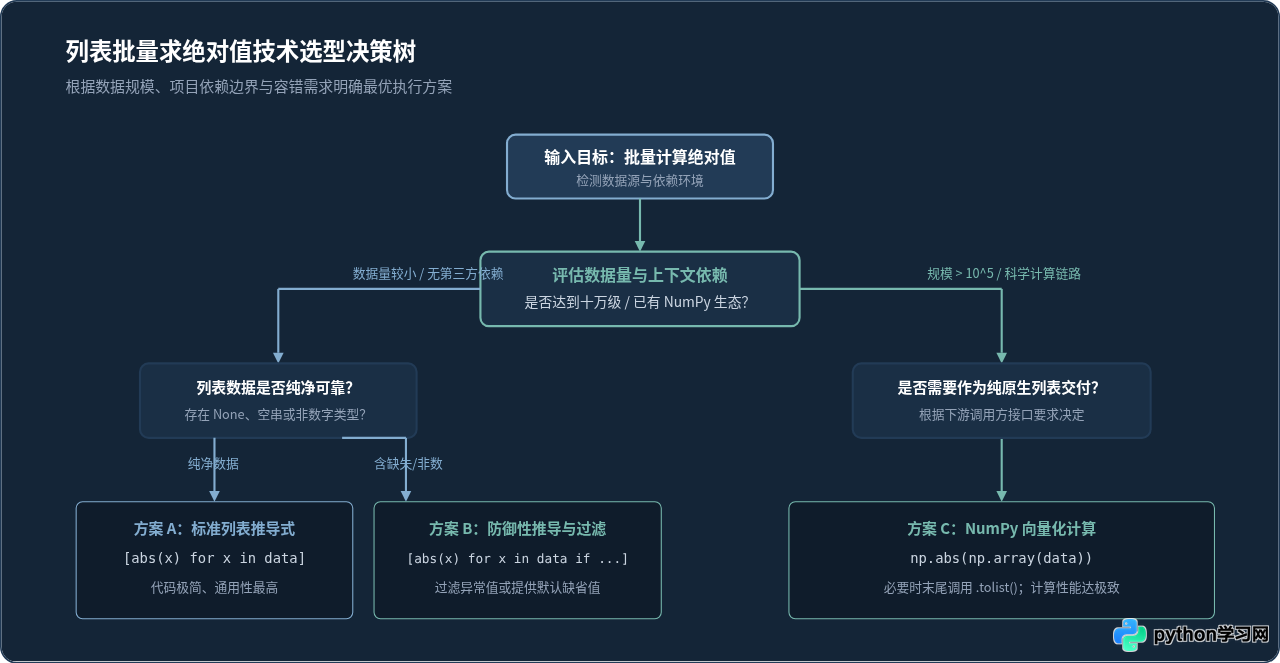
为了帮助开发者在编码时迅速做出技术选型,可参考如下决策路线:
2. 防御性编程:处理混合脏数据
直接执行 abs(x) 时,如果 x 为 None 或字符串,程序会立即抛出 TypeError: bad operand type for abs()。在生产开发中,应利用列表推导式的条件过滤能力进行安全防护:
# 示例:含有 None 和异常类型的脏列表
dirty_list = [-15, 30, None, -4.2, "error_str", 0, -88]

# 防御方案 1:过滤掉非数值元素(仅保留 int 与 float)
safe_abs_list = [abs(x) for x in dirty_list if isinstance(x, (int, float))]
print("过滤后的安全结果:", safe_abs_list)
# 输出: [15, 30, 4.2, 0, 88]

# 防御方案 2:保留列表结构,遇非数值赋予缺省值(如 None 或 0)
tolerant_list = [abs(x) if isinstance(x, (int, float)) else None for x in dirty_list]
print("保留占位的容错结果:", tolerant_list)
# 输出: [15, 30, None, 4.2, None, 0, 88]
四、核心方案全景对比与选型总结
为了让不同方案的技术特征一目了然,下表汇总了各种批量计算方式在不同维度的表现:
| 方案类型 | 核心语法 | 外部依赖 | 小数据吞吐 (N<1000) | 大数据吞吐 (N>10^5) | 典型适用场景 |
|---|---|---|---|---|---|
| 列表推导式 | [abs(x) for x in data] |
无 (内置) | 极快 (纳秒级调用) | 一般 (受解释器循环限制) | 日常业务开发、通用脚本、数据清洗 |
| map 映射 | list(map(abs, data)) |
无 (内置) | 极快 (C函数直接调用) | 较快 | 函数式编程、需要惰性迭代(迭代器模式) |
| NumPy 向量化 | np.abs(arr) |
需安装 numpy |
一般 (有转换开销) | 极快 (SIMD硬件并行) | 科学计算、机器学习特征预处理、大数组运算 |
| 带条件防御推导 | [abs(x) for x in data if ...] |
无 (内置) | 快速 | 一般 | 输入源不可信、含有缺失值或脏数据 |
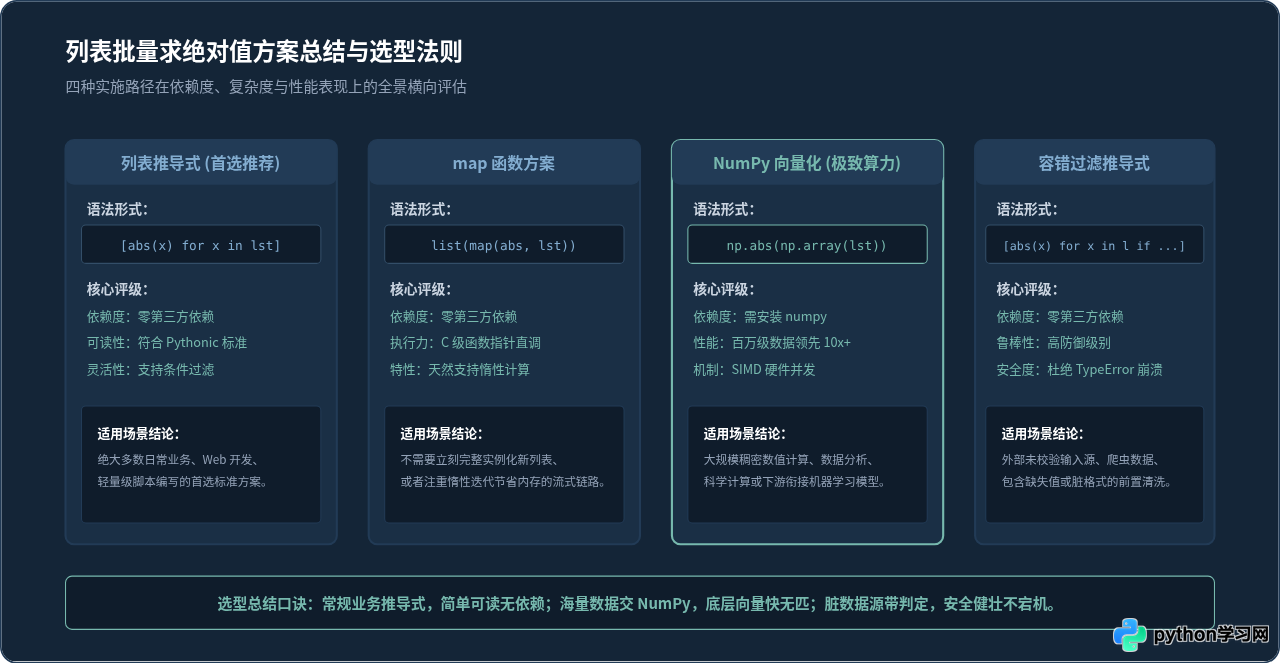
通过本文的讲解,我们可以得出明确的工程结论:在 Python 中处理批量绝对值,90% 的常规业务优先采用 [abs(x) for x in list],即可在保证代码优雅可读的同时获得足够的运行性能;而在面对海量数据或科学计算管道时,直接选用 np.abs(),通过 SIMD 向量化释放底层硬件的全部算力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









