

Python列表与NumPy数组选型及性能优化指南

聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
数据结构选型目标与核心差异
在Python编程实践中,选择合适的容器直接决定代码的执行效率与内存占用。内置List作为动态异构图结构,适合通用数据聚合与频繁增删;而基于C实现的array模块或NumPy数组则采用连续内存分配,专为大规模同质数值计算设计。掌握两者的底层机制是进行数据结构选型的前提。
| 特性维度 | 内置列表(List) | 标准库数组(array)/NumPy |
|---|---|---|
| 数据类型 | 任意Python对象(支持异构) | 单一底层类型(严格同构) |
| 内存分布 | 指针数组存储,额外开销较大 | 连续内存块,紧凑存储 |
| 访问速度 | 较慢(需动态类型检查) | 极快(C语言级向量化的SIMD加速) |
| 典型场景 | 日常业务逻辑、配置文件、API响应 | 科学计算、信号处理、机器学习数据预处理 |
基础构建与向量化操作配置
第1步:初始化异构数据容器(列表适用场景)
目的:利用动态扩容特性快速聚合多类型数据。
操作与参数:直接使用方括号或list()构造函数。列表内部按约1.125倍阈值触发内存重组,首次插入少量元素时不会立即引发昂贵拷贝。
my_list = [42, "Python", 3.14, True]
my_list.append([1, 2, 3]) # 支持嵌套复杂结构
第2步:构建同构数值存储(array模块与NumPy)
目的:锁定数据类型以消除运行时类型检查开销。
入口与动作:引入对应模块后指定typecode创建实例。array模块适用于轻量级场景,NumPy则作为行业标准处理多维矩阵。
import array
int_array = array.array('i', [1, 2, 3, 4, 5]) # 'i'表示有符号整型
常用类型码对照:
| 类型码 | C语言对应 | Python映射 | 单字节占用 |
|---|---|---|---|
| 'b' | signed char | int | 1 |
| 'i' | signed int | int | 2/4 |
| 'f' | float | float | 4 |
| 'd' | double | float | 8 |
第3步:执行向量化运算与性能验证
目的:通过批量指令替代逐元素循环,验证计算加速效果。
操作步骤:使用NumPy生成测试数据集,对比列表推导式、array遍历与NumPy原生算子的耗时差异。向量化操作利用底层C循环与CPU缓存局部性,通常可比传统方案提升数十倍。
import timeit
import array
import numpy as np

# 初始化百万级测试集
data_size = 1_000_000
list_data = [float(i) for i in range(data_size)]
np_data = np.array(list_data)

# 执行平方运算计时
def op_list(): return [x**2 for x in list_data]
def op_numpy(): return np_data ** 2

print("列表耗时:", round(timeit.timeit(op_list, number=10), 2), "秒")
print("NumPy耗时:", round(timeit.timeit(op_numpy, number=10), 4), "秒")
高级调优策略与内存管理
第4步:实施混合架构与视图切片
目的:兼顾业务灵活性与时序数值计算需求。
关键参数:axis指定聚合维度,dtype强制降低精度节省空间。NumPy默认采用“视图(View)”而非深拷贝,修改切片会直接影响原数组。
# 提取元数据中的纯数值列转为同构数组
readings = np.array([item["values"] for item in raw_records], dtype=np.float32)
mean_vals = readings.mean(axis=1)
决策辅助参考:
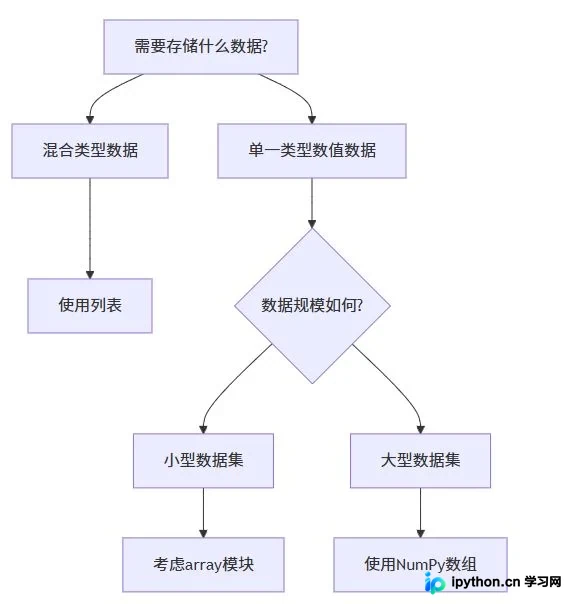
第5步:超大规模数据处理优化
目的:突破物理内存限制,启用磁盘交换与多线程调度。
操作方法:使用np.memmap建立文件映射,仅按需加载切片至RAM。配合multiprocessing.Pool实现进程级数据分片并行求和,避免GIL锁导致的线程阻塞。
完成判断与常见问题排查
选型成功的标志为:内存峰值下降≥30%且核心计算耗时缩短至原有水平1/10以内。排查常见异常需注意以下关键点:
- TypeError: unsupported operand type(s):混入非数字对象导致NumPy广播失败。解决:使用
pd.to_numeric(errors='coerce')清洗或严格过滤类型。 - SettingWithCopyWarning:误对临时切片赋值。解决:显式调用
.copy()获取独立副本,或使用loc/iloc索引器。 - 内存溢出(OOM):未释放中间变量。解决:及时调用
del arr并触发GC,或改用inplace=True覆盖旧缓冲区。
总结
Python的List与数组/NumPy分别对应“开发敏捷性”与“运行极致性”。原型验证期推荐使用列表快速迭代接口;进入生产环境后,针对万级以上同构数据务必迁移至强类型容器。合理利用视图机制、精准控制dtype以及结合多进程池调度,可彻底释放硬件算力。以上就是Python列表与NumPy数组选型及性能优化的详细内容,更多关于Python数据结构实践的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









