

Python 性能优化实战:从算法实现到内存布局的深度解析

本文深入探讨 Python 性能优化的多种技术路径,涵盖 Cython、IPython.parallel、numexpr、multiprocessing、Numba 及 NumbaPro 等工具的应用场景。通过对比列表推导、迭代器、eval、生成器及 map 函数的执行效率,并结合 NumPy 数组的 C 与 Fortran 内存布局测试,揭示不同实现方式在时间与空间复杂度上的显著差异,为开发者提供具体的性能调优参考。
提升程序运行效率通常可采取以下策略:
1、Cython:用于将 Python 与 C 语言代码合并,并通过静态编译生成通用二进制文件。
2、IPython.parallel:支持在本地环境或集群节点上并行执行代码任务。
3、numexpr:专注于加速数值表达式的计算过程。
4、multiprocessing:Python 标准库内置的多进程并行处理模块。
5、Numba:用于在 CPU 上对 Python 代码进行动态即时编译。
6、NumbaPro:针对多核 CPU 和 GPU 架构,提供动态编译 Python 代码的能力。
为了验证相同算法在不同实现方式下的性能差异,我们首先定义一个用于性能测试的辅助函数。
def perf_comp_data(func_list, data_list, rep=3, number=1):
  '''Function to compare the performance of different functions.
  Parameters
  func_list : list
  list with function names as strings

  data_list : list
  list with data set names as strings

  rep : int
  number of repetitions of the whole comparison
  number : int
  number ofexecutions for every function
  '''
  from timeit import repeat
  res_list = {}
  for name in enumerate(func_list):
    stmt = name[1] + '(' + data_list[name[0]] + ')'
    setup = "from __main__ import " + name[1] + ','+ data_list[name[0]]
    results = repeat(stmt=stmt, setup=setup, repeat=rep, number=number)
    res_list[name[1]] = sum(results) / rep
  res_sort = sorted(res_list.items(), key = lambda item : item[1])
  for item in res_sort:
    rel = item[1] / res_sort[0][1]
    print ('function: ' + item[0] + ', av. time sec: %9.5f,  ' % item[1] + 'relative: %6.1f' % rel)
接下来定义需要执行的基准算法函数。
from math import *
def f(x):
  return abs(cos(x)) ** 0.5 + sin(2 + 3 * x)
该算法对应的数学表达式如下。
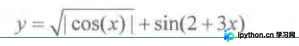
生成用于测试的数据集。
i=500000
a_py = range(i)
第一种实现 f1 方式是在内部循环中调用 f 函数,并将每次计算结果追加到列表中,具体实现如下。
def f1(a):
  res = []
  for x in a:
    res.append(f(x))
  return res
当然,实现此类方案的方法不止一种,可以使用迭代器或 eval 函数。此外,我还加入了使用生成器和 map 方法的测试,发现结果存在明显差距,其科学性尚待进一步探讨:
迭代器实现方式。
def f2(a):
  return [f(x) for x in a]
eval 实现方式。
def f3(a):
  ex = 'abs(cos(x)) **0.5+ sin(2 + 3 * x)'
  return [eval(ex) for x in a]
生成器实现方式。
def f7(a):
  return (f(x) for x in a)
map 实现方式。
def f8(a):
  return map(f, a)
接下来展示使用 NumPy 的 ndarray 结构进行的几种实现方式。
import numpy as np
a_np = np.arange(i)

def f4(a):
  return (np.abs(np.cos(a)) ** 0.5 + np.sin(2 + 3 * a))

import numexpr as ne

def f5(a):
  ex = 'abs(cos(a)) ** 0.5 + sin( 2 + 3 * a)'
  ne.set_num_threads(1)
  return ne.evaluate(ex)

def f6(a):
  ex = 'abs(cos(a)) ** 0.5 + sin(2 + 3 * a)'
  ne.set_num_threads(2)
  return ne.evaluate(ex)
上述 f5 和 f6 的区别仅在于使用的处理器线程数量不同,用户可根据自身 CPU 的核心数进行调整,但并非线程数越多性能越好。
随后进行实际的性能测试。
func_list = ['f1', 'f2', 'f3', 'f4', 'f5', 'f6', 'f7', 'f8']
data_list = ['a_py', 'a_py', 'a_py', 'a_np', 'a_np', 'a_np', 'a_py', 'a_py']
perf_comp_data(func_list, data_list)
测试输出结果如下。
function: f8, av. time sec:  0.00000,  relative:  1.0
function: f7, av. time sec:  0.00001,  relative:  1.7
function: f6, av. time sec:  0.03787,  relative: 11982.7
function: f5, av. time sec:  0.05838,  relative: 18472.4
function: f4, av. time sec:  0.09711,  relative: 30726.8
function: f2, av. time sec:  0.82343,  relative: 260537.0
function: f1, av. time sec:  0.92557,  relative: 292855.2
function: f3, av. time sec: 32.80889,  relative: 10380938.6
结果显示 f8 的执行时间最短,为了进一步确认,我们提高时间精度重新测试一次。
function: f8, av. time sec: 0.000002483,  relative:  1.0
function: f7, av. time sec: 0.000004741,  relative:  1.9
function: f5, av. time sec: 0.028068110,  relative: 11303.0
function: f6, av. time sec: 0.031389788,  relative: 12640.6
function: f4, av. time sec: 0.053619114,  relative: 21592.4
function: f1, av. time sec: 0.852619225,  relative: 343348.7
function: f2, av. time sec: 1.009691877,  relative: 406601.7
function: f3, av. time sec: 26.035869787,  relative: 10484613.6
再次测试发现,使用 map 的性能最高,生成器次之,其他方法的性能则相差较大。值得注意的是,使用 ndarray 数据的运算结果处于同一数量级,而使用 Python 原生 list 的数据则处于另一个数量级。生成器的原理在于它并不生成完整的列表,而是在内部维护一个 next 函数,通过一边循环迭代一边生成下一个元素的方式实现。因此,它既不需要在执行时遍历整个循环,也不需要分配完整的内存空间,其花费的时间和空间与列表的大小无关。map 函数的行为与之类似,而其他实现方式的性能则与列表大小直接相关。
关于内存布局的讨论。
NumPy 的 ndarray 构造函数形式为。
np.zeros(shape, dtype=float, order='C')
np.array(object, dtype=None, copy=True, order=None, subok=False, ndmin=0)
shape 参数或 object 参数定义了数组的大小,或者引用了另一个现有的数组。
dtype 参数用于定义元素的数据类型,可以是 int8、int32、float8、float64 等。
order 参数定义了元素在内存中的存储顺序,'C' 表示行优先(C-style),'F' 表示列优先(Fortran-style)。
下面来比较一下在数组规模较大时,不同内存布局带来的性能差异,首先构造基于 C 和基于 F 的相同数组,代码如下:
x = np.random.standard_normal(( 3, 1500000))
c = np.array(x, order='C')
f = np.array(x, order='F')
随后进行性能测试。
%timeit c.sum(axis=0)
%timeit c.std(axis=0)
%timeit f.sum(axis=0)
%timeit f.std(axis=0)
%timeit c.sum(axis=1)
%timeit c.std(axis=1)
%timeit f.sum(axis=1)
%timeit f.std(axis=1)
输出结果如下。
loops, best of 3: 12.1 ms per loop
loops, best of 3: 83.3 ms per loop
loops, best of 3: 70.2 ms per loop
loop, best of 3: 235 ms per loop
loops, best of 3: 7.11 ms per loop
loops, best of 3: 37.2 ms per loop
loops, best of 3: 54.7 ms per loop
loops, best of 3: 193 ms per loop
由此可见,C 风格的内存布局在性能上优于 F 风格。
关于并行计算的讨论。
未完待续……
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









