

Python字符串常用方法:split、join、replace与strip实战教程
深入解析Python字符串最高频使用的四个基础方法:split、join、replace与strip。包含核心语法、底层机制、高频避坑与完整的日志清洗实战案例。
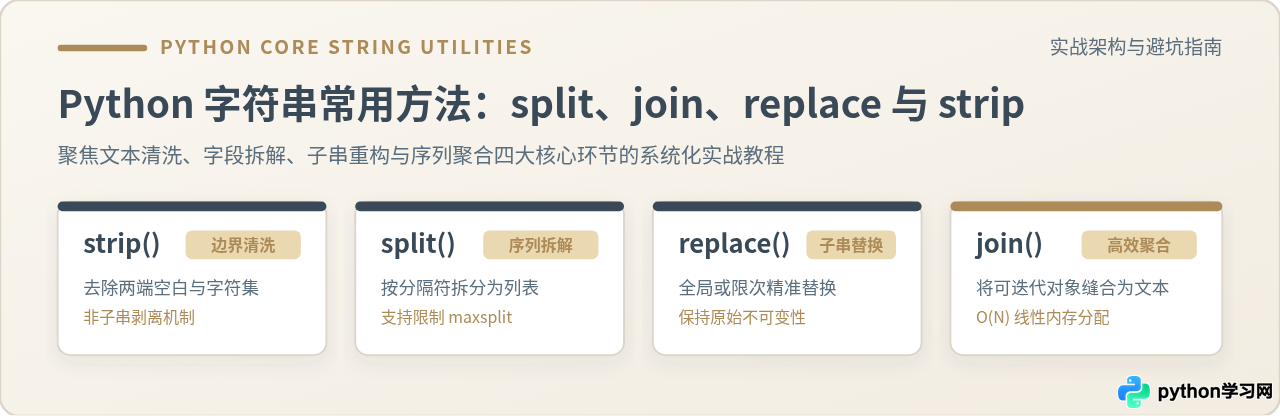
strip()、split()、replace() 和 join() 是使用频率最高且配合最为紧密的四个核心字符串方法。掌握它们的最佳路径不是孤立记忆语法,而是理解它们各自解决的具体问题阶段:strip() 负责边界降噪,split() 负责解构字段,replace() 负责模式置换,而 join() 负责聚合重构。本文将从具体机制、参数陷阱到完整清洗流水线展开全面剖析。
一、strip():首尾边界字符的精确剥离
从文件、控制台输入或网络接口获取的原始文本,末尾通常伴随多余的换行符(如
、
)以及首尾无关空格。strip() 的核心职责就是清除字符串两端的不必要内容,同时保持中间正文不受破坏。
1. 默认行为:移除两端空白符
当不向 strip() 传递任何参数时,它会自动移除首尾的所有空白字符,包括普通空格、制表符 和换行符
。
# 示例 1:默认清除首尾空白符与换行
raw_input = "  	 用户编号: A-8921
  "
cleaned = raw_input.strip()

print(f"原始长度: {len(raw_input)}, 清洗后: '{cleaned}', 长度: {len(cleaned)}")
# [示例输出] 原始长度: 22, 清洗后: '用户编号: A-8921', 长度: 15
除了双向清理的 strip(),Python 还提供了仅剥离左侧的 lstrip() 和仅剥离右侧的 rstrip()。在逐行读取日志文件时,推荐使用 line.rstrip('
'),这样可以安全消除行尾换行符,而保留行首有语义价值的缩进空格。
2. 传参剥离机制与高频误区
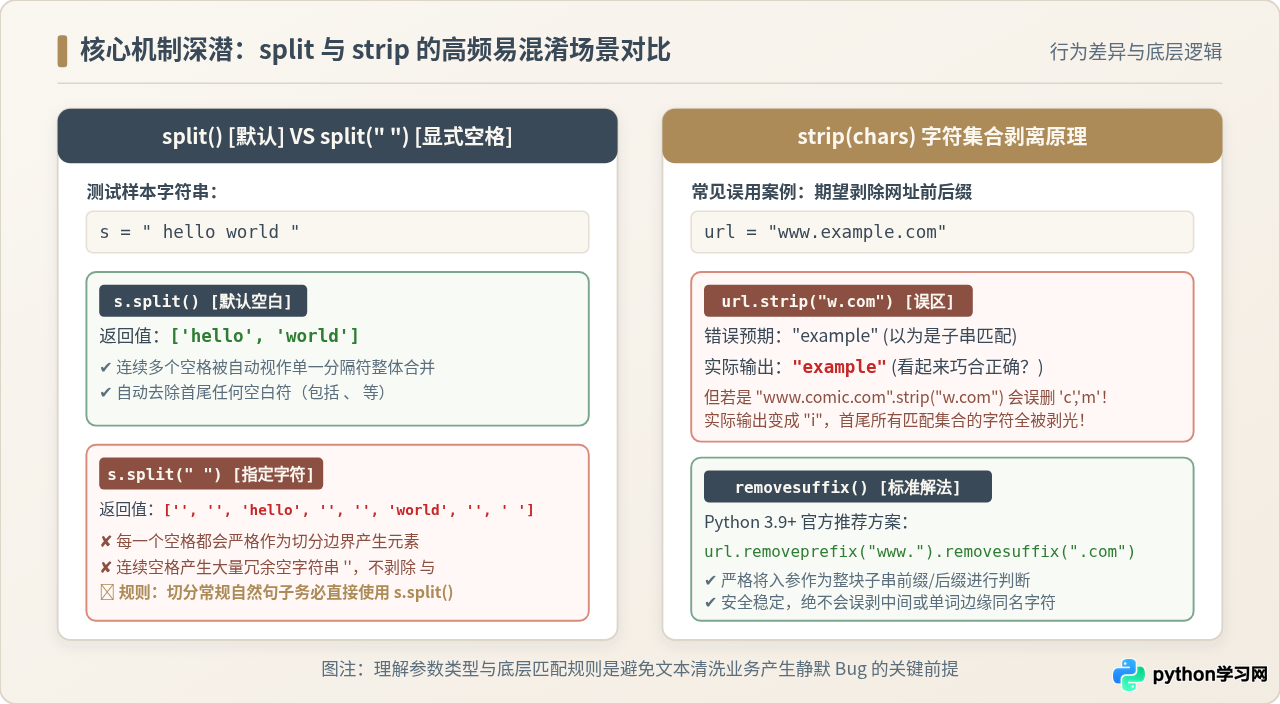
strip(chars) 允许传入一个自定义参数。初学者最容易产生的认知误区,是误以为传入的参数是一个“整体子串”或“前后缀单词”。事实上,参数 chars 被 Python 视为一个字符集合(Character Set)。方法会检查字符串两端每一个字符是否落在该集合内,一旦命中就将其移除,直到遇到第一个不在集合内的字符为止。
假设我们希望去除网址前缀 www. 和后缀 .com:
url = "www.comic.com"
bad_clean = url.strip("w.com")
print(bad_clean)
# [示例输出] 'i'
在上面的例子中,原意是剥离 "w.com",但因为 'c'、'o'、'm' 全都在集合中,中间单词 comic 前后的 c 和 m 同样被直接切除,最终只剩下了 'i'。
如果业务目标是精确裁剪特定的子串前缀或后缀,在 Python 3.9 及更高版本中,应优先使用语义严谨的 removeprefix() 和 removesuffix():
# 推荐方案:Python 3.9+ 严谨前缀/后缀移除
domain = "www.comic.com"
safe_domain = domain.removeprefix("www.").removesuffix(".com")
print(safe_domain)
# [示例输出] 'comic'
二、split():按分隔规则拆解文本序列
split() 方法用于将单行字符串打散为元素列表(list[str])。它支持两个参数:sep(分隔符)和 maxsplit(最大拆分次数)。理解 sep 的默认传参机制是写出健壮代码的关键。
1. 默认 split() 与显式 split(" ") 的本质差异
许多初学者认为 s.split() 和 s.split(" ") 是等价的,这在处理真实格式混乱的文本时会导致严重 Bug:
s.split()或s.split(None):采用空白字符算法。它将连续的多个空格、制表符、换行符整体视为单一分隔符,并自动忽略字符串首尾的空白,不会返回空字符串元素。s.split(" "):采用精准字符切分。它严格把每一个单独的空格作为边界。如果存在两个连续空格,它们之间就会生成一个空字符串"";如果首尾有空格,也会在列表首尾产生""。
raw_text = "  Python   Data   Pipeline
"

# 方式 A:默认切分(合并连续空白并忽略边缘空白)
list_a = raw_text.split()
print(f"默认 split: {list_a}")
# [示例输出] 默认 split: ['Python', 'Data', 'Pipeline']

# 方式 B:显式指定单空格切分
list_b = raw_text.split(" ")
print(f"显式 split: {list_b}")
# [示例输出] 显式 split: ['', '', 'Python', '', '', 'Data', '', '', 'Pipeline', '', '
']
2. maxsplit 参数控制拆分深度
在解析带有特定键值结构或固定前缀的数据时,若后续内容本身包含分隔符,盲目全局拆分会破坏数据结构。此时可以通过设置 maxsplit 限制拆分次数:
# 场景:解析结构形如 "时间|日志等级|异常详情信息: 包含|符号"
log_entry = "2026-11-01 09:30:00|ERROR|Database connection lost | host: 10.0.0.1 | port: 5432"

# 仅拆分前 2 次,提取时间、级别,保留剩余完整信息
parts = log_entry.split("|", maxsplit=2)
timestamp = parts[0]
level = parts[1]
detail = parts[2]

print(f"时间: {timestamp}, 等级: {level}")
print(f"详情(保留内部竖线): {detail}")
# [示例输出] 时间: 2026-11-01 09:30:00, 等级: ERROR
# [示例输出] 详情(保留内部竖线): Database connection lost | host: 10.0.0.1 | port: 5432
三、replace():子串匹配与不可变重构
replace(old, new[, count]) 用于将字符串中的指定旧子串替换为新子串。理解 replace() 需要掌握 Python 字符串对象的底层不可变特性(Immutability)。
1. 字符串不可变性与变量重新赋值
在 Python 中,字符串是不可变类型(Immutable)。调用 s.replace(...) 绝对不会原地修改原字符串,而是根据规则在内存中开辟全新空间生成一个全新的字符串对象并返回。初学者经常编写 s.replace("a", "b") 却发现原字符串毫无变化,原因就在于没有将返回值重新赋给变量。
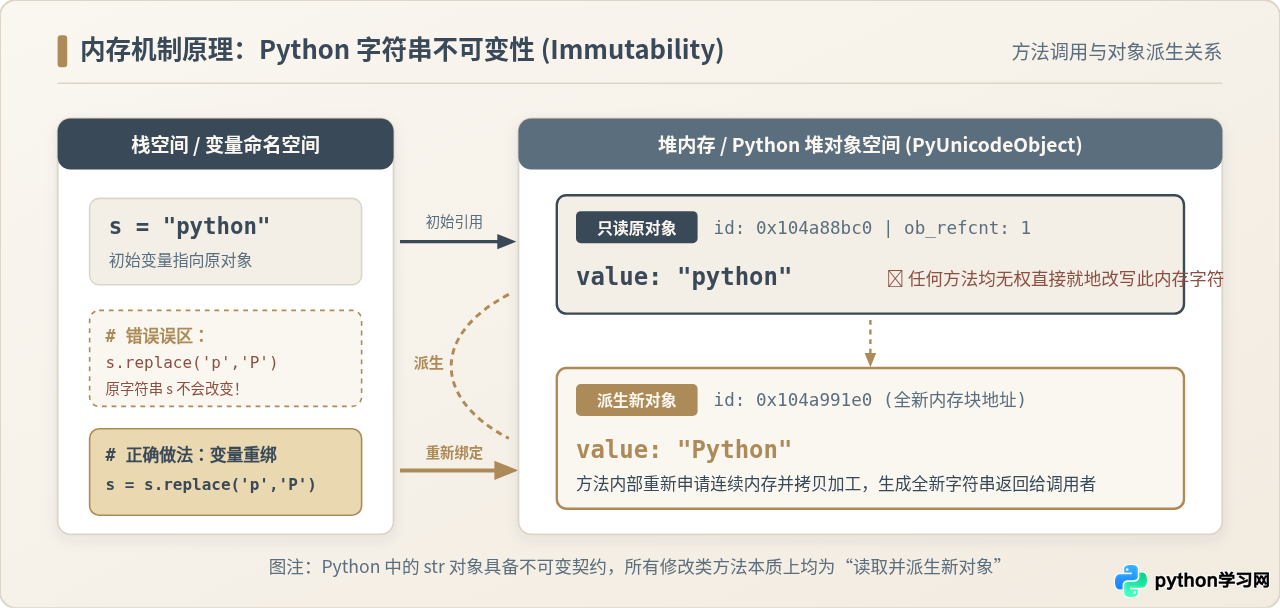
s = "v1.0.0-beta"

# 错误做法:未接收返回值,原字符串维持不变
s.replace("beta", "release")
print(f"原字符串保持原样: {s}") # 输出仍是 v1.0.0-beta

# 正确做法:变量重新指向新派生对象
s = s.replace("beta", "release")
print(f"重绑后生效: {s}") # 输出 v1.0.0-release
2. 限制替换次数:count 参数实战
当只需要替换首个或前 N 个匹配项时,应当显式指定 count。例如在替换路径前缀或仅更新第一处占位标记时:
template = "用户 {name} 成功登入系统。通知抄送:{name}"
# 仅替换第 1 个占位符为实际用户名
result = template.replace("{name}", "张工程师", 1)
print(result)
# [示例输出] 用户 张工程师 成功登入系统。通知抄送:{name}
四、join():高效缝合序列为标准文本
与 split() 将字符串分解为列表相反,join() 负责将序列(列表、元组、生成器)缝合为一个完整字符串。其调用形式为 separator.join(iterable)。
1. 为什么设计为 separator.join(iterable)?
初学者常常困惑为什么不是 list.join(separator)。Python 核心设计团队将 join 挂载在 str 对象上的主要原因是:被连接的数据源可以是任意可迭代对象(如 list、tuple、set 或生成器表达式)。如果挂在 list 上,其他容器就无法共享相同逻辑;而连接动作本身完全由“分隔符”的字符格式主导。
2. 类型约束与推导式转换
join() 要求传入的可迭代对象中每一个元素都必须是字符串类型。若列表中含有数字(int / float)或 None,会直接抛出 TypeError。
user_ids = [101, 102, 108, 115]

# 错误用法:直接传入整型列表会引发 TypeError: sequence item 0: expected str instance, int found
# sql_in = ",".join(user_ids)

# 标准解法:使用生成器推导式统一转换为 str
sql_in = ", ".join(str(uid) for uid in user_ids)
query = f"SELECT * FROM users WHERE id IN ({sql_in});"
print(query)
# [示例输出] SELECT * FROM users WHERE id IN (101, 102, 108, 115);在循环中使用 s += token 拼接 N 个子串时,由于字符串不可变,每一次 + 操作都会在内存中重新分配缓冲区并把旧内容全部拷贝一次,导致整体耗时呈二次方增长($O(N^2)$)。而 separator.join(iterable) 能够预先精确计算所有元素与分隔符所需的总内存字节数,仅进行一次单次内存申请与线性填充($O(N)$),在数据量达到数万级时性能差距可达百倍以上。
五、综合实战:脏日志数据清洗流水线
在真实的工程实践中,单独调用某一个方法往往难以解决问题。最典型的做法是将 strip()、split()、replace() 和 join() 串联为紧凑的数据清洗管线。下面以解析并规范化服务器脏日志行为例说明具体落地步骤。
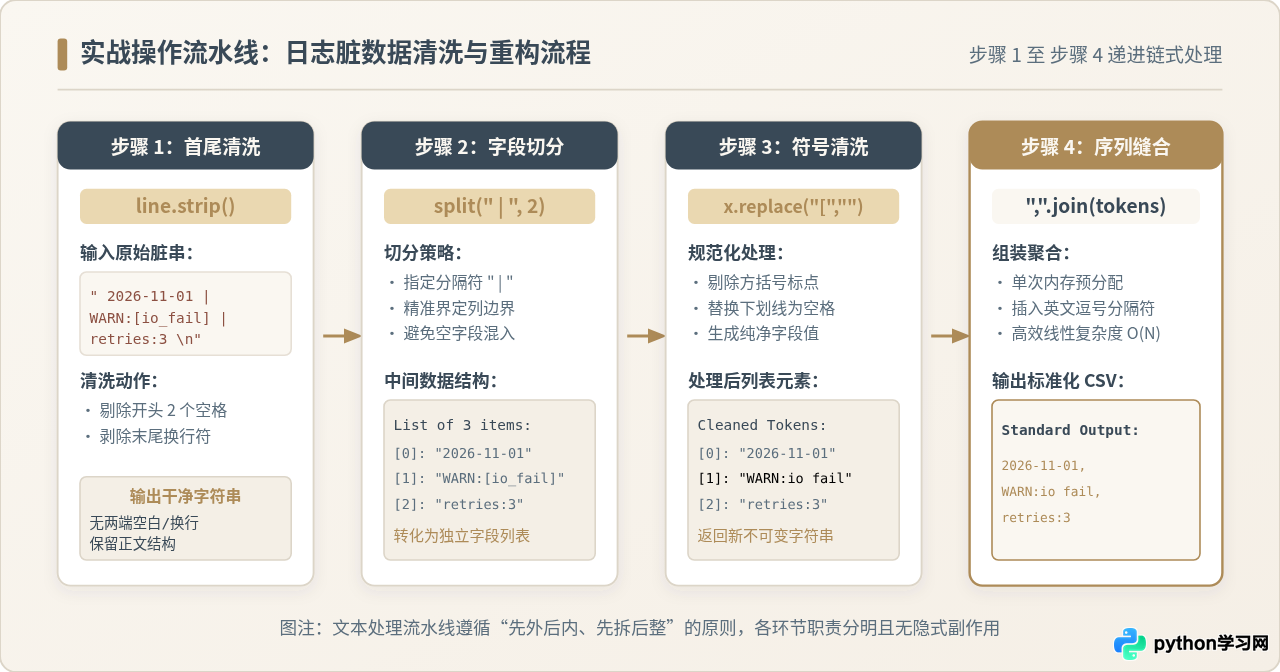
业务目标:输入是一段格式不齐、包含多余换行、特殊脏符号的日志文本,需要提取各列字段,去除冗余标点,最终输出为标准 CSV 格式:
def clean_log_record(raw_line: str) -> str:
    # 步骤 1:使用 strip 清除行首行尾空白符与换行符
    trimmed = raw_line.strip()
    if not trimmed:
        return ""

    # 步骤 2:使用 split 按字段边界切分,限制最大字段数
    columns = trimmed.split(" | ")

    # 步骤 3:使用 replace 清洗各字段中的脏格式(如方括号、非法标点)
    cleaned_fields = []
    for col in columns:
        val = col.replace("[", "").replace("]", "")  # 清除标签包裹符
        val = val.replace("_", " ")                 # 将下划线规范为空格
        cleaned_fields.append(val.strip())

    # 步骤 4:使用 join 将清洗后的字段重构成标准 CSV 行格式
    csv_row = ",".join(cleaned_fields)
    return csv_row

# 测试输入:包含前后空格、换行、下划线与多余方括号
raw_log = "   2026-11-01 10:15:32 | [AUTH_FAILURE] | user: [alex_smith] | attempts: 4
"
output_csv = clean_log_record(raw_log)

print(f"输入原数据: {repr(raw_log)}")
print(f"清洗输出行: {output_csv}")
# [示例输出] 输入原数据: '   2026-11-01 10:15:32 | [AUTH_FAILURE] | user: [alex_smith] | attempts: 4   \n'
# [示例输出] 清洗输出行: 2026-11-01 10:15:32,AUTH FAILURE,user: alex smith,attempts: 4
六、方法对比速查与选用决策指南
为了在实际开发中快速选用最合适的方法并避开常见陷阱,以下汇总了四个方法的关键技术属性与决策路径:
| 方法名称 | 典型调用形式 | 返回值类型 | 核心应用场景 | 关键避坑注意点 |
|---|---|---|---|---|
| strip() | s.strip([chars]) |
str |
去除文件换行、清理用户输入两端空白 | chars 是字符集合而非子串;需删前缀请用 removeprefix |
| split() | s.split(sep, maxsplit) |
list[str] |
按分隔符解析字段、拆分语句为单词 | sep=None 合并空白;sep=" " 会产生连续空字符串 |
| replace() | s.replace(old, new, n) |
str |
子串替换、纠正格式、剔除特定符号 | 字符串不可变,必须接收返回值重新赋值(s = s.replace) |
| join() | sep.join(iterable) |
str |
拼接 SQL IN 参数、拼合 CSV、序列转文本 | 元素必须均为 str;性能大幅优于循环中的 + 累加 |
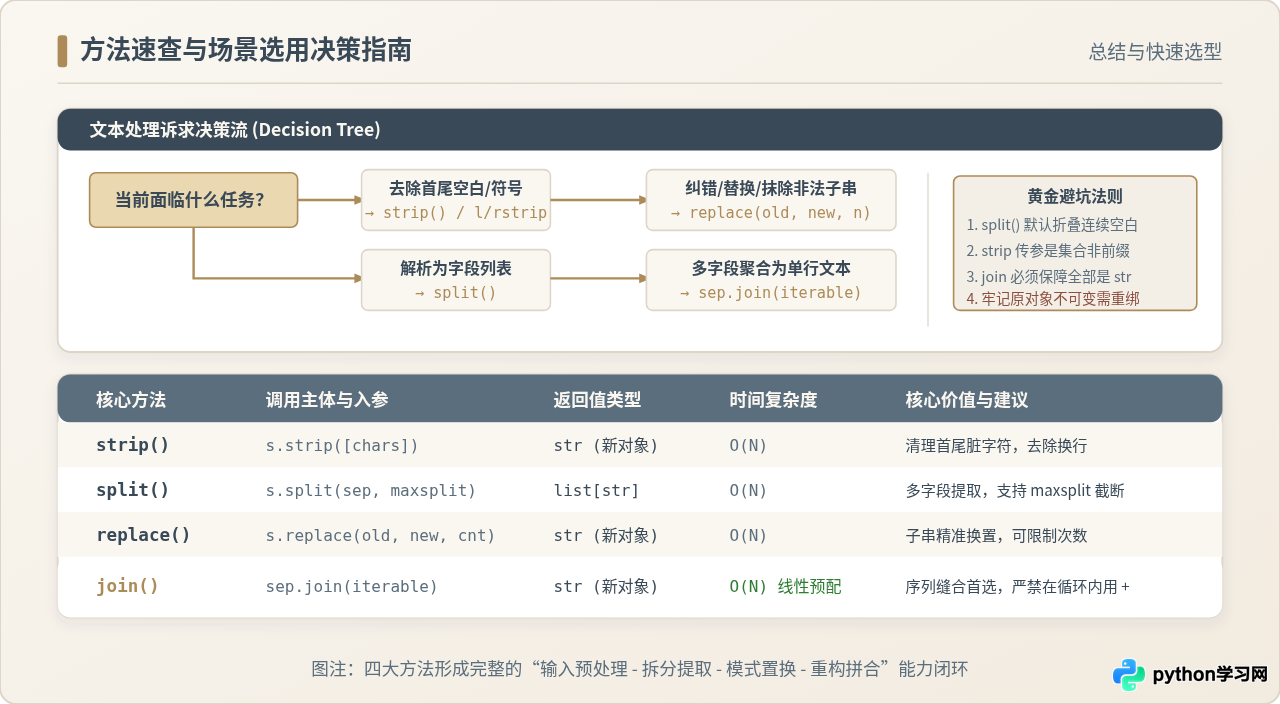
七、总结
在 Python 中编写高效、简洁的文本清洗代码,核心在于建立流水线思维:
- 先剥离外壳:通过
strip()或rstrip(' ')去除不可见的外部换行与边界噪音; - 再解构骨架:使用
split()或split(sep, maxsplit)将非结构化文本展开为有序列结构; - 后净化细节:针对提取出的单个字段,调用
replace()精准替换或清除无效字符; - 最终高效重组:利用
separator.join()线性性能预分配机制,将清洗结果组装为最终格式。
牢记这四种方法在参数规则、字符集匹配以及对象不可变性方面的底层机制,即可在面对各种复杂的自然语言与日志数据处理任务时游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









