

易语言高效读取TXT字典进行批量账号验证的方法
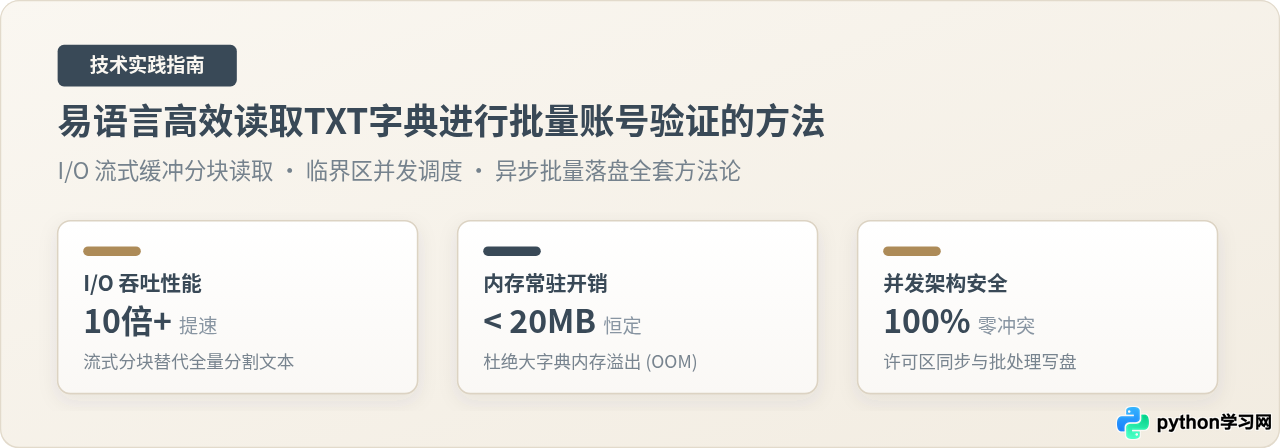
深入解析易语言在大数据量场景下高效读取TXT字典并进行批量账号验证的工程级实现方案。涵盖I/O分块流式读取、内存防暴涨机制、许可区多线程安全分发调度及异步结果批量落盘。
一、传统读取模式的性能瓶颈与崩溃成因
初学者在编写易语言账号验证工具时,普遍采用如下两行典型代码:
全部文本 = 到文本 (读入文件 (字典路径))
行数组 = 分割文本 (全部文本, #换行符)
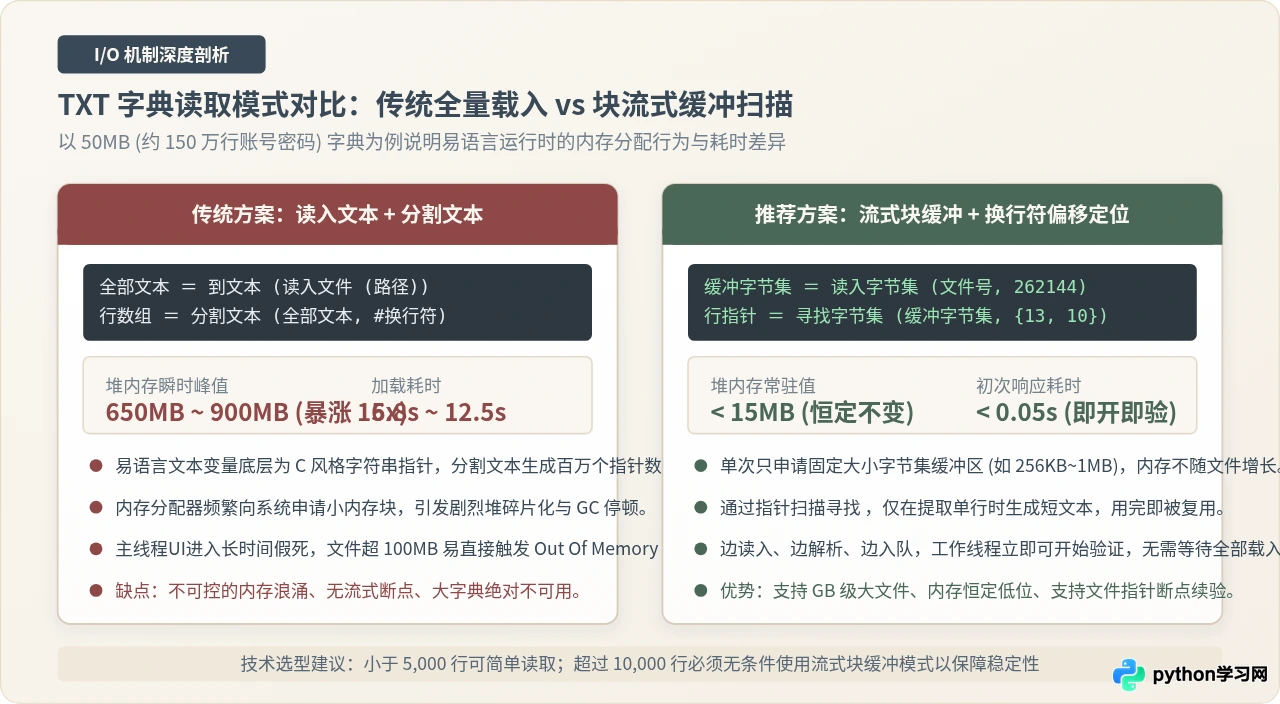
当字典文件小于 1MB(几千行)时,这段代码执行迅速,不易暴露问题。但一旦字典文件达到数十兆字节(包含数十万至数百万行账号密码),这种写法会引发三个致命的底层运行时危机:
-
内存乘数级放大与内存溢出(OOM):易语言的文本变量在底层对应以空字符结尾的 C 字符串指针。执行
分割文本时,运行时必须在堆内存中为每一个子行单独申请内存块,并构建庞大的指针索引数组。一份 50MB 的纯文本字典,经过分割后往往需要瞬间占用 650MB 至 900MB 以上的内存空间。易语言作为 32 位程序,寻址空间理论上限仅为 2GB(实际用户态可用空间通常不足 1.6GB),极易触发内存申请失败而直接崩溃。 - 内存管理器高频申请引发垃圾回收假死:短时间内申请数十万个小尺寸内存块,会导致堆空间产生严重碎片化。易语言内存管理器在频繁分配与释放小内存时会占用大量 CPU 周期,造成程序主界面出现数秒至数十秒的无响应状态。
- 完全丧失流式处理与断点恢复能力:该模式必须在“全部文本载入并切分完毕”后才能开始第一条账号的验证工作。如果用户中途强制关闭程序,已经消耗的 I/O 和内存时间完全浪费,无法做到“边读、边验、边存”。
二、基于流式块缓冲的高效字典读取实现
高效读取的核心原则是“流式分块载入与指针偏移扫描”:绝不一次性将整个文件转化为文本字符串,而是每次从磁盘读取一块固定尺寸的二进制字节集(如 256KB),在字节集层面上通过扫描换行符字节(回车符 13 与换行符 10)定位每一行的起始与终结位置,逐行或小批量提取。
1. 跨块截断处理逻辑
使用固定大小块读取文件时,块的末尾极大概率会切断某一行(即前半行在当前块,后半行在下一个块)。正确的做法是在读取下一块前,将当前块末尾未闭合的残余字节(从最后一个换行符之后到块末尾的字节)保留并拼接至下一个读取周期的头部。
2. 易语言核心读取代码段
以下是采用标准易语言支持库编写的高性能文件分块读取与行提取函数:
.参数 文件路径, 文本型
.局部变量 文件号, 整数型
.局部变量 缓冲区, 字节集
.局部变量 残余数据, 字节集
.局部变量 块大小, 整数型
.局部变量 换行位置, 整数型
.局部变量 当前行文本, 文本型
块大小 = 262144 ' 256 KB 黄金平衡尺寸
文件号 = 打开文件 (文件路径, #读入, #无限制)
.如果真 (文件号 = 0)
返回 (假)
.如果真结束
.判断循环首 (是否在文件尾 (文件号) = 假)
缓冲区 = 残余数据 + 读入字节集 (文件号, 块大小)
残余数据 = { }
' 循环寻找该块内的每一个回车换行符
.判断循环首 (真)
换行位置 = 寻找字节集 (缓冲区, { 13, 10 }, 1)
.如果真 (换行位置 = -1)
' 未找到完整换行,说明剩余部分跨块,保留至下周期
残余数据 = 缓冲区
跳出循环 ()
.如果真结束
' 提取当前行并转为文本
当前行文本 = 到文本 (取字节集中间 (缓冲区, 1, 换行位置 - 1))
缓冲区 = 取字节集中间 (缓冲区, 换行位置 + 2, 取字节集长度 (缓冲区) - 换行位置 - 1)
' 安全投递到多线程任务队列
安全投递任务 (当前行文本)
.判断循环尾 ()
.判断循环尾 ()
' 处理文件末尾最后一行无换行符的边界数据
.如果真 (取字节集长度 (残余数据) > 0)
安全投递任务 (到文本 (残余数据))
.如果真结束
关闭文件 (文件号)
返回 (真)
实测表明,块大小设置过小(如 4KB)会产生过多系统调用(Syscall),降低磁盘吞吐;设置过大(如 32MB)则会削弱“即开即验”的低延迟优势。256KB 至 1MB 是兼顾内存控制、CPU 缓存友好度与磁盘预读效率的最佳区间。
三、多线程安全并发:许可区与任务队列调度
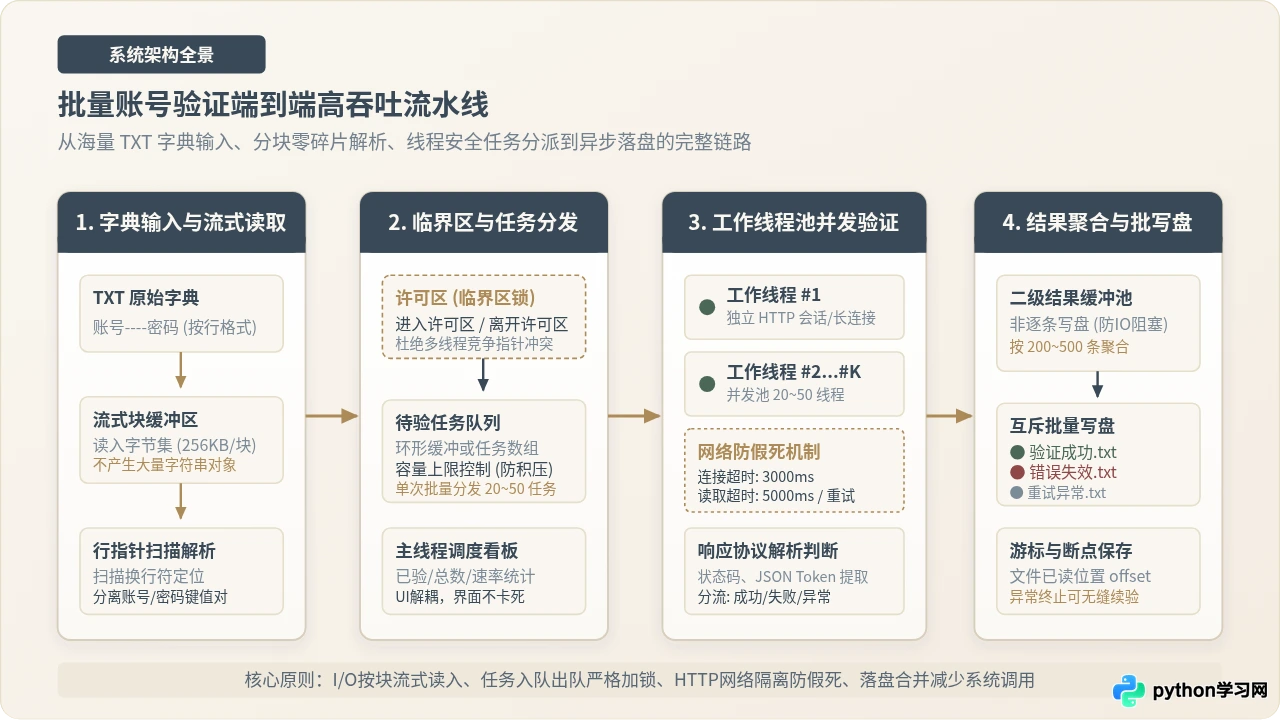
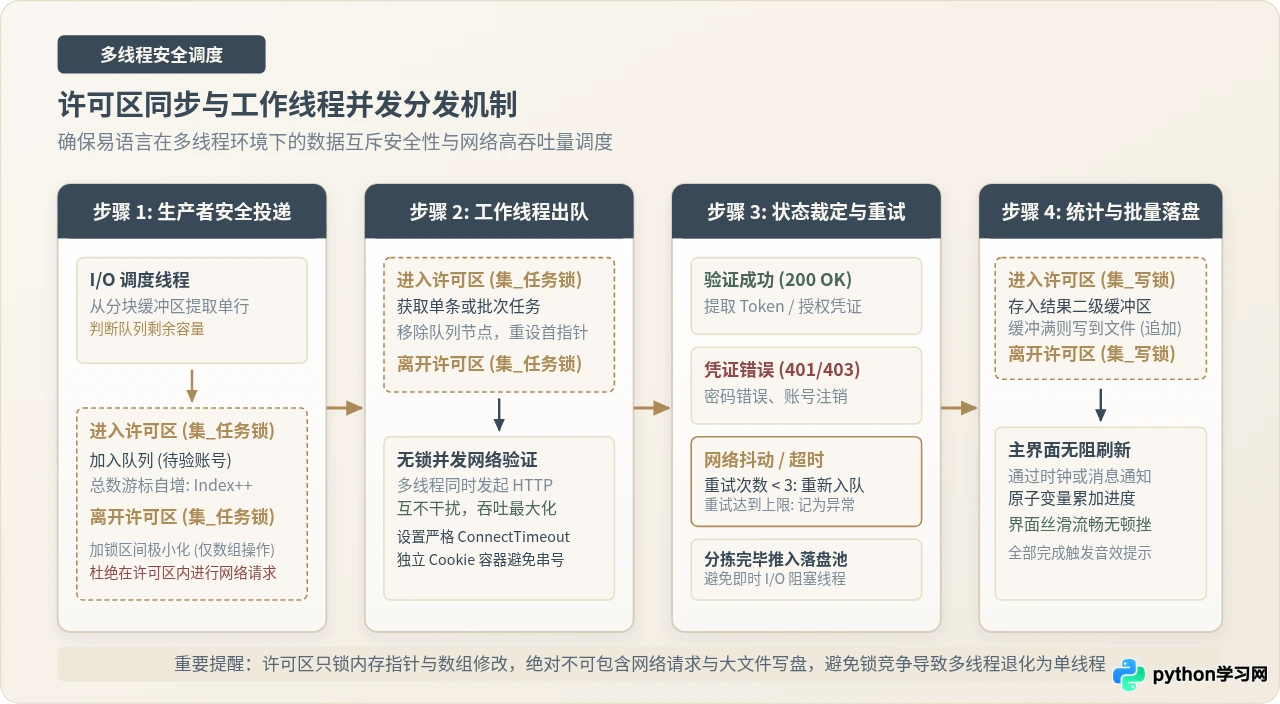
在易语言中,如果不使用同步机制,多个线程同时读写同一个数组或文本变量会导致内存指针越界访问(0xC0000005 访问违例),这是易语言多线程软件莫名闪退的最主要根源。
1. 临界区(许可区)的正确使用法则
易语言内置的 进入许可区 与 离开许可区 本质上是封装了 Windows API 的临界区对象(CRITICAL_SECTION)。使用许可区必须遵守一条铁律:只锁内存指针操作,绝不锁网络 I/O 和磁盘写盘。
.参数 输出账号, 文本型, 参考
.局部变量 队列长度, 整数型
进入许可区 (集_任务锁) ' 立即加锁保护数组
队列长度 = 取数组成员数 (集_待验队列)
.如果 (队列长度 > 0)
输出账号 = 集_待验队列 [1]
删除成员 (集_待验队列, 1, 1) ' 弹出队首任务
离开许可区 (集_任务锁) ' 立即解锁!离开保护区
返回 (真)
.否则
离开许可区 (集_任务锁) ' 无任务也要确保解锁
返回 (假)
.如果结束
如果将网络请求代码(如 网页_访问S)包裹在 进入许可区 和 离开许可区 之间,那么无论创建多少个线程,所有线程都必须排队等待当前网络请求返回,导致多线程退化为单线程执行,甚至因为单次网络超时而令全盘线程陷入瘫痪。
四、网络验证防假死控制与异常重试机制
工作线程在取出账号密码后,将独立发起 HTTP/HTTPS 请求。批量验证时,网络环境复杂多变,必须对以下三项关键属性进行严格控制:
1. 严格控制连接与读取超时
默认的系统网络超时通常高达 30 秒至 60 秒。在批量验证场景中,若遇到服务器丢包,工作线程会长时间挂起。建议显式设置:
- 连接超时(ConnectTimeout):建议设置为 2,500ms ~ 3,000ms;
- 读取超时(ReadTimeout):建议设置为 4,000ms ~ 5,000ms。
2. 会话隔离与 Cookie 污染防护
批量验证不同账号时,严禁使用共享全局 Cookie 缓存的接口。每个工作线程应使用独立的 WinHttp 对象实例,或在每次请求后显式清空 Cookie 容器,避免账号 A 的鉴权 Token 影响后续账号 B 的结果判断。
五、二级缓冲与线程安全异步批量落盘
许多初学者习惯在验证完一个账号后,直接调用 写到文件 (文件路径, 当前结果) 追加内容。当开启 30~50 个线程时,数十个线程同时请求打开和写入同一个结果文件,会引发严重的 Windows 文件锁定冲突(Sharing Violation),导致数据漏写或线程被系统 I/O 阻塞。
1. 异步二级缓冲机制设计
推荐采用“内存缓冲池 + 批量刷盘”的方案:工作线程将验证结果(成功、失败、异常)推入独立的内存结果数组;当缓冲数组累积达到阈值(例如 200 条)或距离上次落盘超过设定时间(例如 1 秒)时,由专门的落盘逻辑或触发线程一次性将整批数据写入磁盘。
.参数 结果类型, 整数型 ' 1:成功 2:失败 3:异常
.参数 结果行, 文本型
.局部变量 待写文本, 文本型
进入许可区 (集_写锁)
加入成员 (集_结果缓冲, 结果行 + #换行符)
.如果真 (取数组成员数 (集_结果缓冲) >= 200)
' 达到阈值,合并写入
待写文本 = 取数组成员文本 (集_结果缓冲)
清除数组 (集_结果缓冲)
离开许可区 (集_写锁)
' 在许可区外执行落盘,释放锁供其他线程继续缓存
磁盘_追加文本 (取输出文件路径 (结果类型), 待写文本)
返回 ()
.如果真结束
离开许可区 (集_写锁)
六、生产级参数调优对照与稳定性保障
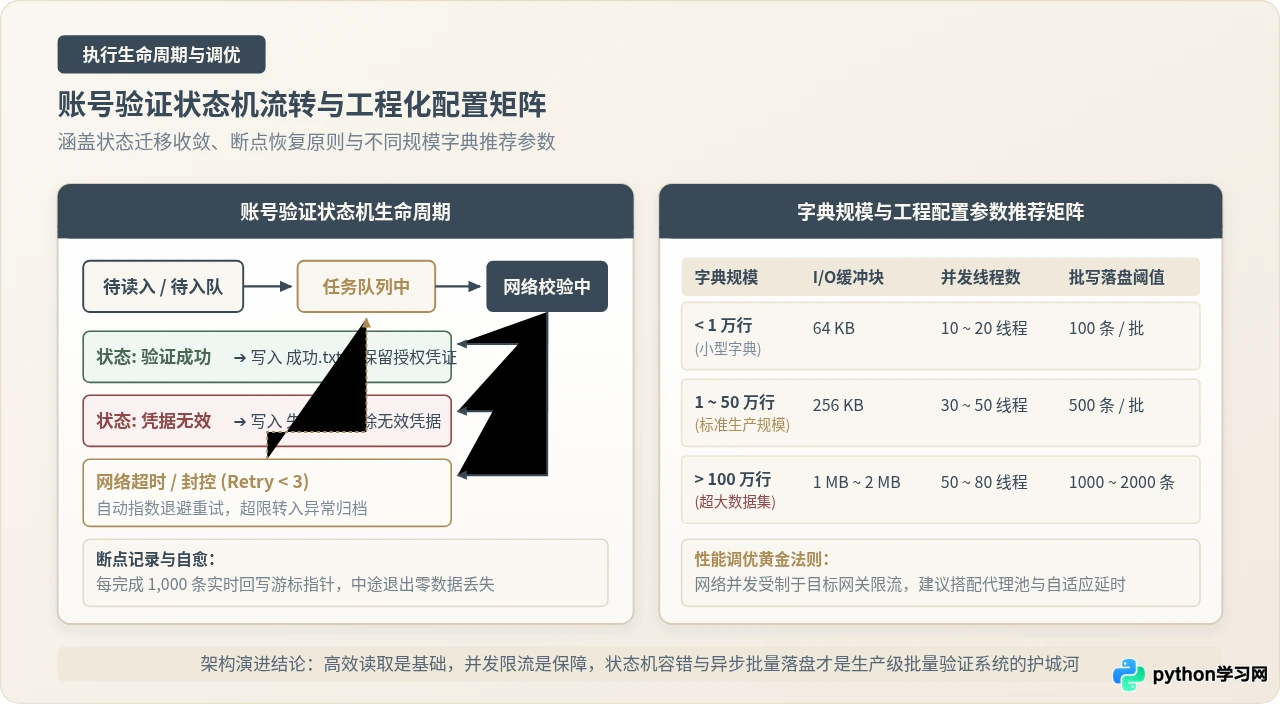
为了让软件在面对从几万行到几百万行不同规格的字典时均能维持最平稳的运行状态,以下汇总了在实际生产环境下验证有效的关键参数推荐矩阵:
| 字典行数规模 | I/O 分块尺寸 | 推荐并发线程数 | 批量落盘阈值 | 典型内存占用 | 断点持久化策略 |
|---|---|---|---|---|---|
| 小型字典 (< 1 万行) | 64 KB | 10 ~ 20 线程 | 50 ~ 100 条 | < 10 MB | 内存游标,单次执行完毕无需持久化 |
| 中型字典 (1 ~ 50 万行) | 256 KB | 25 ~ 50 线程 | 200 ~ 500 条 | 12 ~ 18 MB | 每验证 1,000 条回写游标偏移量至 offset.dat |
| 超大型字典 (> 100 万行) | 1 MB ~ 2 MB | 40 ~ 80 线程 | 1,000 ~ 2,000 条 | < 25 MB 恒定 | 必须开启文件指针游标断点续验与代理池轮换 |
核心避坑总结
-
循环内局部变量及时清理:易语言在极高频的
判断循环中如果频繁生成临时字节集或超长文本,应在循环尾部将其赋值为{ }或"",主动触发变量内存回收,避免隐式内存泄露。 -
主界面 UI 刷新解耦:千万不要让每个工作线程在完成一次验证后直接调用组件属性(如
编辑框.加入文本()或状态条.置文本())。Windows 消息循环会被海量跨线程绘制消息淹没导致界面假死。正确做法是使用全局原子计数器记录已验数量,主窗口开启一个 200ms 的时钟组件定期读取计数器并更新 UI。 -
退出时优雅关闭线程:停止任务时,先将全局运行标志置为假(
集_是否停止 = 真),等待所有工作线程自然退出并关闭句柄后再释放许可区对象,严禁直接调用强制结束线程()导致锁未释放而死锁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









