

Python使用with语句和readline()读取文件的安全实践
深入解析在Python中结合使用with上下文管理器与readline()方法读取文件的安全规范,涵盖文件描述符泄露防御、内存驻留控制、EOF正确判定及畸变超长单行防范。
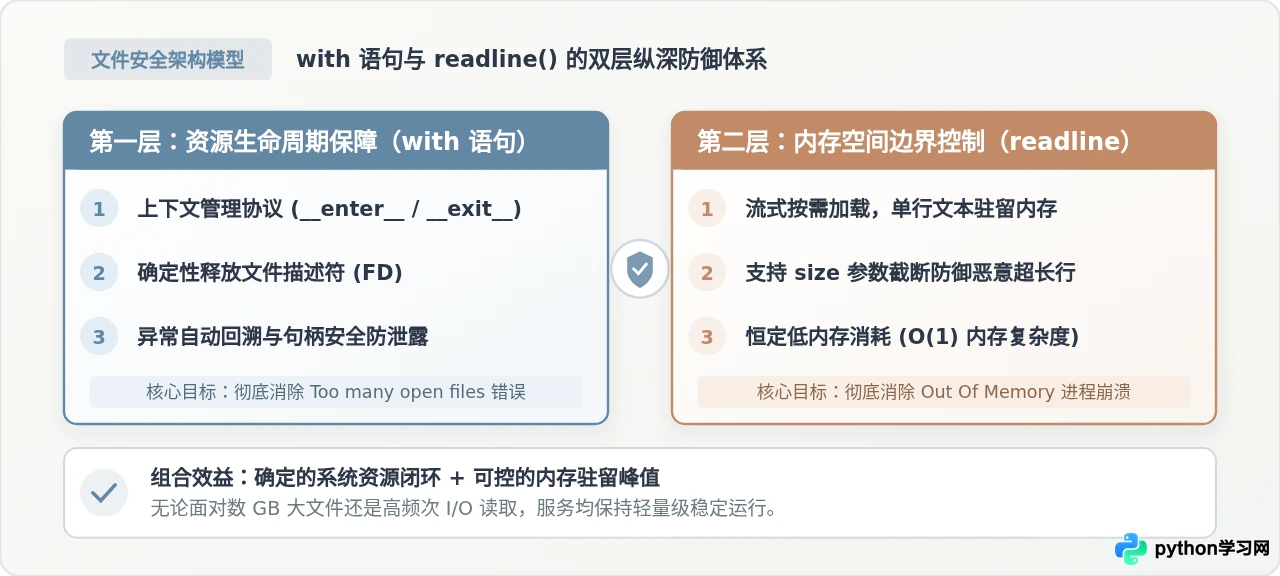
with 语句与 readline() 方法组合使用,是防范系统资源泄露与内存崩溃(OOM)的黄金范式。with 语句依托上下文管理器协议,确保无论程序正常运行还是中途抛出异常,底层文件描述符都能被确定性归还;而 readline() 则以行为单位流式加载数据,避免了全量读取对内存的不可控冲击。本文从资源生命周期、EOF 判断分流、超长单行防御及编码容错四个维度,系统拆解这一组合的安全规范与避坑要点。
一、为何必须组合使用:两大致命生产隐患
在初学 Python 时,很多教程为了演示简单,常使用 f = open(...) 搭配 f.read() 或 f.readlines()。在小规模脚本中这种写法看似运转正常,但一旦进入高并发服务、微服务容器或批处理管道,就会暴露两个极其危险的生产事故隐患:
-
文件描述符(FD)耗尽:操作系统对单个进程可打开的文件数量设有严格上限(在 Linux 环境下可通过
ulimit -n查看,常见默认值为 1024)。如果仅依赖手动f.close(),一旦在打开文件与关闭之间发生未捕获异常、提前return或复杂的控制流跳转,close()就无法被执行,导致文件句柄持续泄漏,最终触发系统级OSError: [Errno 24] Too many open files报错,导致整个服务无法建立新的网络连接或打开新文件。 -
内存耗尽与 OOM 强杀:调用
read()或readlines()会将整个文件内容或者所有行的列表一次性全部载入内存。面对数百兆乃至几十吉字节的服务器日志、导出数据或未知第三方输入,进程内存将瞬间被撑爆。在现代 Kubernetes 或 Docker 容器化环境中,这将直接触发内核cgroup OOMKilled机制,导致容器被操作系统无征兆地强行杀死。
with 语句与 readline() 的协作正是针对上述两大隐患的精准解法:前者在语言运行时层面锁定文件句柄的释放,后者在数据流处理层面锁定内存的最大驻留上限。
二、with 上下文管理器的资源保护机制
Python 的 with 语句并非简单的语法糖,其底层严格遵循上下文管理器协议(Context Manager Protocol),即实现 __enter__() 与 __exit__() 两个核心魔法方法。
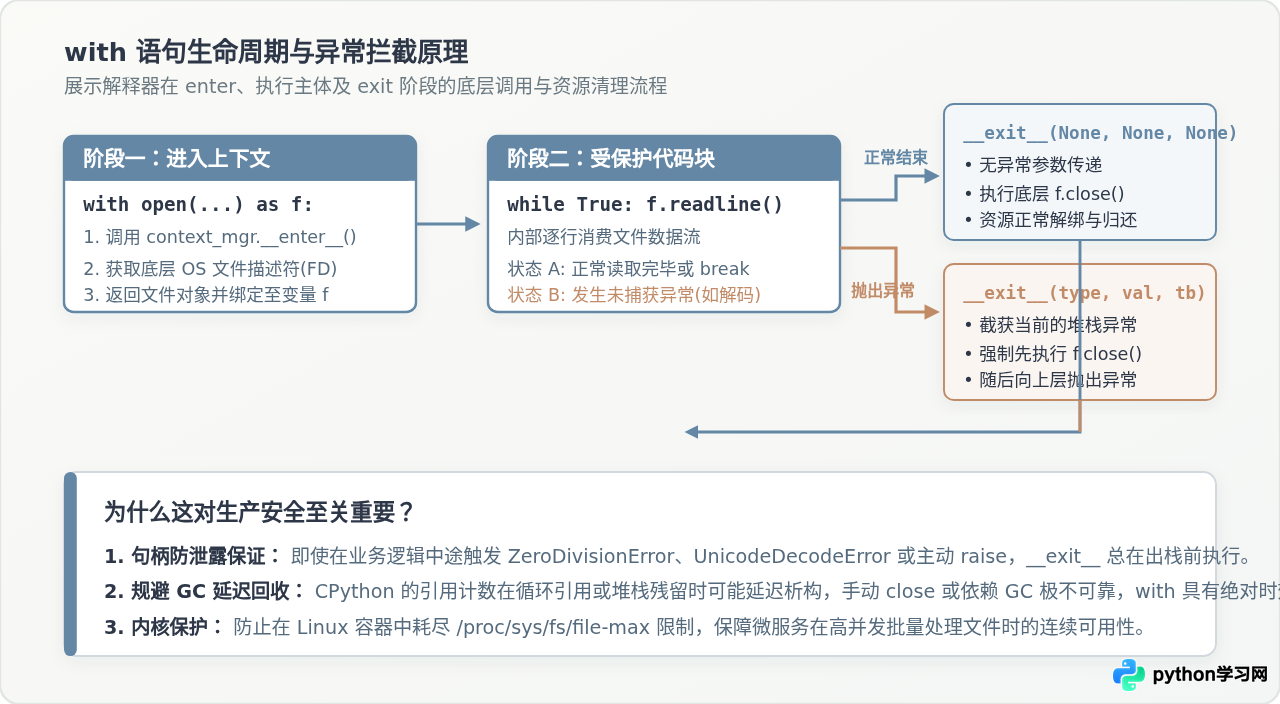
当代码执行至 with open(file_path, 'r', encoding='utf-8') as f: 时,其背后的执行序列如下:
-
获取上下文管理器:表达式
open(...)返回一个内置的文本流对象(如TextIOWrapper),该对象原生实现了上下文管理器协议。 -
触发 __enter__():解释器调用该对象的
__enter__()方法,获取系统底层分配的文件句柄,并将其返回值绑定到as后声明的变量f上。 -
进入受保护执行块:执行
with缩进块内的全部业务逻辑代码。 -
确定性退出与 __exit__() 调度:无论执行块是正常结束、遇到
break/return退出,还是中途遭遇严重异常,Python 都会确保调用__exit__(exc_type, exc_val, exc_tb)。在__exit__内部,文件对象的close()方法被立即触发,将文件描述符交还内核。
有人认为 CPython 使用引用计数,离开作用域后对象引用归零就会自动关闭。这种观点在生产中极其危险:如果局部变量被闭包引用、存入全局列表、或者在异常回溯(Traceback)对象中被间接持有,引用计数就不会归零。此外,在 PyPy 等其他 Python 实现中,垃圾回收具有非确定性延迟。唯有
with 语句能提供确定性的作用域结束即闭合保证。
三、readline() 的内存保护与 EOF 正确判定
与一次性吞入全部数据的 read() 不同,readline() 的定位是渐进式单行流式读取。它从当前文件指针游标开始,一直读取到遇到第一个换行符(
)为止,并将包括该换行符在内的整行字符串返回。下一次调用则紧接上一次游标位置继续。
1. 致命陷阱:空行与 EOF 的本质区别
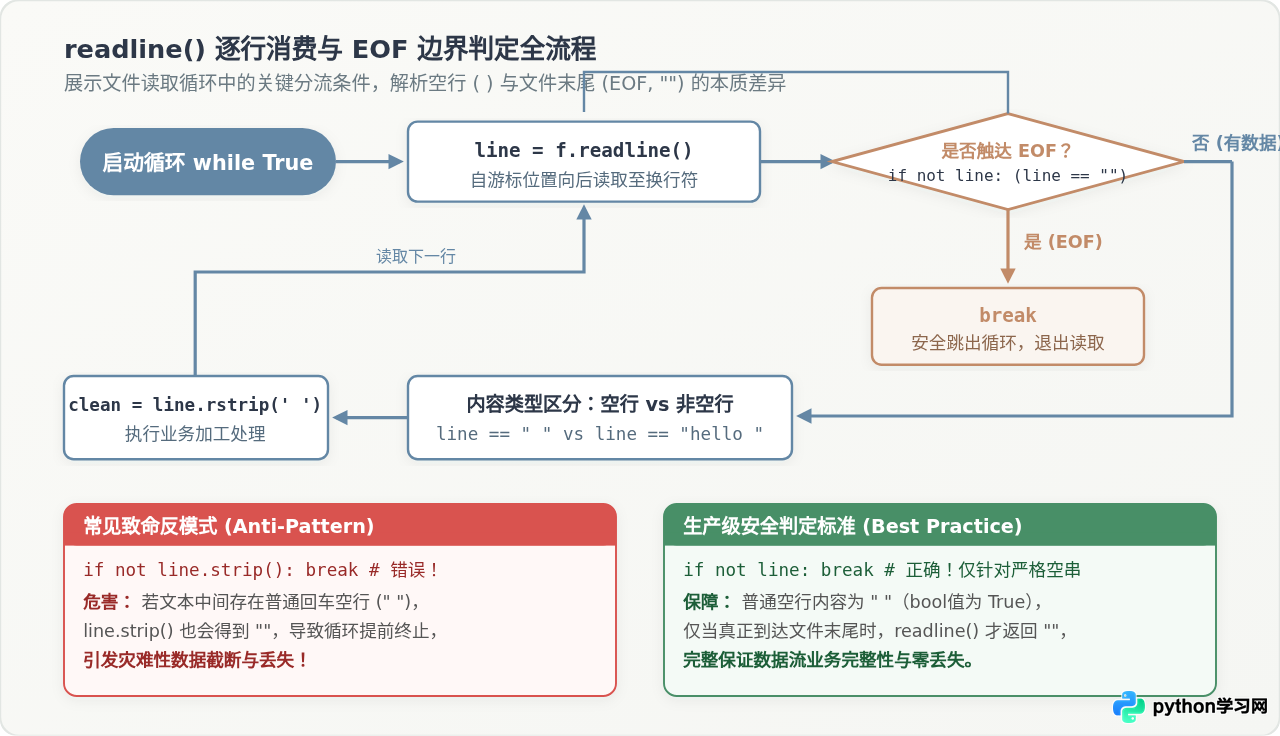
初学者在编写 readline() 读取循环时,最常犯的逻辑错误是对“文件结束”(EOF, End-of-File)的判定失准。必须清楚区分以下两种完全不同的返回值:
-
文件中的空行:当读取到文本中的空白回车行时,
readline()返回的是包含换行符的字符串" "(Windows 下为" ")。它的布尔真值为True,字符串长度为 1 或 2。 -
文件末尾(EOF):只有当文件游标已经达到物理末尾、且再无任何字节可读时,
readline()才会返回纯粹的空字符串""。空字符串的布尔真值为False,长度为 0。
很多开发者习惯在读取后随手写出 if not line.strip(): break。这是极其危险的反模式!一旦文件中段存在段落分隔空行,line.strip() 就会将其缩减为 "",从而误触发 break,导致后续所有数据被直接丢弃。
2. 规范的读取循环实现
标准的 readline() 循环应当遵循“先严格判空、再清理空白”的原则。标准实现范式如下:
# 标准安全 readline() 逐行消费范式
with open("data_stream.log", "r", encoding="utf-8") as f:
    while True:
        line = f.readline()
        # 核心判定:只有当真正触达 EOF 时,line 才等于严格空串 ""
        if not line:  # 等价于 if line == "":
            break

        # 此时确定该行存在数据(即使它是空行 "
")
        # 在此处根据业务需要剥离行尾换行符
        content = line.rstrip("
")

        # 执行本行的业务处理逻辑
        process_record(content)
四、防御超长单行与拒绝服务(DoS)隐患
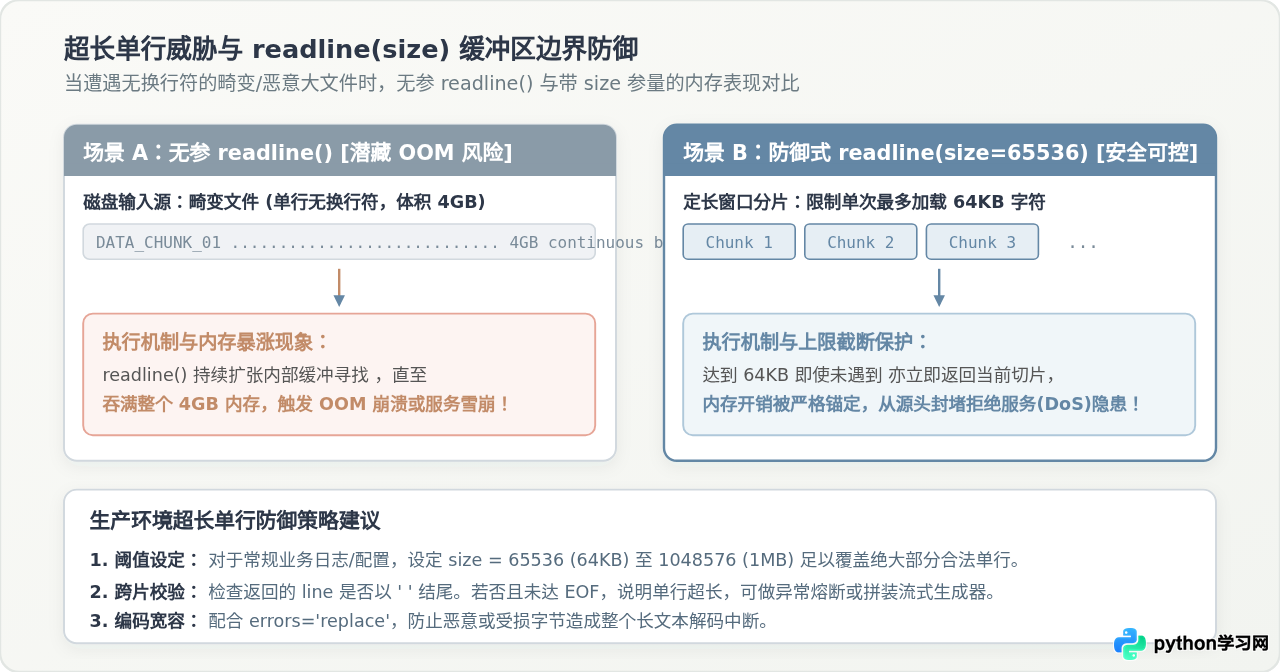
常规认识中,只要使用了 readline(),内存就不会爆炸。然而在现实网络安全防御与高可靠数据清洗中,存在一个隐蔽的攻击向量:无换行符的畸变大文件。
1. 畸变单行的破坏机制
当遇到损坏的二进制混入文本、或者由恶意攻击者精心构造的 2GB 且中途不含任何
的极端文本时,标准的 f.readline() 会持续申请系统堆内存以缓存字符,直到它找到
为止。这会导致渐进式读取在单次调用内退化为全量读取,瞬间引发内存雪崩。
2. 安全防线:使用 readline(size) 参数
Python 的 readline() 方法提供了一个可选的整数形参 size(例如 readline(65536))。该参数定义了单次调用最多允许读取的字节/字符数上限:
- 若当前行字符数小于
size,则读取到换行符后正常返回该行; - 若当前行长度超过
size,方法会在读取到第size个字符时强行截断并立即返回,而不会继续消耗内存。下次调用readline()会从截断处无缝继续。
# 防御超长单行的生产级逐行生成器
def safe_line_reader(file_path: str, max_line_bytes: int = 65536):
    """
    流式读取文件,严格限制单行最大缓冲区,防止超长行引发 OOM
    """
    with open(file_path, "r", encoding="utf-8", errors="replace") as f:
        buffer = []
        while True:
            # 单次最多只从 OS 缓冲读取 max_line_bytes 大小
            chunk = f.readline(max_line_bytes)
            if not chunk:
                # 文件结束,若缓冲区有剩余内容则产出
                if buffer:
                    yield "".join(buffer)
                break

            buffer.append(chunk)
            # 若切片以换行符结尾,说明完整读取了一行
            if chunk.endswith("
"):
                yield "".join(buffer).rstrip("
")
                buffer.clear()
            else:
                # 如果缓冲区累积超过阈值但仍未遇到换行,说明单行超长畸变
                if sum(len(c) for c in buffer) >= max_line_bytes * 4:
                    # 可选择记录警告、阶段性截断产出或抛出特定异常
                    yield "".join(buffer)
                    buffer.clear()
使用
open() 时务必显式声明 encoding="utf-8"。若忽略该参数,Windows 环境会默认采用操作系统的 ANSI(如 GBK),导致跨平台执行时抛出 UnicodeDecodeError。对于外部不可信文件,建议配置 errors="replace" 或 errors="surrogateescape",用占位符替代非法字节序列,防止单字节损坏直接打崩整个批处理流水线。
五、综合生产实践:高可靠文件读取封装与速查矩阵
结合上述各项安全考量,我们在实际项目中可以总结出如下生产级标准读取函数:
import os
from typing import Generator

def robust_read_lines(
    file_path: str,
    encoding: str = "utf-8",
    chunk_limit: int = 131072
) -> Generator[str, None, None]:
    """
    生产级高安全文件逐行生成器:
    1. 严格路径前置校验
    2. with 上下文保证句柄释放
    3. readline(size) 防止超长行内存击穿
    4. 明确 EOF 判定,零数据丢失
    5. 宽容解码,防止异常崩溃
    """
    if not os.path.isfile(file_path):
        raise FileNotFoundError(f"目标文件不存在或无法访问: {file_path}")

    with open(file_path, mode="r", encoding=encoding, errors="replace") as file_obj:
        while True:
            raw_line = file_obj.readline(chunk_limit)

            # 严格 EOF 退出:仅匹配纯空字符串
            if not raw_line:
                break

            # 剥离换行符并保留业务数据完整性
            yield raw_line.rstrip("
")
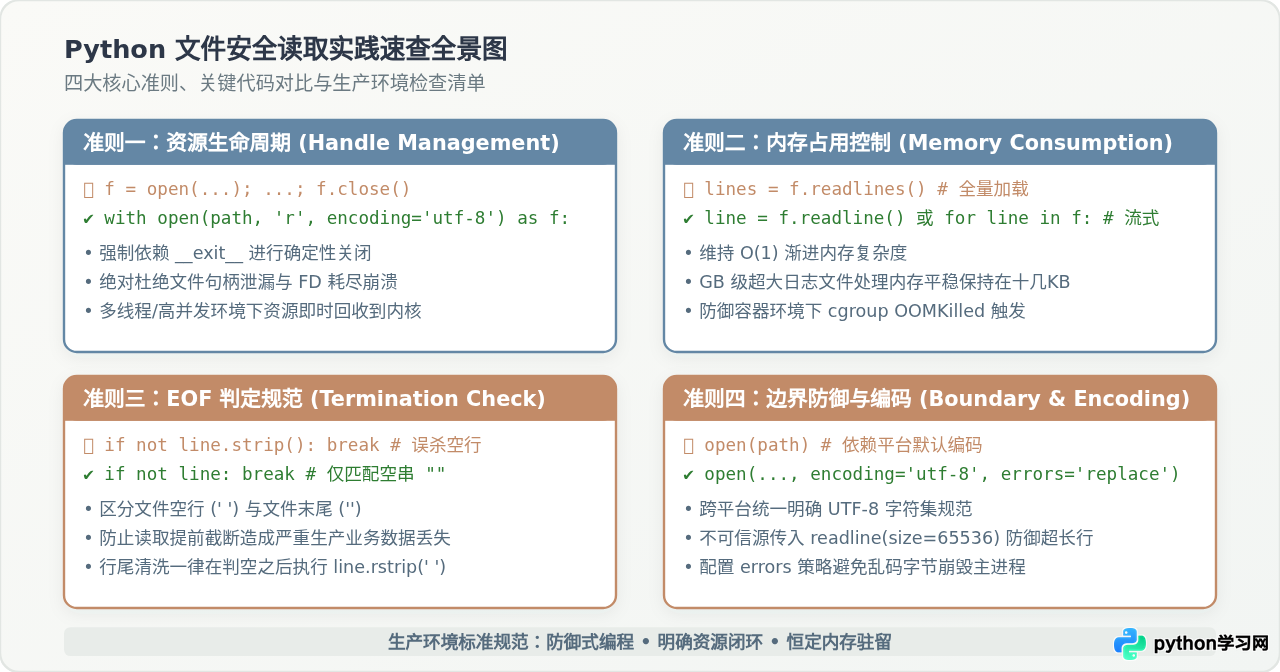
为了在开发与 Code Review 过程中快速排查潜在安全缺陷,可对照下表进行验证:
| 检查维度 | 高风险反模式 | 安全推荐模式 | 核心收益 |
|---|---|---|---|
| 资源管理 | 禁止 裸调 f = open(...) 并在末尾手工 close() |
推荐 统一使用 with open(...) as f: |
消除异常路径下的句柄泄露,规避 FD 耗尽 |
| 内存控制 | 禁止 对大文件执行 f.read() 或 f.readlines() |
推荐 使用 readline() 或直接迭代 for line in f: |
维持 O(1) 渐进内存,防止容器触发 OOMKilled |
| EOF 判断 | 禁止 使用 if not line.strip(): break |
推荐 使用 if not line: break(判定 line == "") |
区分正常文本空行与真实文件结尾,杜绝数据截断 |
| 超长畸变防范 | 注意 对未知源文件使用无参 readline() |
推荐 传入安全上限 readline(size=65536) |
防御单行无换行符的恶意 DoS 与内存暴涨 |
| 字符集安全 | 禁止 缺省 encoding 参数直接读取 |
推荐 显式声明 encoding="utf-8", errors="replace" |
规避跨系统编码不一致与非法字符解码异常 |
六、总结
在 Python 文件 I/O 体系中,with 语句与 readline() 的结合不仅是基础语法调用,更是防御式编程思想的典型体现。with 语句利用语言内核的上下文管理协议,确保了系统底层文件描述符的生命周期闭环;readline() 则将庞大的磁盘数据拆解为离散的行级流式碎片,锁定了内存驻留上限。
在日常开发中,始终坚持“显式编码、上下文包含、严格 EOF 判定、带上限流式消费”的准则,即可彻底消除文件泄露与内存溢出两类高危事故,为高负载系统的长期稳定运行筑牢基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









