

为什么Python字符串不能直接修改?正确替换字符的方法

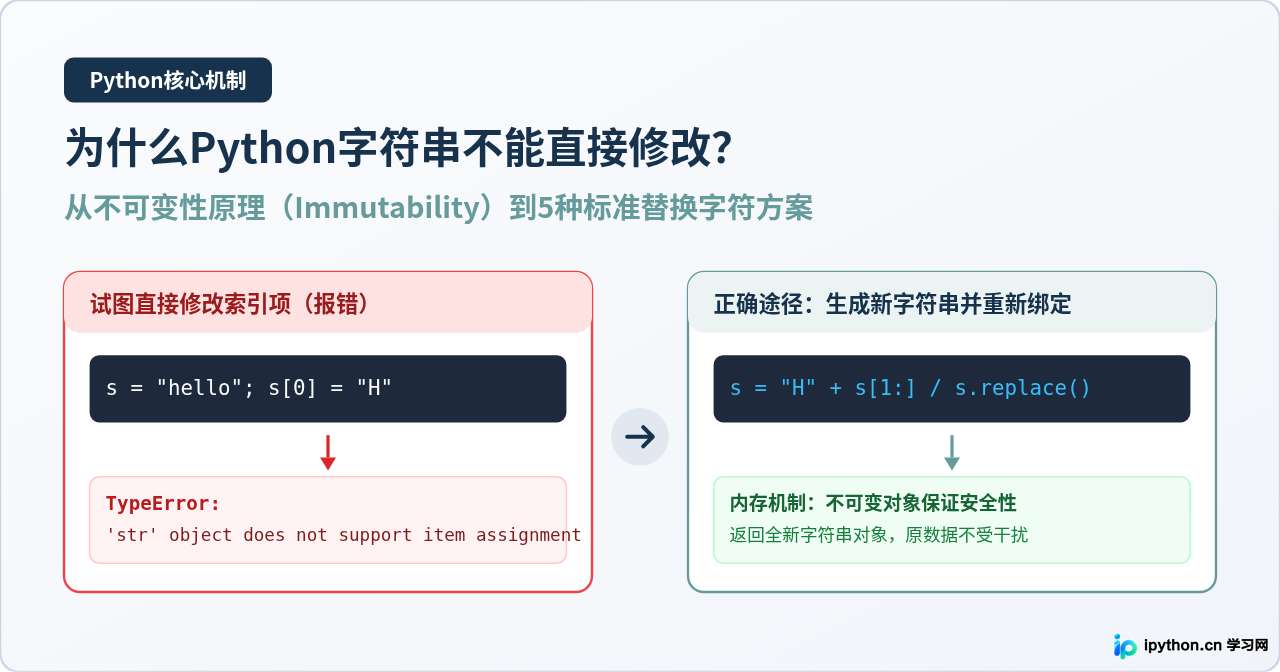
在 Python 编程中,不少初学者都遇到过这样的场景:声明了一个字符串变量 s = "hello",想要把首字母改成大写,于是顺手写下 s[0] = "H",结果程序立即中断并抛出 TypeError: 'str' object does not support item assignment。这是因为 Python 中的字符串属于不可变对象(Immutable Object)。一旦字符串在内存中完成分配,其内部存储的字符序列就固定下来,不支持任何原地的增删改操作。
理解“不可变性”不仅能帮助我们写出正确的替换逻辑,还能加深对 Python 内存模型与数据安全机制的认知。本文将直接回答为什么 Python 字符串被设计为不可变,并详细介绍在不同应用场景下替换字符的 5 种标准方法与避坑技巧。
一、核心原理:为什么 Python 字符串不能直接修改?
在底层实现中,Python 中的字符串(str)是一段连续的只读内存空间。当我们在代码中试图通过索引对某个位置重新赋值时,Python 解释器在语法解析和运行时对象协议层面会直接阻止该行为。
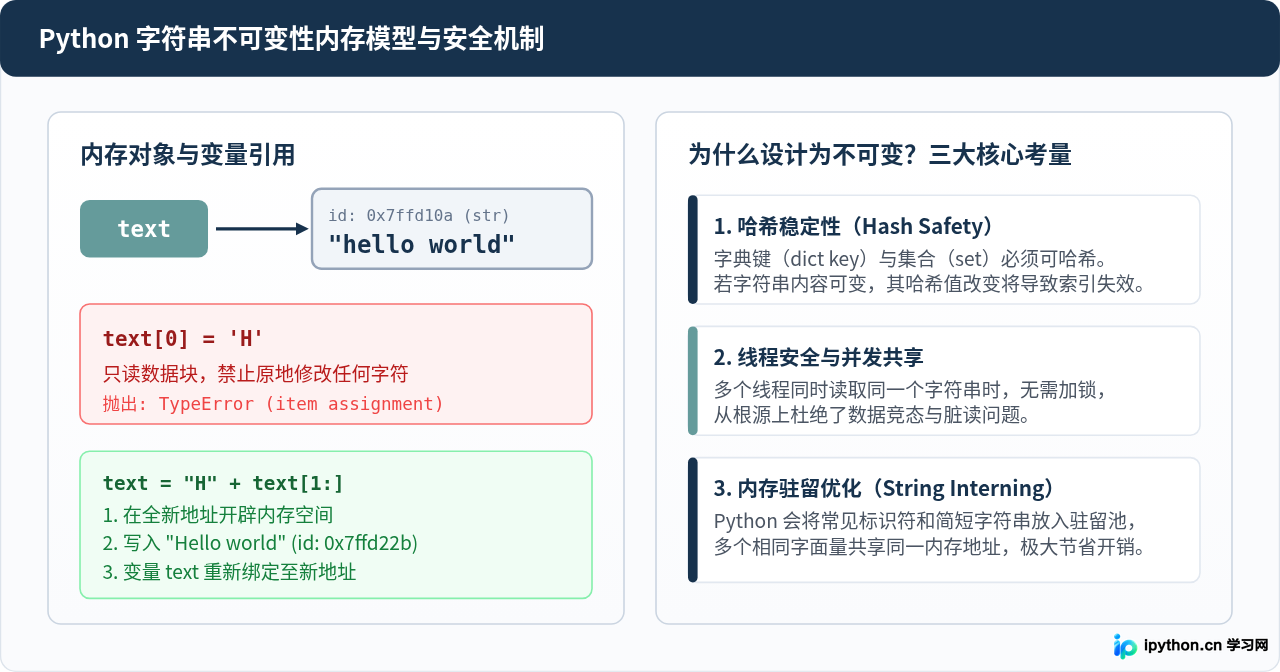
Python 语言之所以采取这种设计,主要出于以下三点关键考量:
- 作为字典键(dict key)与集合元素(set element)的基础保障: Python 字典的高效查询依赖哈希表。只有内容不可变的对象,其计算出的
hash()值才能在生命周期中保持恒定。如果字符串允许随时就地篡改,那么已被存入字典的键就会破坏哈希槽定位规则,造成数据无法检索。 - 天生的线程安全: 因为字符串不可被写入,多线程环境下并发读取同一个字符串对象时完全不需要引入互斥锁(Mutex),执行效率更高且逻辑安全。
- 字符串驻留机制(String Interning): Python 解释器会对常见的标识符、空字符串及简短字符常量执行驻留。由于内容永远不会发生变动,系统可以放心地让多个变量指向同一块内存,节省大量空间并加速比较操作。
二、正确替换字符的 5 种核心方法与步骤
既然不能直接对原字符串进行就地修改,我们在 Python 中的标准做法就是:通过切片、内置方法或转换容器生成一个新的字符串,并将新字符串赋值给原变量或新变量。根据不同的替换需求,可选择对应的方法。
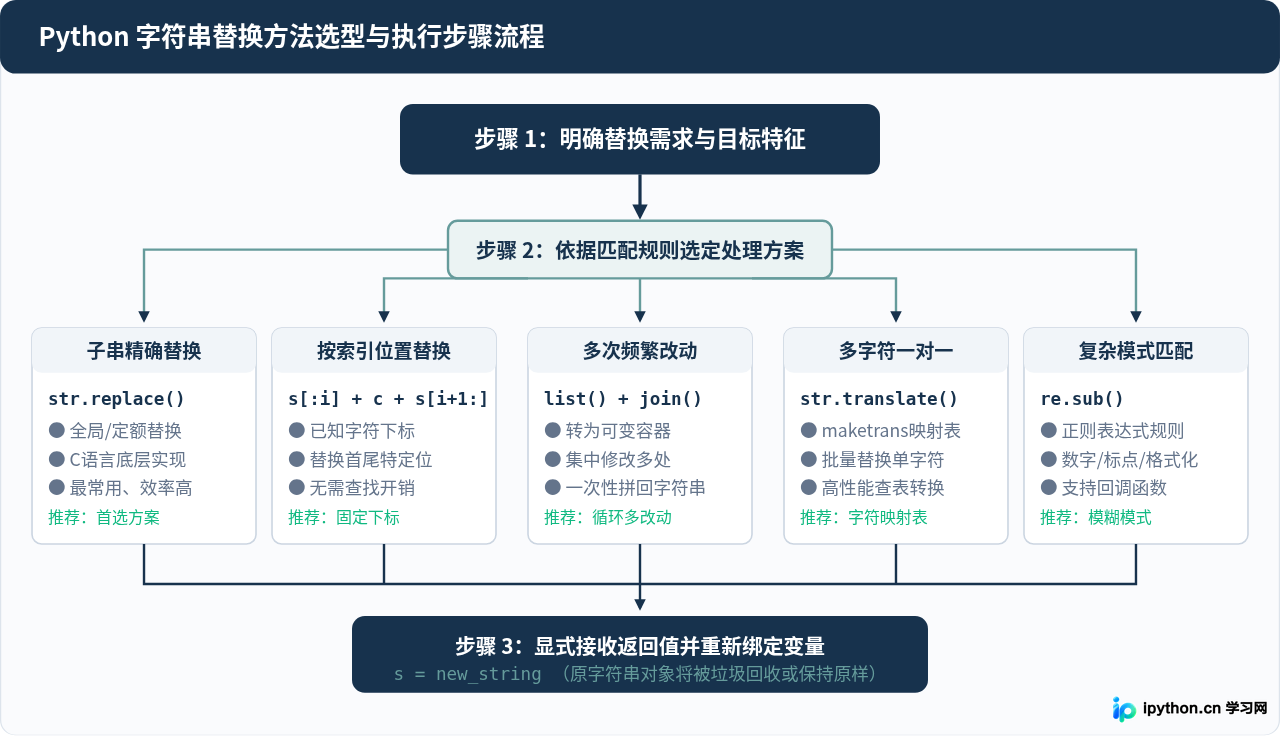
方法一:使用 str.replace()(最常用子串替换)
str.replace(old, new[, count]) 是 Python 原生支持的字符串替换函数,底层采用优化的 C 代码实现,执行效率极佳。
old:需要被替换的旧字符或子串。new:替换后的新字符或子串。count(可选):最大替换次数。默认替换所有出现的匹配项。
# 完整代码示例:使用 str.replace 替换字符
original_text = "banana"

# 1. 替换全部指定字符
result_all = original_text.replace("a", "o")
print(result_all)  # 输出示例: bonono

# 2. 限制替换次数:仅替换前 2 次
result_part = original_text.replace("a", "o", 2)
print(result_part)  # 输出示例: bonona

# 3. 原字符串保持不变验证
print(original_text) # 输出示例: banana关键提醒:str.replace() 不会也不可能改变 original_text 本身,必须将执行结果赋给变量(如 text = text.replace(...)),否则修改不会生效。
方法二:使用切片与拼接(按固定索引位置替换)
如果我们要修改的是已知下标位置的特定字符(例如把字符串第 3 个字符换成大写),由于 replace() 是按字符内容匹配,此时最精确的做法是利用切片(Slicing)将前后拆开再拼接。
# 语法结构:s[:index] + new_char + s[index + 1:]
text = "python"
index_to_replace = 0
new_char = "P"

# 切片截取:头部 [0:0] 为空,尾部 [1:] 为 "ython"
new_text = text[:index_to_replace] + new_char + text[index_to_replace + 1:]
print(new_text)  # 输出示例: Python

# 替换中间位置字符:把 index=2 的 't' 替换为 'T'
idx = 2
updated_text = text[:idx] + "T" + text[idx + 1:]
print(updated_text)  # 输出示例: pyThon
这种方法无须在字符串中遍历查找内容,直接按内存偏移量进行切片,适合单一或已知固定位置的替换。
方法三:转换为列表修改后再用 join() 拼接(批量修改高频场景)
如果需要在循环中对多个不同下标进行频繁替换,多次使用切片拼接会频繁开辟中间临时对象。由于 Python 的列表(list)是可变容器(Mutable),我们可以先将字符串转为列表,修改完成后再拼合。
# 场景:将字符串中偶数索引的字符替换为 '*'
s = "abcdefg"

# 步骤 1:转换为字符列表
char_list = list(s)  # ['a', 'b', 'c', 'd', 'e', 'f', 'g']

# 步骤 2:在列表中自由进行就地索引赋值
for i in range(0, len(char_list), 2):
    char_list[i] = "*"

# 步骤 3:使用 ''.join() 高效组合为新字符串
final_str = "".join(char_list)
print(final_str)  # 输出示例: *b*d*f*
方法四:使用 str.translate() 与 str.maketrans()(多字符映射替换)
当需要同时把多个字符一对一地映射替换为其他字符(例如字符替换密码、转义字符批量清理)时,多次调用 replace() 会导致多次整串扫描。使用 str.translate() 只需遍历一次字符串。
# 场景:同时将 'a' 替换为 '1','b' 替换为 '2','c' 替换为 '3'
text = "abc_apple_banana"

# 步骤 1:创建字符转换映射表
trans_table = str.maketrans({"a": "1", "b": "2", "c": "3"})

# 步骤 2:执行全局转换
translated_text = text.translate(trans_table)
print(translated_text)  # 输出示例: 123_1pple_21n1n1
方法五:使用 re.sub()(正则表达式模式匹配替换)
当替换条件不是固定的字符,而是符合某种模式规则时(例如把所有的连续数字替换为下划线,或者手机号脱敏),可以使用 re 模块的 re.sub()。
import re

text = "用户ID为8848,订单流水号为9527"

# 将所有连续数字替换为 "***"
masked_text = re.sub(r"\d+", "***", text)
print(masked_text)  # 输出示例: 用户ID为***,订单流水号为***
三、核心方法横向对比与选型指南
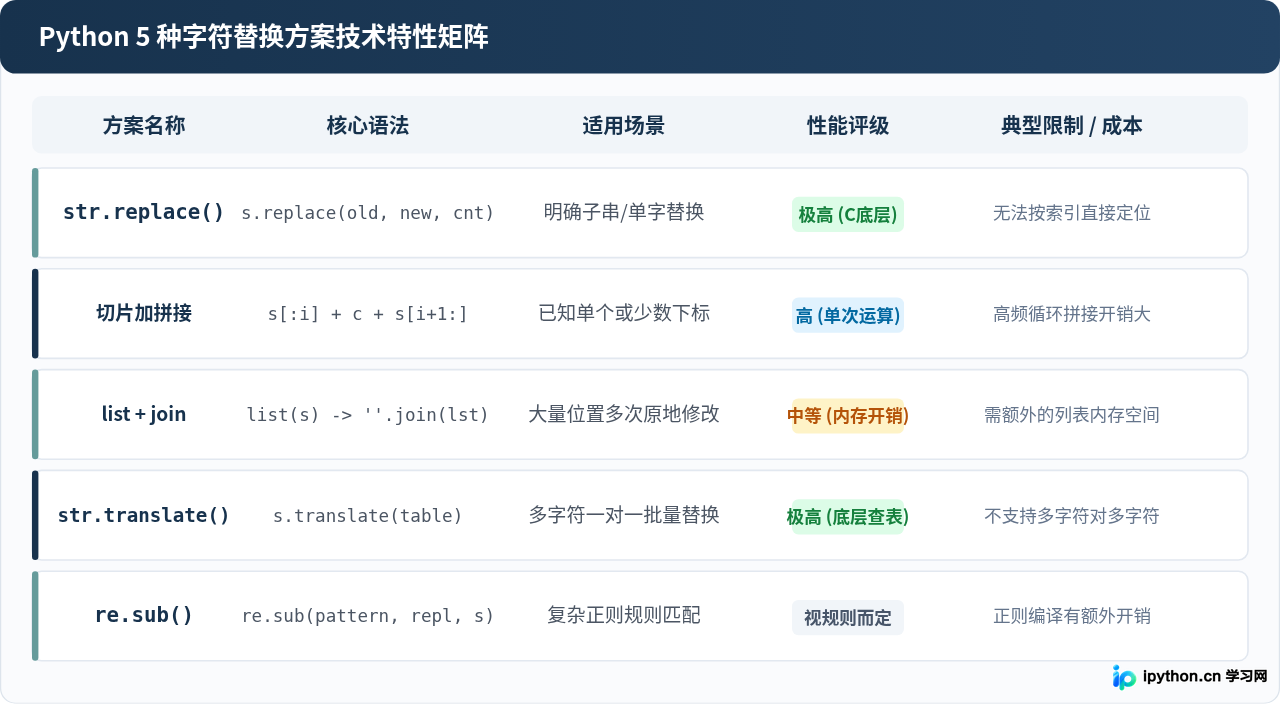
为了让选择更直观,我们可以根据以下三个问题迅速决策:
- 是否已知明确的子串或字符内容? 如果已知内容,直接使用
str.replace(),速度最快、代码最简洁。 - 是否仅按特定下标位置替换? 如果只需要修改某处字符(如首字符改大写、替换第 N 位),优先使用切片加拼接。
- 是否需要批量处理? 如果是多字符单字映射,用
str.translate();如果是在循环中多次按索引修改,先转为list再join。
四、常见开发陷阱与性能优化建议
高频陷阱 1:忘记接收返回值
很多开发者写下 text.replace("a", "b") 后直接打印 text,发现内容毫无变化。务必记住:字符串方法绝不会改变原对象,必须显式赋值:text = text.replace("a", "b")。
高频陷阱 2:在循环中滥用 += 频繁拼接
如果在处理大文本或长循环时,不断执行 s += new_char,由于每次 += 都在创建新的字符串对象并复制之前的所有字符,会导致时间复杂度退化为 O(n²)。正确做法是将字符放入列表(list.append()),最后一次性调用 "".join(list),达到 O(n) 的线性复杂度。
五、总结与速查
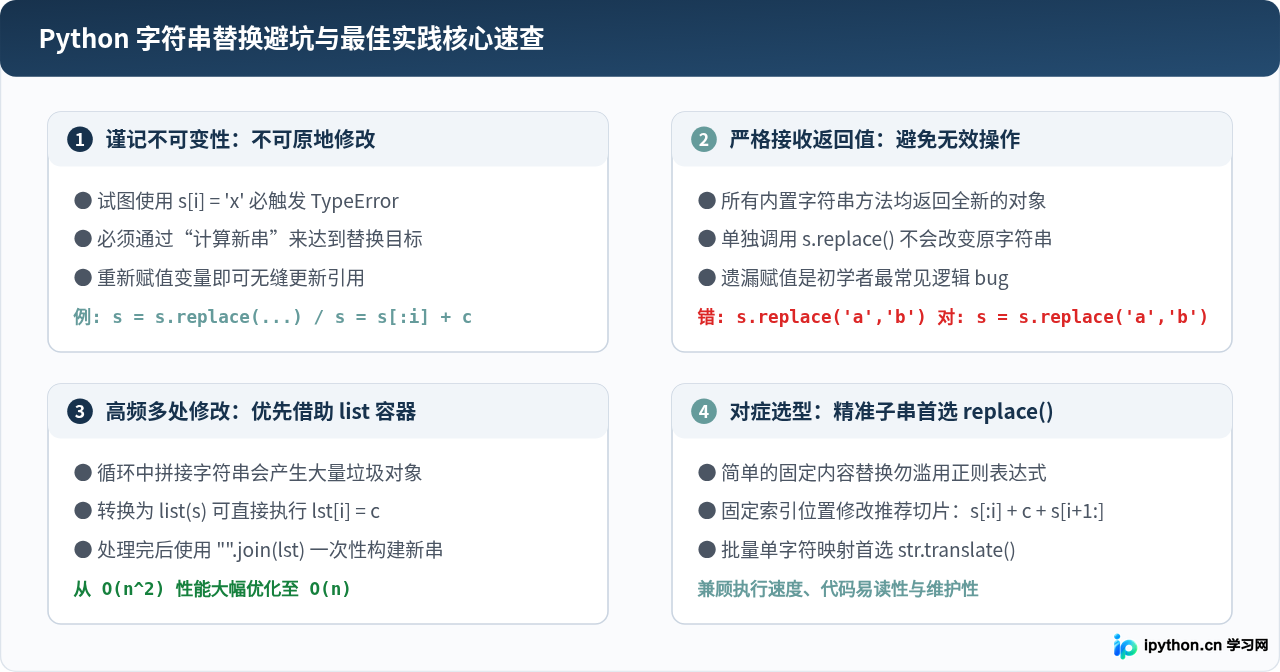
总结来说,Python 字符串不能直接修改是语言为了哈希稳定性、字典效率和线程安全所做的核心设计,而不是缺陷。遇到替换字符的需求时,只要牢记“不可变性”并使用 replace()、切片拼接、list 转换或 translate() 等方法生成新字符串并接收返回值,就能轻松写出健壮高效的代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









