

Python字符串strip、lower和upper方法使用教程
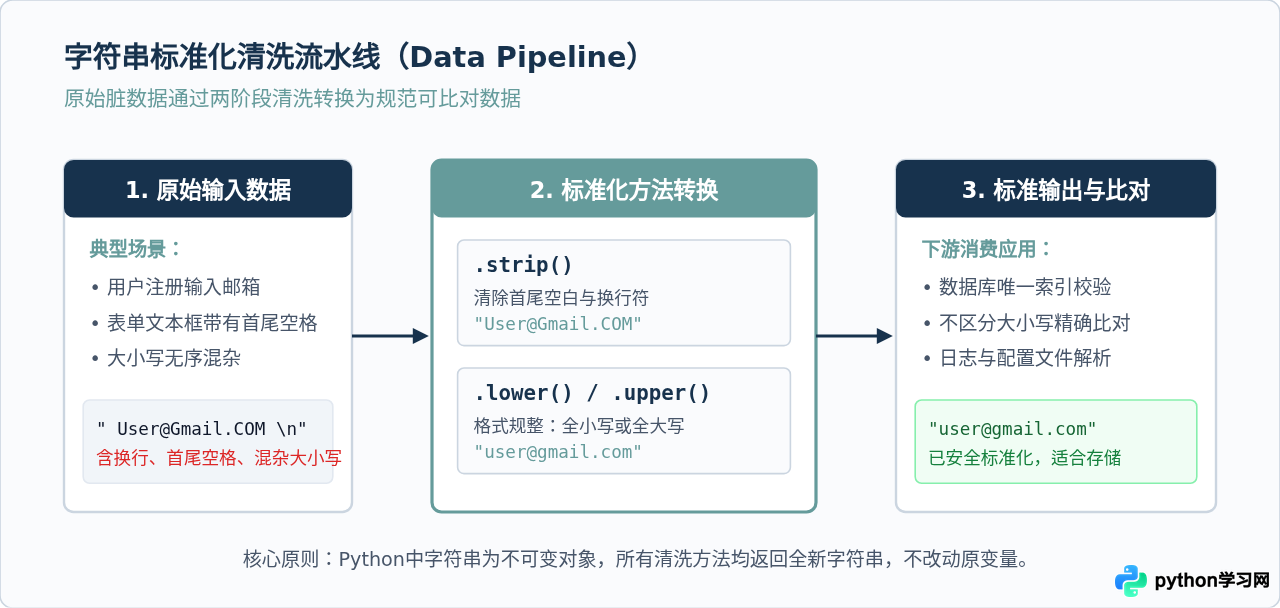
在编写Python程序处理文本、接收用户表单、读取配置文件或解析爬虫数据时,文本常常伴随着多余的前后空格、换行符以及大小写混杂的问题。本文直接讲解三个最常用且不可或缺的Python内置字符串清洗工具:strip()、lower() 与 upper()。通过本教程,你将掌握它们的核心用法、工作原理、参数陷阱以及高效的链式调用技巧。
一、strip() 方法:剥离首尾多余字符
strip() 方法的主要任务是删除字符串开头与结尾的空白字符或指定字符集合。在默认不传任何参数的情况下,它会清除包括空格(" ")、制表符(\t)、换行符(\n)以及回车符(\r)在内的所有空白字符。
1. 基础用法:剥除空白字符
# 示例 1:默认清除首尾空白与换行
raw_text = "   \n\t  Hello, Python!   \t \n"
clean_text = raw_text.strip()

print(f"处理前长度: {len(raw_text)}")  # 示例输出:27
print(f"处理后内容: '{clean_text}'")  # 示例输出:'Hello, Python!'
print(f"处理后长度: {len(clean_text)}") # 示例输出:14
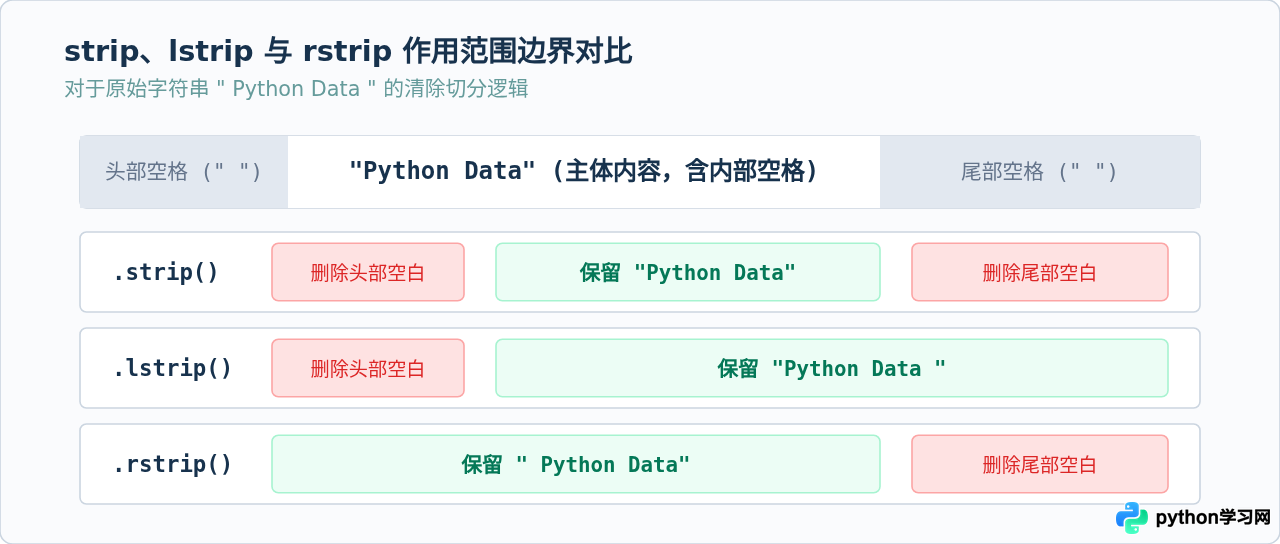
2. 兄弟方法:lstrip() 与 rstrip()
除了双向清除的 strip() 之外,Python 还提供了单向清除版本:
lstrip()(Left Strip):仅删除字符串开头的匹配字符。rstrip()(Right Strip):仅删除字符串末尾的匹配字符。
3. strip(chars) 参数机制:字符集匹配而非子串匹配
很多初学者会误以为 strip("abc") 是删除前后的 "abc" 单词,实际上它接收的是一个字符集合(Character Set)。只要首尾字符属于该集合中的任何一个,就会持续剥离,直到遇到不在集合中的第一个字符为止。
# 示例 2:传入 chars 参数(字符集合剥除)
text = "...www.example.com///"
# 传入 ".w/",表示清除首尾所有的 '.'、'w' 和 '/'
cleaned = text.strip(".w/")
print(cleaned)  # 示例输出:example.com

# 易错陷阱演示:
filename = "spammyspam.py"
print(filename.strip("spam"))  # 示例输出:y.py
# 解释:首部的 's', 'p', 'a', 'm', 'm' 都在集合 "spam" 中被依次剥除,留下 'y.py'https://),请在 Python 3.9 及以上版本中使用 removeprefix() 和 removesuffix(),切忌滥用 strip()。
二、lower() 与 upper() 方法:大小写规范化
在做字符串比较时,Python 默认是严格区分大小写的,例如 "admin" == "Admin" 会直接返回 False。为了消除输入差异,常用 lower() 统一转小写或 upper() 统一转大写。
1. 基础用法与核心作用
# 示例 3:lower() 与 upper() 基础转换
username = "Alex_Smith"

lower_name = username.lower()
upper_name = username.upper()

print(lower_name)  # 示例输出:alex_smith
print(upper_name)  # 示例输出:ALEX_SMITH
print(username)    # 示例输出:Alex_Smith(原变量不受任何影响)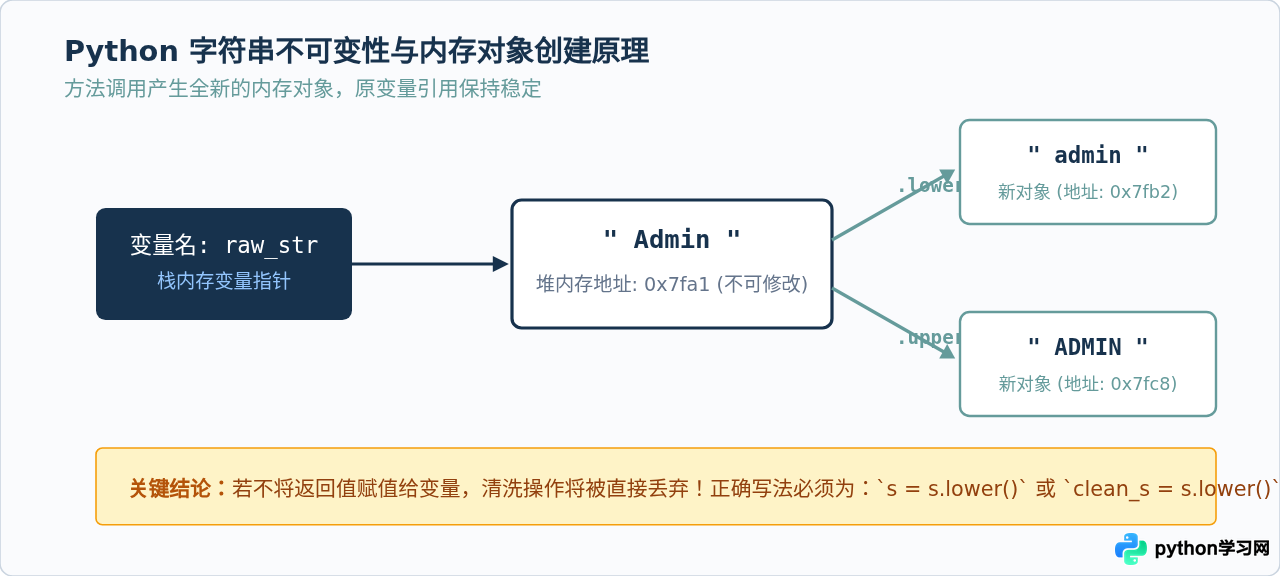
2. 为什么不用 lower() 而是 casefold()?
在绝大多数日常文本处理场景(中文、英文、数字)中,lower() 已经完全够用且执行效率极高。但如果涉及德语等特殊语言(例如德语小写字母 ß 转为大写是 SS,再转回 lower() 依然是 ß),Python 推荐在做无视大小写的比对时使用 casefold()。对于普通英文和标识符匹配,两者行为一致。
三、实战结合:链式调用与组合清洗
由于 strip()、lower() 和 upper() 的返回值依然是 str 类型,我们可以将它们无缝串联在一起进行链式调用(Method Chaining)。在实际业务中,最典型的组合就是“先去两端空格,再统一转小写”。
# 示例 4:业务场景 —— 用户登录账号比对
def authenticate_user(input_account: str, target_account: str) -> bool:
    # 步骤:去除前后多余空格与换行,并规范化为全小写
    normalized_input = input_account.strip().lower()
    normalized_target = target_account.strip().lower()

    return normalized_input == normalized_target

# 测试验证
user_input = "   John.Doe@Enterprise.com \n"
db_account = "john.doe@enterprise.com"

if authenticate_user(user_input, db_account):
    print("验证通过:用户身份匹配成功!")
else:
print("验证失败:用户名或账号错误!").strip().lower(),先移除多余字符可以减少后续大小写映射时的字符处理量。
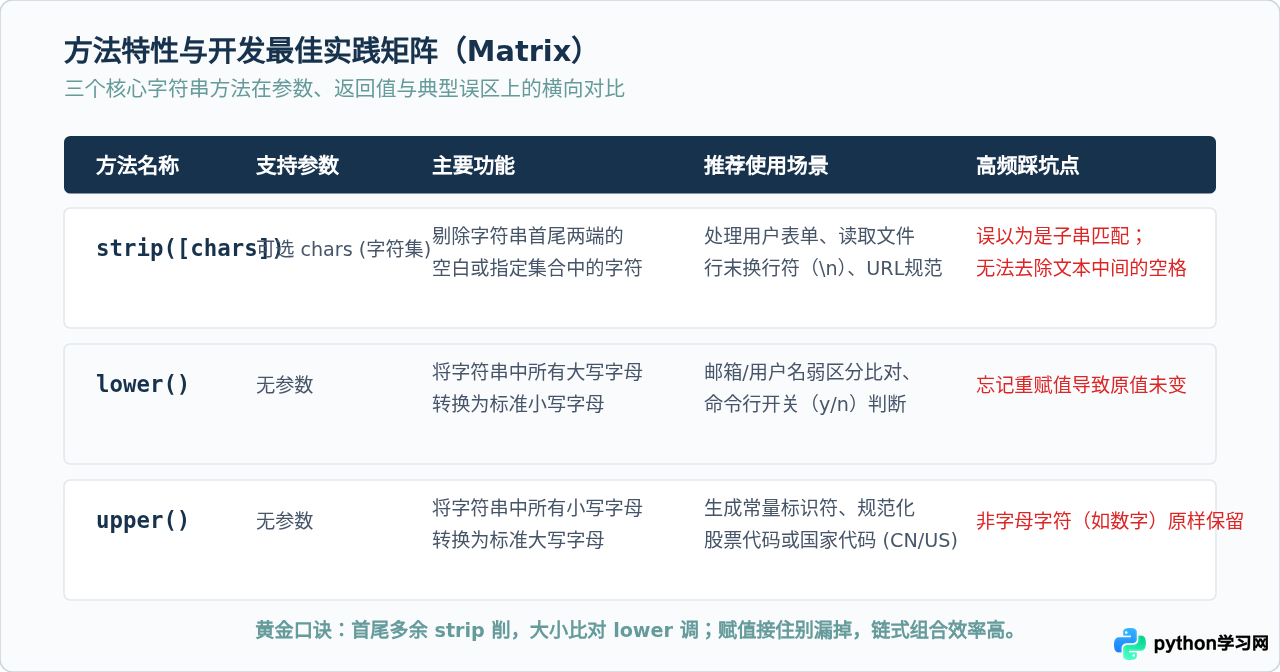
四、三大方法特性速查与避坑总结
下表与图示全面总结了三个方法的适用场景、参数特性与易踩盲点:
常见问题答疑(FAQ)
- 问:我想把字符串内部所有多余的连续空格也压缩成一个,能用
strip()吗?
答:不能。strip()只处理两端。对于文本中间的多余空格,最简便的做法是结合split()与join(),例如:" ".join(text.split())。 - 问:如果变量是
None,调用这些方法会怎样?
答:会抛出AttributeError: 'NoneType' object has no attribute 'strip'异常。在调用之前,请确保变量确实是字符串,或者使用防护判断:text.strip().lower() if text else ""。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









