

Python字符串split、find和replace方法的具体用法

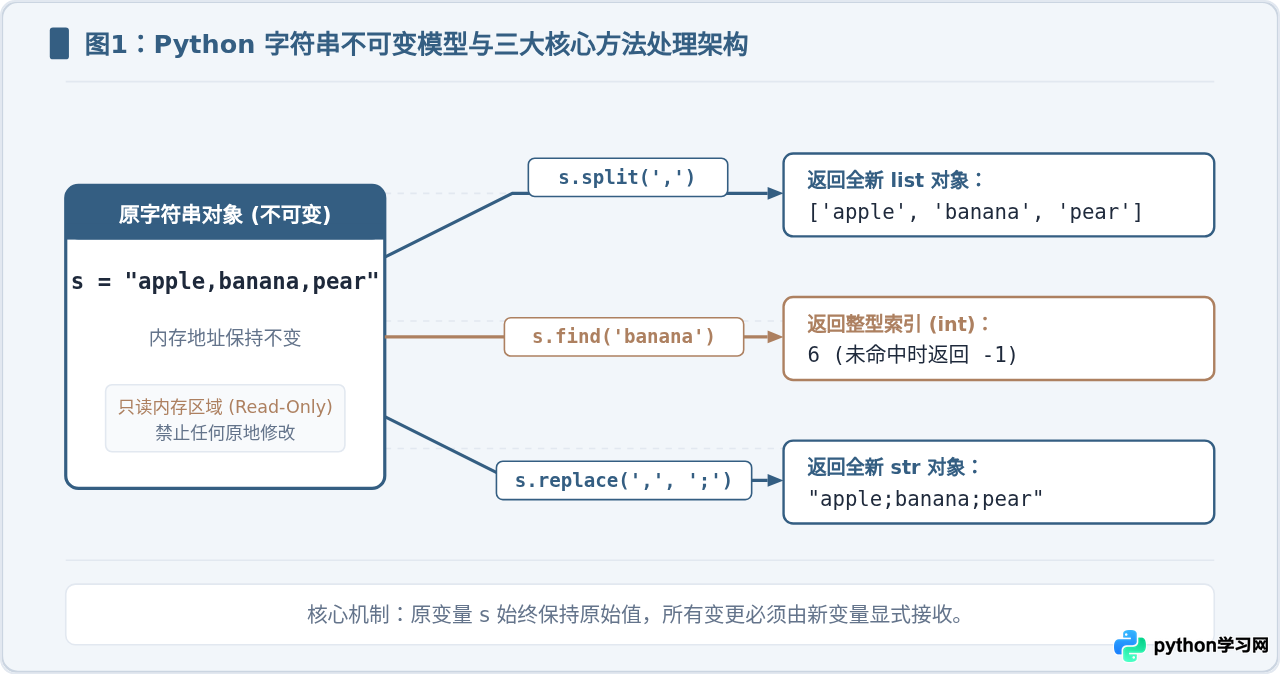
在 Python 文本处理中,split()、find() 和 replace() 是最高频使用的三大内置字符串方法,它们分别承担了字符串的“拆分截断”、“检索定位”与“内容替换”职责。由于 Python 中的字符串(str)具有不可变特性(Immutable),这三个方法在执行时绝不会修改原始字符串本身,而是始终返回处理后的新对象或数值。本文将针对这三个方法的具体语法、参数细节、边界行为及工程协同场景展开全面剖析。
一、split() 方法的具体用法:字符串拆分
split() 方法用于将一个字符串按照指定的分隔符切分为多个子字符串,并将结果作为包含各个片段的列表(list)返回。
1. 语法签名与参数解释
str.split(sep=None, maxsplit=-1)sep(分隔符):指定用于切分的分隔字符串。如果不传或传None,Python 会采用一套特殊的“连续空白符切分”算法;如果指定了具体字符(例如','或'|'),则进行严格的精确匹配切分。maxsplit(最大切分次数):控制最多切分的次数。默认值为-1,表示没有限制,全部切分。如果设置为正整数k,则最多切分k次,返回的列表长度最多为k + 1,剩余未切分的部分将保留在最后一个元素中。
2. sep 为 None 与指定字符的关键差异
这是初学者最容易产生混淆的地方:
- 当
sep=None时:字符串开头和结尾的所有空白字符(包括空格、\t、\n、\r)会被自动忽略,且中间连续的多个空白字符会被当成一个整体分隔符,绝不会产生空字符串项。 - 当
sep=' '(显式指定单空格)时:Python 执行严格匹配。如果遇到两个连续空格,中间就会切出一个空字符串"";字符串开头或结尾的空格也会在列表两端生成空字符串。
# 示例 1:默认连续空白切分 vs 严格空格切分
text = "   python   fast   reliable   "

# 默认模式:自动合并连续空白,忽略首尾空白
res_default = text.split()
print("默认切分:", res_default)
# 示例输出: 默认切分: ['python', 'fast', 'reliable']

# 显式单空格:严格按单个空格切,产生大量空字符串
res_strict = text.split(' ')
print("严格切分:", res_strict)
# 示例输出: 严格切分: ['', '', '', 'python', '', '', 'fast', '', '', 'reliable', '', '', '']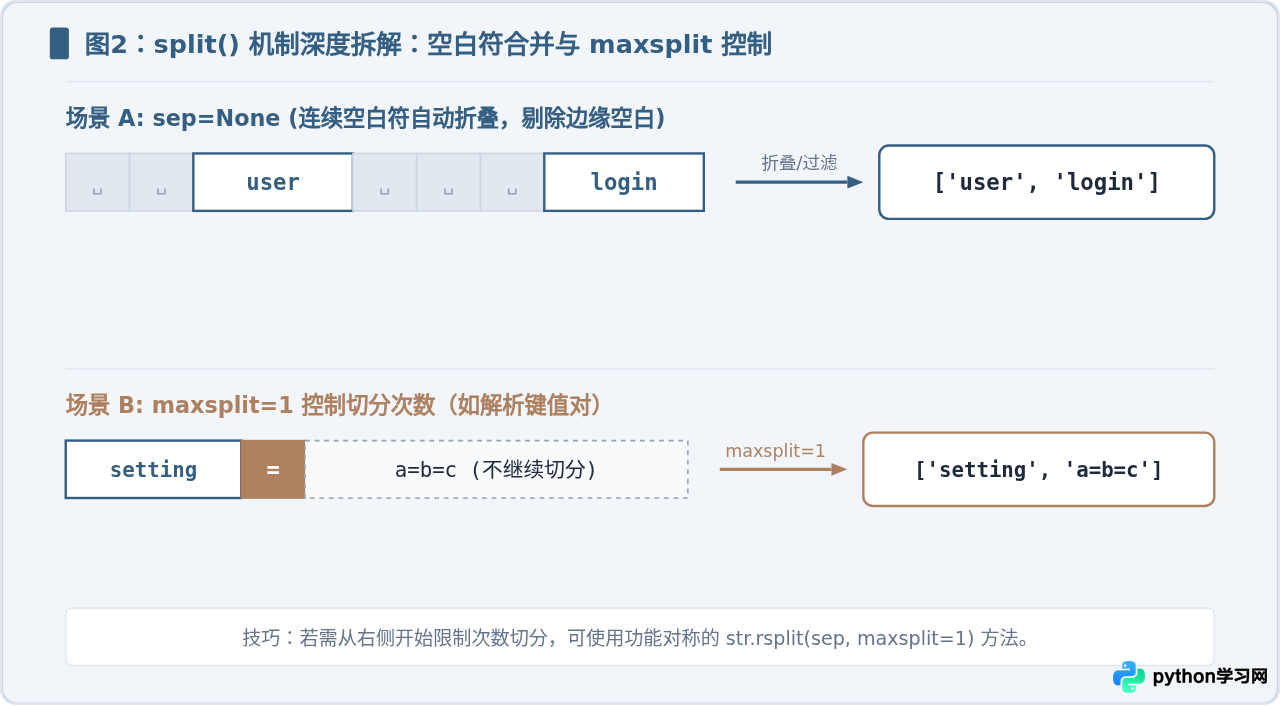
3. maxsplit 的工程实战:提取键值对
在解析配置文件或 URL 查询参数时,值本身可能含有等于号(=)。此时若直接使用 split('=') 会导致多余的拆分破坏原始数据,传入 maxsplit=1 即可保证安全。
# 示例 2:使用 maxsplit=1 保障后续数据完整性
raw_config = "database_uri=postgresql://user:pass@localhost:5432/app_db"

# 仅切分第 1 个等号
key, value = raw_config.split('=', maxsplit=1)
print("键:", key)
print("值:", value)

# 示例输出:
# 键: database_uri
# 值: postgresql://user:pass@localhost:5432/app_db
二、find() 方法的具体用法:子串查找与位置定位
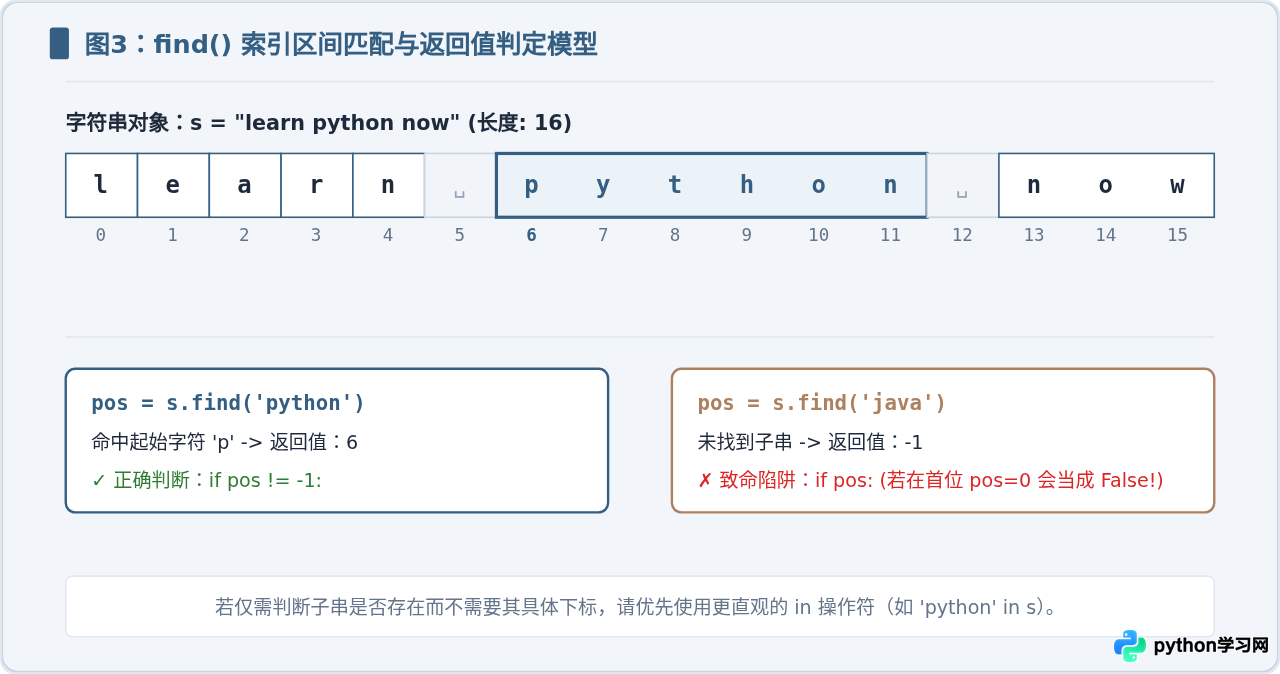
find() 方法用于在字符串中检索指定的子字符串。如果找到了目标子串,返回其首次出现的从 0 开始的最小索引位置;如果未找到,则返回 -1。
1. 语法签名与参数解释
str.find(sub[, start[, end]])sub(目标子串):需要查找的字符串片段。start(起始索引,可选):检索范围的起始位置,包含该位置(闭区间),默认为0。end(结束索引,可选):检索范围的结束位置,不包含该位置(开区间),默认为字符串末尾。
Python 中还提供了另一个极为相似的方法 str.index()。二者的唯一区别在于找不到子串时的行为:find() 优雅返回 -1,而 index() 会抛出 ValueError: substring not found 异常。
使用原则:如果不确定子串是否存在,应优先使用 find();若逻辑上要求子串必须存在、缺失属于严重错误时,才使用 index()。
2. 典型用法与循环查找所有位置
find() 默认只返回第一个匹配项的位置。通过灵活递增 start 参数,可以实现检索出目标子串在长文本中的所有出现下标:
# 示例 3:利用 start 参数遍历子串的所有出现位置
document = "abca_123_bca_456_bca"
target = "bca"

positions = []
start_idx = 0

while True:
    found_idx = document.find(target, start_idx)
    if found_idx == -1:
        break
    positions.append(found_idx)
    # 下次查找从命中位置之后继续推进,避免死循环
    start_idx = found_idx + len(target)

print("目标子串出现的全部索引位置:", positions)
# 示例输出: 目标子串出现的全部索引位置: [1, 9, 17]
三、replace() 方法的具体用法:内容替换与脱敏
replace() 方法返回一个新字符串,其中所有的(或指定数量的)旧子串都被替换为新子串。
1. 语法签名与参数解释
str.replace(old, new[, count])old(旧子串):需要被替换的子字符串。new(新子串):用来替换的新字符串(传空字符串""即为删除old子串)。count(最大替换次数,可选):指定最多替换几处。若不指定,默认替换所有出现的old。如果传入count=1,则仅替换第一处。
2. 基础替换与限制次数示例
# 示例 4:全局替换 vs 限制次数替换
template = "Error: [404] Page Not Found. Error: [500] Internal Server Error."

# 全局替换所有 "Error" 为 "Warning"
res_all = template.replace("Error", "Warning")
print("全局替换:", res_all)
# 示例输出: 全局替换: Warning: [404] Page Not Found. Warning: [500] Internal Server Error.

# 仅替换第 1 处
res_limit = template.replace("Error", "Warning", 1)
print("限定单次替换:", res_limit)
# 示例输出: 限定单次替换: Warning: [404] Page Not Found. Error: [500] Internal Server Error.
3. 链式调用进行多字符清洗
因为 replace() 每次返回的仍然是一个合法的 str 对象,开发者可以采用“链式调用”(Method Chaining)的方式,按顺序清洗多种不同的噪音字符:
# 示例 5:链式清洗用户输入的杂质标点
raw_phone = "+86 (010)-8888 6666"

# 依次去除括号、加号、减号和空格
cleaned_phone = (
    raw_phone.replace("+86", "")
             .replace("(", "")
             .replace(")", "")
             .replace("-", "")
             .replace(" ", "")
)
print("清洗后纯数字号码:", cleaned_phone)
# 示例输出: 清洗后纯数字号码: 01088886666
四、工程实战:三大方法的组合联动
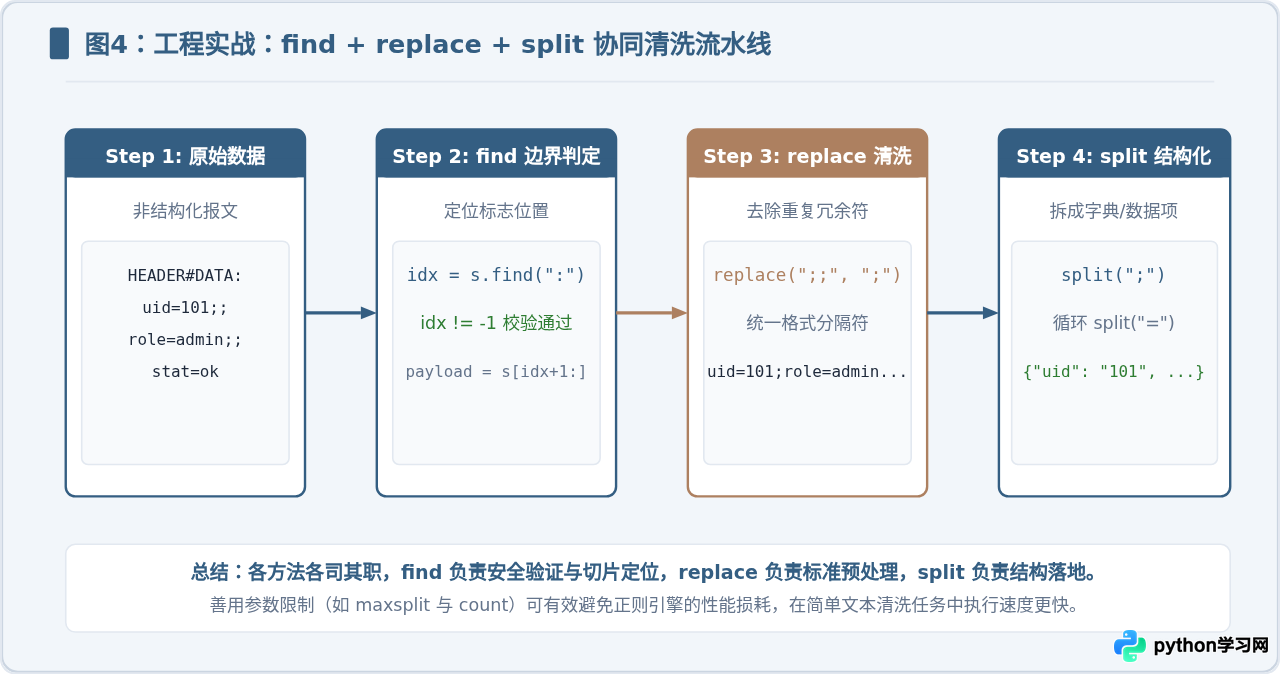
在实际工程场景中,单项功能往往难以独立满足复杂的数据清洗要求。最典型的模式是:先用 find() 校验报文合法性并定位有效载荷边界,再用 replace() 过滤噪音符号,最后使用 split() 将纯净文本拆解成可直接查询的字典或结构化数据。
# 示例 6:三大方法协同清洗非规范日志行的完整代码
raw_log = "METRIC_LOG#2026-10-22:cpu_usage=88%;;mem_usage=64%;;disk_usage=45%;;"

# 1. 使用 find() 验证特征标识并定位数据载荷
colon_pos = raw_log.find(":")
if colon_pos == -1:
    raise ValueError("日志格式非法:缺少冒号分隔符")

# 截取载荷部分: "cpu_usage=88%;;mem_usage=64%;;disk_usage=45%;;"
payload = raw_log[colon_pos + 1:]

# 2. 使用 replace() 消除连写分号脏数据,并清理末尾多余符号
cleaned_payload = payload.replace(";;", ";").strip(";")

# 3. 使用 split() 转换为 Python 字典
metric_dict = {}
for item in cleaned_payload.split(";"):
    if item:
        key, val = item.split("=", maxsplit=1)
        metric_dict[key] = val

print("解析出的结构化指标:", metric_dict)
# 示例输出: 解析出的结构化指标: {'cpu_usage': '88%', 'mem_usage': '64%', 'disk_usage': '45%'}
五、核心方法特性对比与速查总结
为了便于在日常开发中迅速做出判断与选型,下表对 split()、find() 和 replace() 的核心特性进行了系统归纳:
| 方法名称 | 核心功能 | 典型参数 | 返回值类型 | 未命中/边界行为 |
|---|---|---|---|---|
split() |
按指定符号切分字符串 | sep=None, maxsplit=-1 |
list (字符串列表) |
若分隔符未在文本中出现,返回包含原字符串单元素的列表 [s] |
find() |
定位子串首次出现位置 | sub, start=0, end=len(s) |
int (起始索引) |
若未检索到子串,安全返回 -1,不抛异常 |
replace() |
将旧内容替换为新内容 | old, new, count=-1 |
str (全新字符串) |
若 old 子串不存在,返回原字符串副本,不产生任何变更 |
- 警惕 0 的布尔判定:永远不要用
if s.find(sub):判断包含关系,命中索引 0 时会被误判为False,必须显式书写if s.find(sub) != -1:或直接使用in关键字。 - 优先利用默认空白切分:清洗排版不规范的人工输入时,直接调用无参
s.split(),它会自动吞噬首尾空格并折叠连续制表符与换行符。 - 大文本替换注意内存:由于字符串不可变,多次连续调用
replace()会频繁申请与销毁内存。面对超长文本或多模式替换,可考虑使用re.sub()或列表缓冲构建。 - 精准截取用 maxsplit:处理
key=value=detail类似结构时,务必加上maxsplit=1,防止后续内容被意外打碎。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









