

Python字符串常用方法有哪些?内置函数分类速查表
发布时间:2026-10-27| 4人浏览过
Python 字符串属于不可变的字符序列,所有字符串方法都不会在原地修改原有字符串,而是计算并返回一个全新的字符串对象。为了便于快速定位和高效开发,本文将 Python 字符串(
str)最核心的内置方法与关联内置函数整理为查找统计、清洗变换、分割合并、验证判断及全局操作五大类别,并附带执行机制图解与速查表格。
一、字符串底层核心特征:不可变性(Immutability)
理解 Python 字符串方法的前提是认识其内存模型。在 Python 中,字符串是不可变对象(Immutable)。一旦字符串在内存中分配,其内部字符就无法被覆写、追加或截短。诸如 replace()、strip() 或 lower() 等方法,表面上看起来改变了字符串,实质上是在内存中开辟新空间并返回新对象的引用。
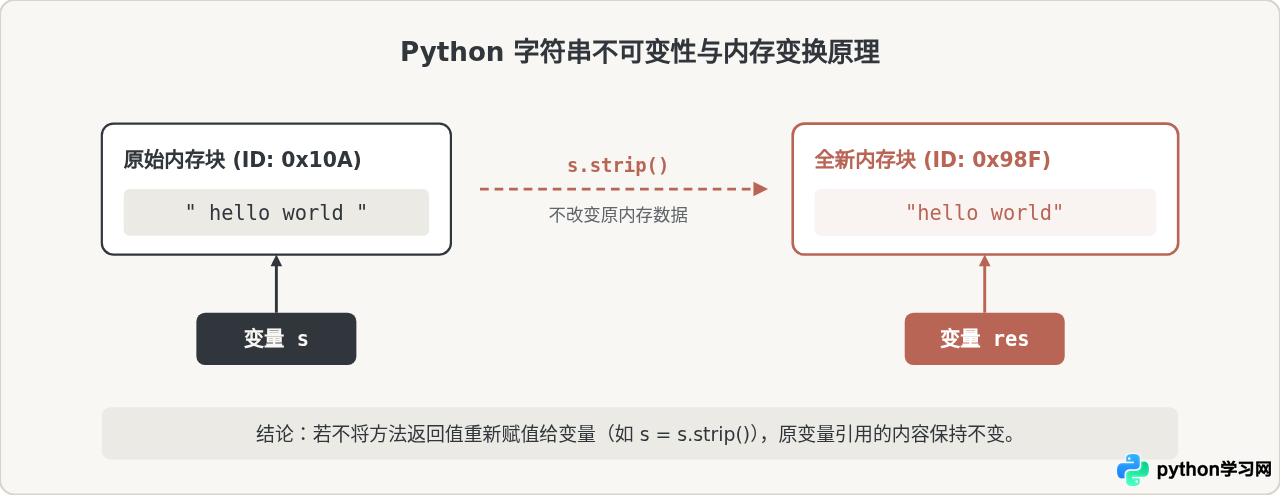
在日常编写代码时,初学者常见的疏漏就是直接执行 text.strip() 却未接收返回值,导致后续逻辑中字符串仍然包含原有头尾空格。以下代码明确说明了这一机制:
raw_text = "  Pythonic String  "
# 错误做法:未接收返回值
raw_text.strip()
print("直接调用后:", repr(raw_text))

# 正确做法:变量接收新字符串对象
clean_text = raw_text.strip()
print("接收返回值:", repr(clean_text))
直接调用后: ' Pythonic String '
接收返回值: 'Pythonic String'
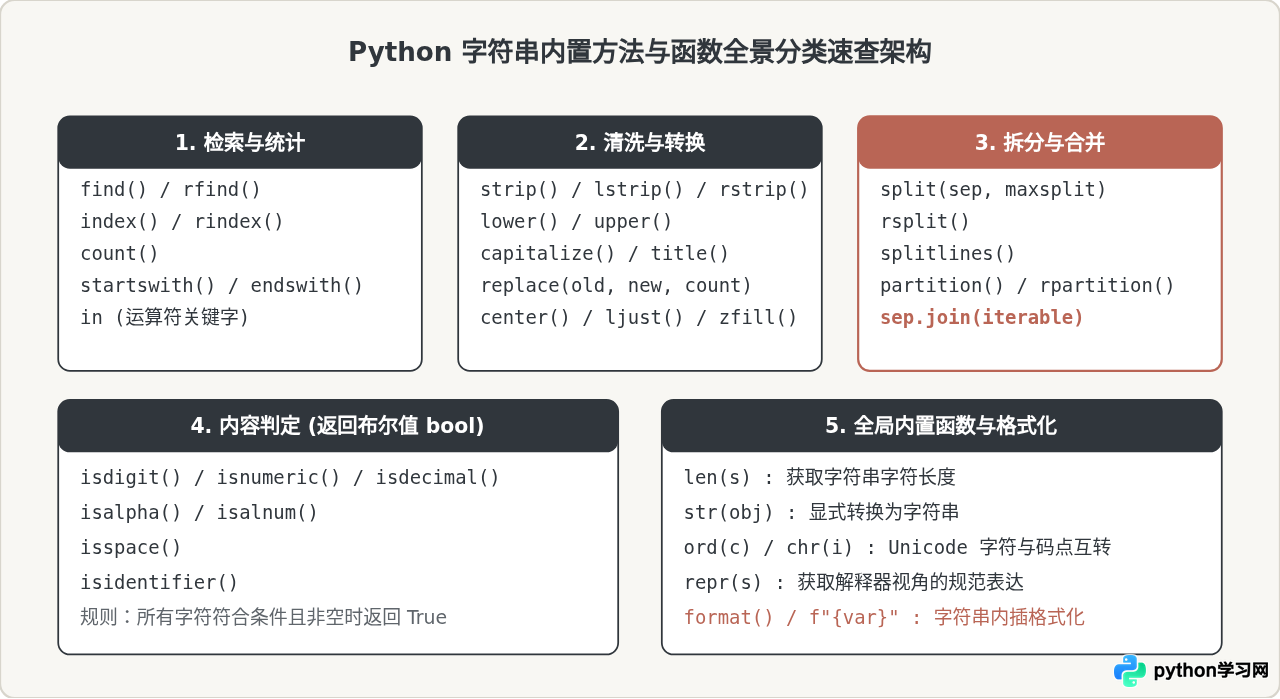
二、字符串分类速查全景图
根据处理目标的不同,Python 的内置字符串方法可以清晰划分为以下五大核心领域:
三、核心方法与函数详细剖析
1. 检索与统计:find、index 与 startswith
判断子串是否存在、获取索引位置或统计频次是最高频的操作。需要特别注意 find() 与 index() 在未找到目标时的不同行为:
str.find(sub[, start[, end]]):返回子串首次出现的最小索引;若子串不存在,返回-1。该方法适合用于条件判断。str.index(sub[, start[, end]]):同find(),但在找不到子串时直接抛出ValueError异常。适合在必须保证子串存在或通过异常处理控制流程的场景。str.startswith(prefix)与str.endswith(suffix):支持传入元组进行多模式匹配,例如s.startswith(("http://", "https://"))。
sentence = "config_production_v2.yaml"

# 检查前缀与后缀(支持元组作为参数)
is_yaml = sentence.endswith((".yaml", ".yml"))  # True

# find 与 index 对比
pos_prod = sentence.find("production")  # 7
pos_none = sentence.find("test")        # -1(安全返回)

print("is_yaml:", is_yaml, "| find('test'):", pos_none)
is_yaml: True | find('test'): -1
2. 分割、合并与分区:split、join 与 partition
字符串与列表等序列容器之间的相互转换,依赖于分割与合并。这是文本结构化处理的枢纽环节。
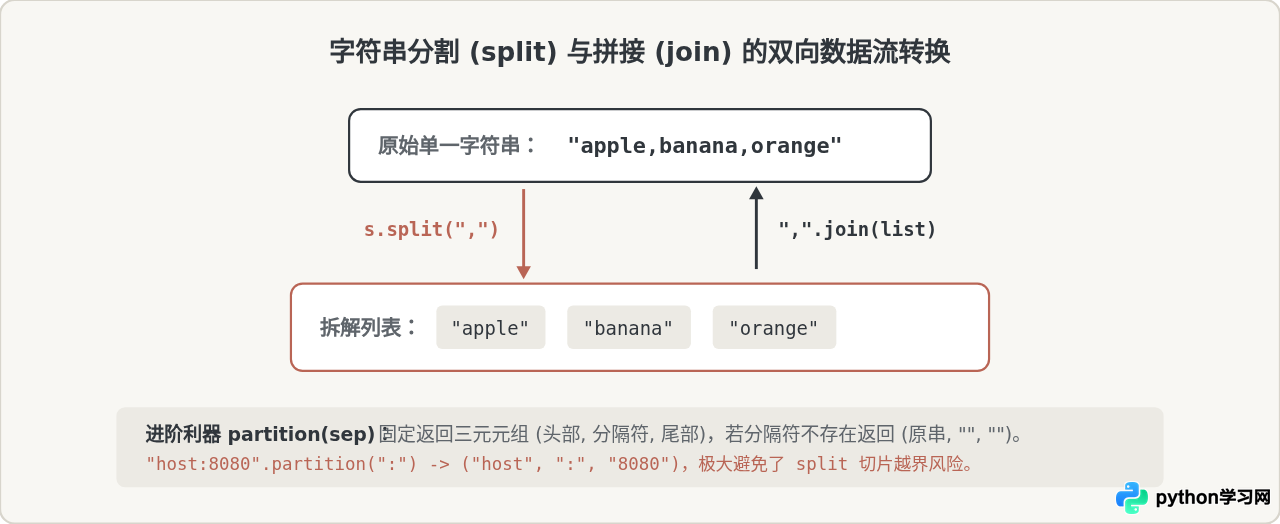
这里有两个非常关键但常被混淆的技术点:
split()不传参数 vssplit(" "):不传参数时,Python 会将连续的任意空白字符(空格、制表符\t、换行符\n)作为一个整体切分,并自动过滤掉首尾的空白项;而split(" ")只切分单个空格,连续空格会产生大量空字符串""项。- 字符串拼接性能:在循环体中大量使用
+操作拼接字符串会导致频繁的内存重新分配(因为字符串不可变)。规范的做法是先将分段推入列表,最后统一调用"".join(str_list)。
# 空白切分对比
sample = " Python   Ruby \t Go \n Rust "
print("默认 split():", sample.split())
print("split(' '):", sample.split(" "))

# 安全解析键值对
header = "Content-Type: application/json"
key, sep, val = header.partition(":")
print("Key:", key.strip(), "| Val:", val.strip())
默认 split(): ['Python', 'Ruby', 'Go', 'Rust']
split(' '): ['', 'Python', '', '', 'Ruby', '\t', 'Go', '\n', 'Rust', '']
Key: Content-Type | Val: application/json
3. 内容判断与验证:字符类型检测
在校验用户输入或文本清洗阶段,我们常使用以 is 开头的一组判断方法。这些方法在全部字符满足条件且长度大于 0 时返回 True:
isdigit()、isdecimal()与isnumeric():这三者范围递增。isdecimal()仅匹配纯十进制数字(0-9);isdigit()还包含单字数字(如角标 ²);isnumeric()则进一步包含汉字数字(如“一二三”、“肆”)及罗马数字。isalnum():所有字符都是字母或数字时返回True。isspace():字符串仅由空白字符组成时返回True。isidentifier():判断字符串是否符合 Python 标识符命名规则(可用于动态变量名校验)。
四、内置函数与字符串方法的分类速查表
下表汇集了日常开发中出现频次最高的方法与函数,便于快速查阅:
| 类别 | 方法 / 函数调用 | 返回值类型 | 核心说明与典型场景 |
|---|---|---|---|
| 检索统计 | s.find(sub) |
int |
返回首次出现索引,不存在返回 -1 |
s.index(sub) |
int |
返回首次出现索引,不存在抛 ValueError | |
s.count(sub) |
int |
统计子串在范围内的非重叠出现次数 | |
s.startswith(prefix) |
bool |
检测前缀,支持传入 tuple 进行多项检测 | |
| 清洗转换 | s.strip([chars]) |
str |
移除首尾指定字符集(默认移除空白) |
s.lower() / s.upper() |
str |
转换为全小写 / 全大写 | |
s.replace(old, new, [n]) |
str |
替换指定内容,可选最大替换次数 | |
s.zfill(width) |
str |
左侧补 0 对齐指定位数(如生成编号) | |
| 拆分合并 | s.split([sep, maxsplit]) |
list[str] |
按分隔符切片为列表;默认处理空白 |
sep.join(iterable) |
str |
用指定分隔符连接字符串可迭代对象 | |
s.partition(sep) |
tuple[str, str, str] |
三段式拆分为 (左, 分隔符, 右) | |
| 判断验证 | s.isdigit() |
bool |
检测是否仅包含数字字符 |
s.isalpha() |
bool |
检测是否仅包含字母(包含中文等字符) | |
s.isspace() |
bool |
检测是否由纯空白符构成 | |
| 全局函数 | len(s) |
int |
返回字符串字符个数(基于 Unicode 码点) |
str(obj) |
str |
调用对象的 __str__ 返回人类可读形式 | |
ord(c) / chr(i) |
int / str |
单个字符与对应 Unicode 整数码点互转 |
五、综合实战:文本清洗与解析流水线
在实际生产环境中,单个字符串方法很少孤立使用,通常会按清洗、标准化、验证与拆分的次序组合成处理流水线。
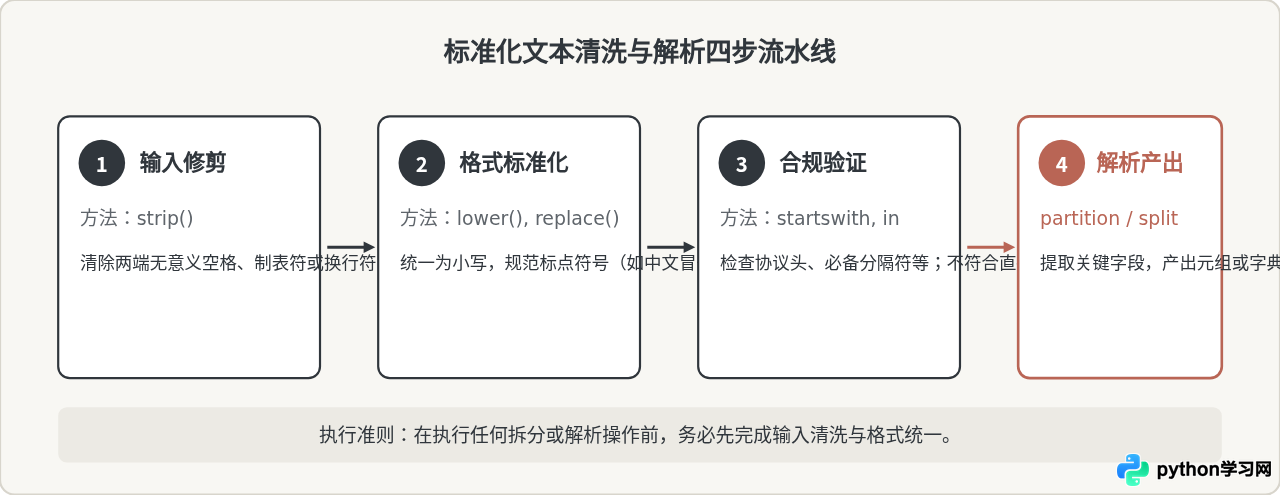
下面是一个符合该流水线的清洗函数示例,展示如何用最基础的方法构建健壮的数据解析逻辑:
def parse_user_record(raw_line: str) -> dict | None:
    # 步骤 1: 修剪空白
    line = raw_line.strip()
    if not line or line.startswith("#"):
        return None  # 跳过空行与注释行

    # 步骤 2: 格式清洗与替换(统一中文全角逗号)
    line = line.replace(",", ",")

    # 步骤 3: 边界验证
    if ":" not in line:
        return None

    # 步骤 4: 结构化拆分
    username, _, details = line.partition(":")
    fields = [item.strip() for item in details.split(",") if item.strip()]

    return {
        "user": username.strip().lower(),
        "tags": fields
    }

# 测试执行
log_data = "  Admin_01 : python, Web , AI , developer  "
parsed = parse_user_record(log_data)
print("解析结果:", parsed)
解析结果: {'user': 'admin_01', 'tags': ['python', 'Web', 'AI', 'developer']}
六、开发者常见陷阱与避坑指南
strip(chars)并非匹配完整单词:s.strip("xyz")并不是去除子串"xyz",而是去除首尾所有在字符集{'x', 'y', 'z'}中的单个字符,直到遇到第一个不在该集合的字符为止。如需精确去除指定前后缀,Python 3.9+ 提供了专属方法removeprefix()和removesuffix()。- 大小写转换在不同语言下的差异:对于多语言场景(例如德语的小写字母
ß对应大写为SS),s.lower()与s.upper()可能无法正确抵消。在进行无视大小写的文本比对时,推荐使用更彻底的s.casefold()。 len()统计的是字符数而非字节数:在 Python 3 中,len("中文")的返回值为2,因为str计算的是 Unicode 字符数。如果需要计算存储或网络传输中的字节大小,必须先编码为字节串:len("中文".encode("utf-8")),返回值为6。
开发建议
在日常编写代码时,优先使用内置方法处理基础字符串逻辑。只有当规则涉及复杂的通配、递归或动态多字符提取时,才引入正则表达式(re 模块)。Python 原生字符串方法由 C 语言底层实现,具备更高的执行效率和更优的可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









