

Python通过索引下标遍历字符串的方法
全面讲解Python中通过索引下标遍历字符串的多种实用方法,包括range(len())、enumerate()内置函数、while循环控制及逆向步长遍历,分析边界保护与常见避坑指南。
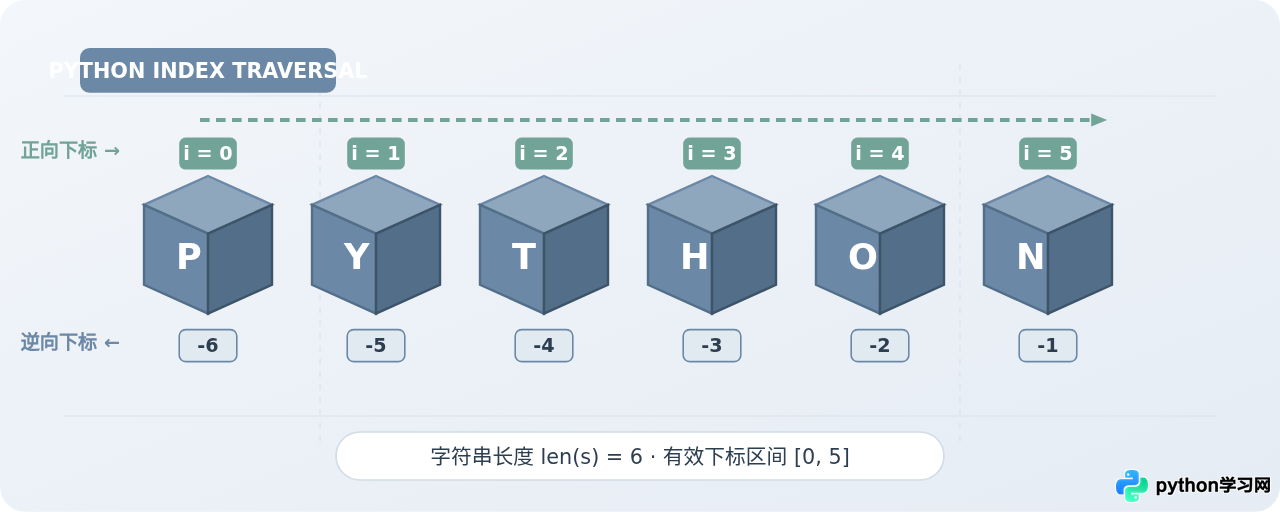
for char in s,但在需要统计字符出现位置、比较相邻字符或执行切片计算的场景下,必须获取字符对应的数值下标。本文详细介绍三种基于索引下标遍历字符串的标准方法:基于 range(len(s)) 的传统计数下标法、基于 enumerate(s) 的内置枚举解包法以及基于 while 循环的手动指针控制法,并梳理边界保护策略与最佳实践。
一、为什么需要通过索引下标遍历字符串?
Python 将字符串设计为有序、不可变的字符序列。当直接执行 for char in s 时,解释器每次从迭代器中取出下一个字符值,但完全隐藏了当前字符在序列中的物理偏移量。在实际开发中,如果遇到以下几种业务需求,就必须引入索引下标:
- 精确定位与回显:需要输出或记录目标字符具体处于第几列(例如词法分析器报错定位、高亮匹配位置)。
- 相邻字符比对:需要将当前字符
s[i]与下一个字符s[i+1]或前一个字符s[i-1]进行比较(例如连续重复字符去重、简单的行程长度压缩算法)。 - 跨步长跳跃扫描:只需要检查奇数位、偶数位,或者在匹配到特定转义符(如
\n)时需要动态后移多个字符。
二、Python 字符串索引基础与寻址模型
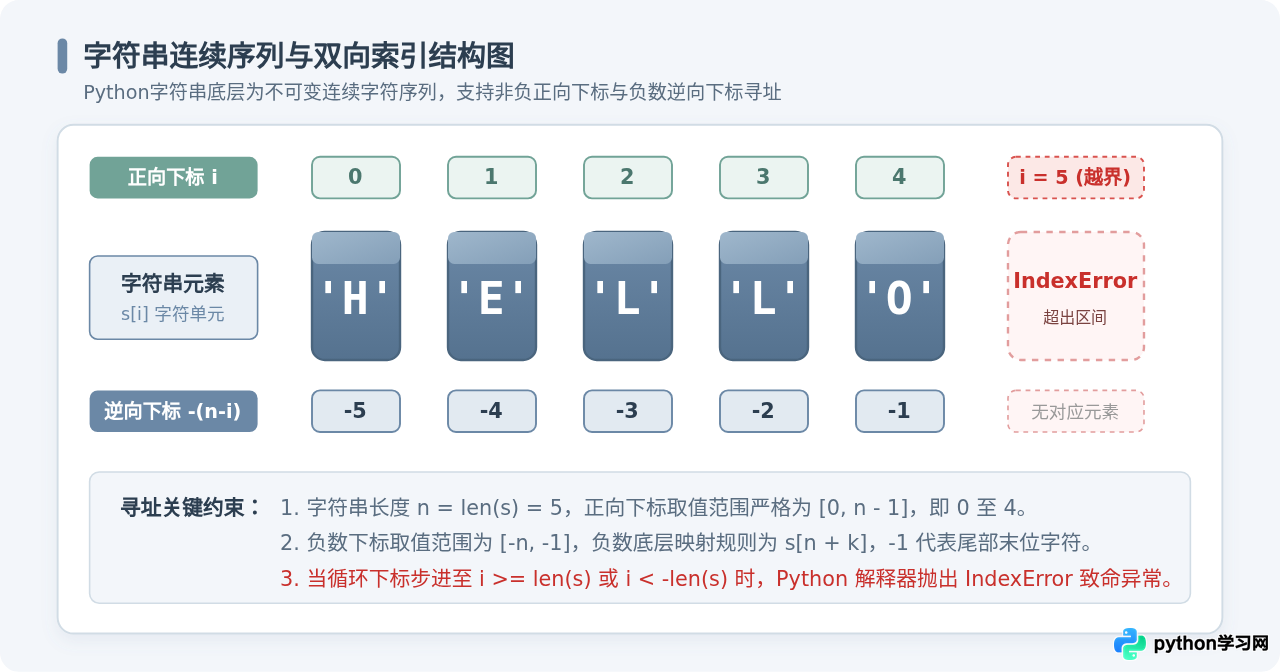
在编写遍历逻辑前,必须明确 Python 的下标规则。Python 支持两种并行的索引方式:从序列首端以 0 开始递增的正向下标,以及从序列尾端以 -1 开始递减的负向下标。
假设字符串 s = "HELLO",长度 n = len(s) = 5。正向下标的有效闭区间为 [0, 4](即 0 到 n - 1);负向下标的有效区间为 [-5, -1]。在任何情况下,访问超出上述区间的下标均会引发 IndexError: string index out of range 异常。
三、方法一:使用 range(len(s)) 传统下标遍历
这是从 C/Java 等语言过渡到 Python 时最常见的方法。其核心逻辑是:先使用内置函数 len() 获取字符串长度,再使用 range() 生成从 0 到 len(s) - 1 的连续整数序列,最后在循环体内部通过 s[i] 访问对应字符。
text = "Python"

# range(len(text)) 产生整数序列: 0, 1, 2, 3, 4, 5
for i in range(len(text)):
    char = text[i]
    print(f"下标: {i} -> 字符: {char}")
运行机制说明:len(text) 属于 O(1) 时间复杂度的操作,因为 Python 的底层对象结构内部直接存储了字符串长度字段 ob_size。但由于在每次循环时都需要执行一次方括号属性查找(text[i]),其运行开销略高于直接迭代。
text[i:i+3])或跳跃遍历。
典型应用案例:查找连续相同字符
当需要比对相邻字符时,range(len(s)) 是极其直观的方案。注意上界必须限定在 len(s) - 1,防止 i + 1 越界:
word = "bookkeeper"

# 终止条件设为 len(word) - 1,确保 i + 1 始终合法
for i in range(len(word) - 1):
    if word[i] == word[i + 1]:
        print(f"在下标 {i} 和 {i+1} 处发现重复字符: '{word[i]}'")
四、方法二:使用 enumerate() 函数(Pythonic 最佳实践)
Python 内置的 enumerate() 函数被公认为最符合 Python 风格(Pythonic)的索引遍历方式。它接受一个可迭代对象作为输入,返回一个生成器,每次循环直接产出包含 (当前下标, 当前字符) 的双元组。
text = "Python"

# 直接在 for 语句中解包下标与元素
for i, char in enumerate(text):
    print(f"下标: {i} -> 字符: {char}")
指定起始序号:start 参数
enumerate() 支持一个非常实用的可选参数 start。默认起始计数值为 0,若面向终端用户展示或需要从 1 开始计数时,无需在打印时写 i + 1,直接设置参数即可:
tasks = "ABC"

# start=1 使下标计数器从 1 开始递增
for idx, char in enumerate(tasks, start=1):
    print(f"序号 [{idx}]: {char}")
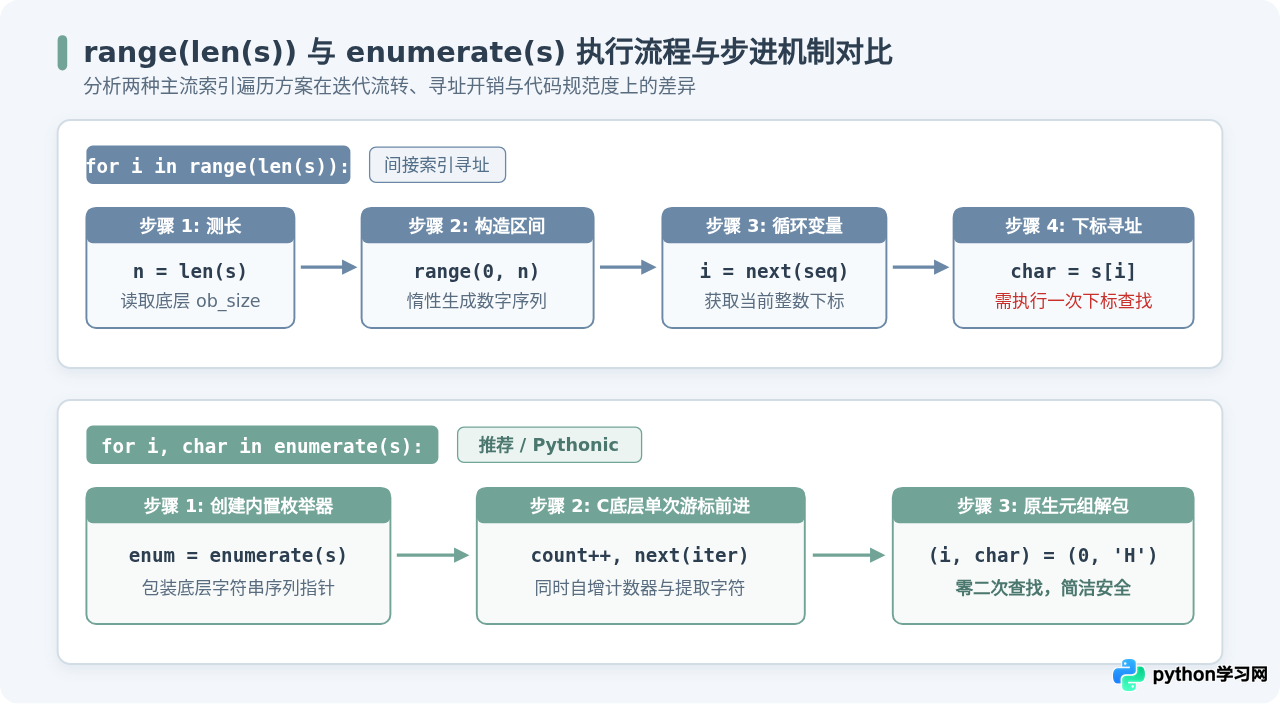
如上图所示,enumerate() 在底层由 C 实现,将索引累加与字符读取合并在一次迭代步进中完成,既规避了写 text[i] 的二次寻址指令,又避免了手动维护计数器可能出现的逻辑差错。
五、方法三:使用 while 循环手动控制指针
虽然 for 循环在多数情况下更加简洁,但在某些需要根据字符内容动态改变步长的特殊场景下,while 循环是不可或缺的工具。
text = "Python"
i = 0

# 显式判断边界条件
while i < len(text):
    print(f"下标: {i} -> 字符: {text[i]}")
    i += 1  # 必须显式递增计数器
高级场景:解析转义字符时的动态跳步
在词法解析中,当遇到转义斜杠 \ 时,通常需要将斜杠和其后一个字符合并消费,此时下标需要一次性前进 2 格:
raw_str = r"A
B	C"
i = 0
tokens = []

while i < len(raw_str):
    if raw_str[i] == "\" and i + 1 < len(raw_str):
        tokens.append(raw_str[i:i+2])
        i += 2  # 动态跨跃 2 个字符
    else:
        tokens.append(raw_str[i])
        i += 1  # 常规前进 1 个字符

print("解析得到的标记序列:", tokens)
六、逆序与带步长的下标遍历
除了常规的由前往后逐字符步进,许多算法题目与实际业务要求从后向前逆序扫描,或者每隔一个字符扫描一次。
1. 逆序下标遍历(从尾至首)
借助 range() 的第三个参数 step = -1,可以构造一个倒序递减的整数序列:
s = "DATA"
n = len(s)

# 起点: n - 1 (末位下标), 终点: -1 (不含-1,即到0结束), 步长: -1
for i in range(n - 1, -1, -1):
    print(f"倒序下标: {i} -> 字符: {s[i]}")
2. 固定步长间隔遍历
当仅需要提取偶数位字符或每隔固定步长采样时,在 range 中设定正整数步长即可:
msg = "A0B1C2D3"

# 仅遍历偶数索引: 0, 2, 4, 6
for i in range(0, len(msg), 2):
    print(f"偶数位索引 [{i}]: {msg[i]}")
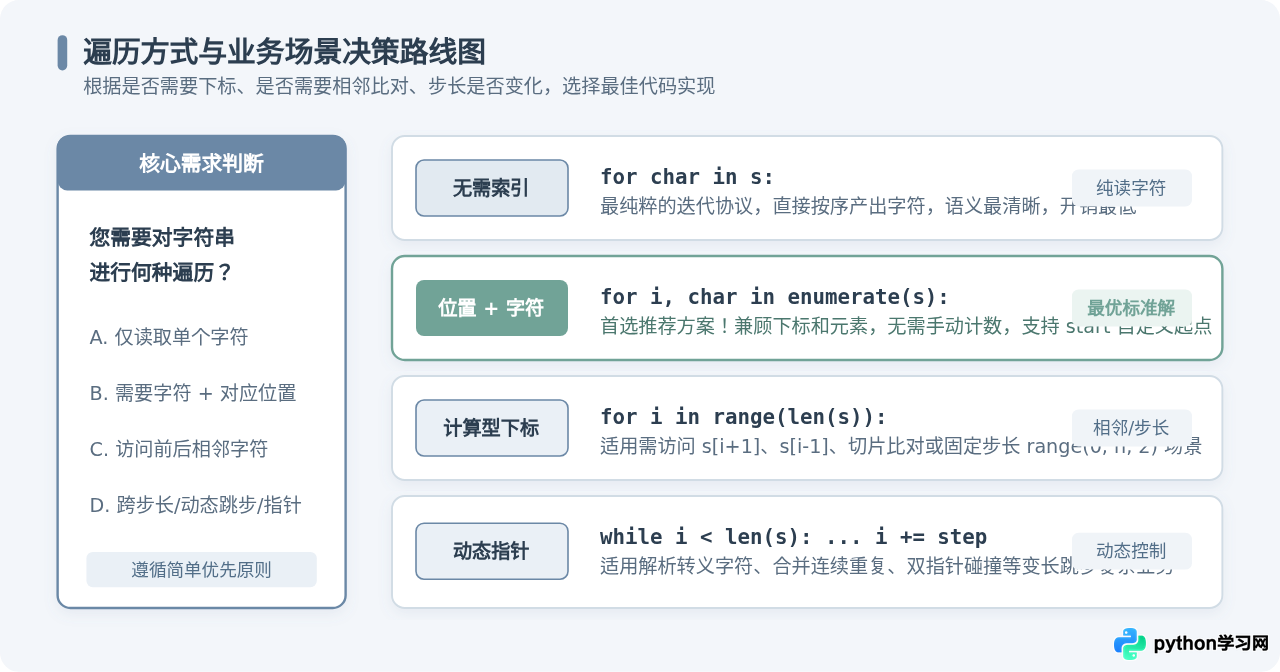
七、各种遍历方式特性与对比矩阵
为了帮助读者在不同业务场景中做出最合理的语法选择,下表对常见遍历方式的优劣势、适用情境进行了综合归纳:
| 遍历方式 | 典型代码 | 时间复杂度 | 空间复杂度 | 核心优势与适用场景 |
|---|---|---|---|---|
| 直接字符迭代 | for ch in s: |
O(n) | O(1) | 最简易直观,开销最低。仅在完全不需要字符索引序号时使用。 |
| enumerate() | for i, ch in enumerate(s): |
O(n) | O(1) | 首选推荐。无需二次寻址,自动解包,代码优雅安全。 |
| range(len()) | for i in range(len(s)): |
O(n) | O(1) | 适合相邻比对 s[i+1]、切片抓取或固定步长(逆序/隔位)扫描。 |
| while 手动控制 | while i < len(s): |
O(n) | O(1) | 控制度最高。专用于变长跳步(如转义字符解析、双指针算法)。 |
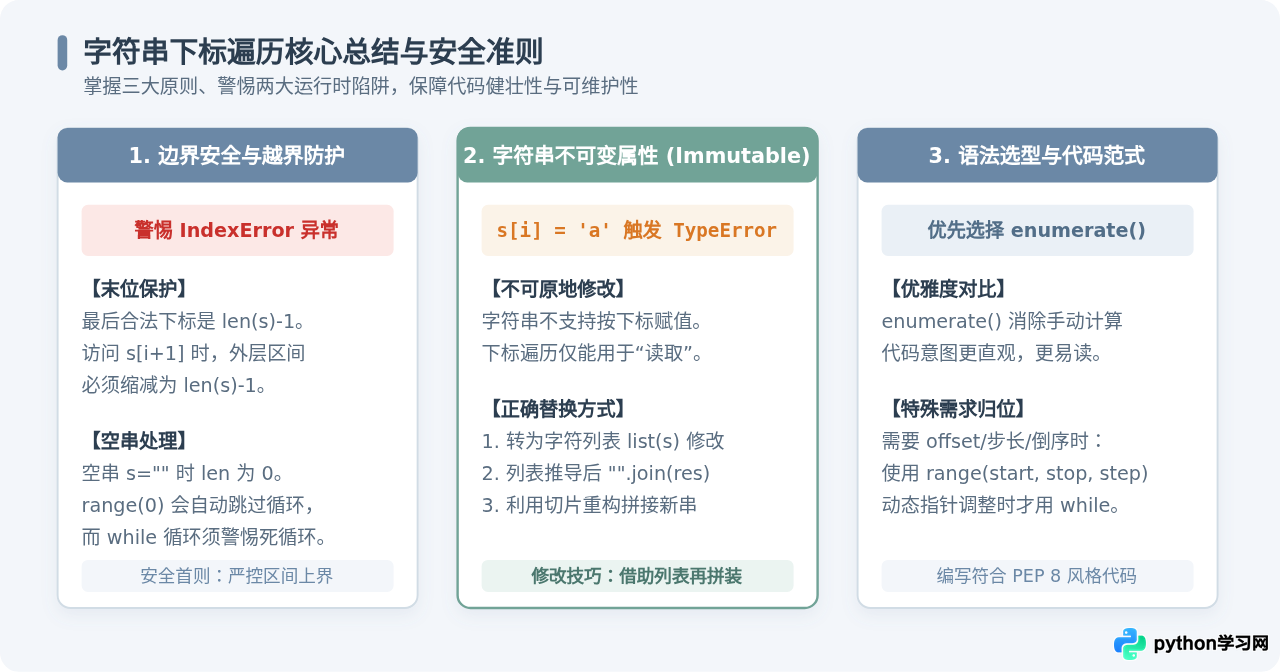
八、核心避坑指南与安全准则
当下标等于
len(s) 时立即触发越界。若循环体内部需要访问 s[i + 1],必须将外部循环范围限定在 range(len(s) - 1);若需要访问 s[i - 1],则应从 range(1, len(s)) 开始,或者增加短路保护条件:if i + 1 < len(s): ...。
许多初学者尝试执行
s[i] = 'X',这会直接抛出 TypeError: 'str' object does not support item assignment。如果需要根据下标修改字符串中的某些字符,标准做法是将字符串转换为字符列表
lst = list(s),在列表中修改元素后再通过 "".join(lst) 重新拼装为新字符串。
九、总结
掌握字符串的索引下标遍历是编写扎实 Python 逻辑的基础技能:
- 当仅需要当前元素及其位置时,优先使用
for i, char in enumerate(s),这是最安全、最符合 Python 习惯的方式。 - 当涉及数学偏移计算(如判断相邻字符、子串切片)或步长控制时,使用
range(len(s)),并务必核实上界防止IndexError。 - 当涉及解析器、双指针或变长动态步长时,使用
while循环,并时刻防范死循环与变量漏增。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









