

Python自动化办公工具开发:批量处理Excel与PDF实例
针对日常办公中分散繁琐的Excel表格汇总与PDF文档归档需求,本文基于Python标准库与核心第三方库(pandas、openpyxl、pypdf、pdfplumber),从模块化架构设计、核心清洗逻辑到CLI命令行工具开发,提供一套完整的批量处理与自动化脚本工程实践。
在日常办公与数据统计场景中,跨部门汇总数十甚至上百份 Excel 销售表、将批量 PDF 发票或账单抽取为结构化数据并添加水印归档,是耗费大量人工且极易出错的重复劳动。本文通过工程化思路,指导读者使用 Python 构建一套健壮、解耦的命令行办公自动化工具,完整覆盖文件遍历排重、多表表头校准、脏数据清洗堆叠、PDF 矢量表格抽取以及文档拼合与动态安全水印注入等全流程操作。
一、工具整体架构与分层设计
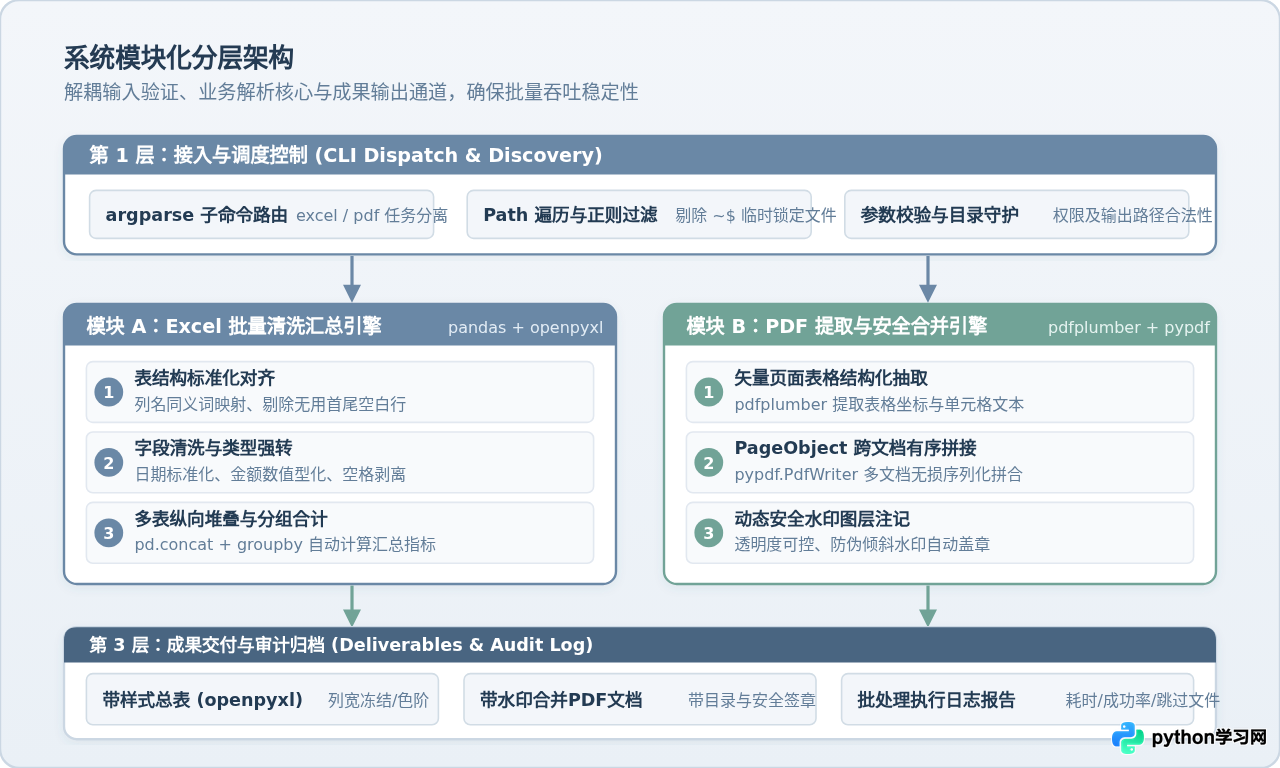
开发批处理脚本时,最忌讳将文件读取、清洗过滤、数据运算与结果写入全部揉杂在一个单体函数中。一旦单个分支报表格式变动或某个 PDF 损坏,整个脚本往往会直接崩溃退出。为了保证工具在面对成百上千份文件时的稳定吞吐与可维护性,我们采用模块化分层架构设计。
整体系统划分为四个清晰的职能层级:接入与命令行调度层负责解析用户传入的路径参数,并自动过滤临时锁文件;核心处理层分别设立专职的 Excel 清洗引擎与 PDF 解析/合并引擎;底层则由交付与审计日志模块统一承接成果落盘与运行告警记录。
这种解耦设计具备三项直观优势:
- 职责分明:Excel 处理专注于单元格数据清洗与多维汇总,PDF 模块则区分结构化内容抽取与整页拼合加盖水印两条独立链路。
- 容错隔离:单份文件损坏或字段缺失仅作为 Warning 写入审计日志并跳过当前项,不中断批处理主进程。
- 调度灵活:既支持独立调用具体模块的函数作为 Python 库使用,也可通过统一的命令行接口在终端或定时任务中一键触发。
二、依赖库选型与运行环境准备
Python 生态中处理表格与文档的库非常丰富,选型的关键在于结合业务目标厘清各库的核心长处与边界,避免功能重叠或因选型不当导致性能瓶颈。
| 库名称 | 主要定位 | 适用场景 | 局限与注意事项 |
|---|---|---|---|
| pandas | 高性能数据分析与矩阵运算 | 海量多表纵向堆叠、字段类型强转、分组求和 | 默认保存时丢失原有单元格格式、边框与配色 |
| openpyxl | Excel 格式与底层工作簿操作 | 美化终版总表、自适应列宽、冻结窗格、公式注入 | 纯逐行计算速度慢于 pandas,适合终版润色 |
| pdfplumber | 高精度矢量内容与表格抽取 | 精确提取 PDF 账单、明细表网格并转为二维结构 | 解析单页耗时较长;纯扫描图片版需先接入 OCR |
| pypdf | 页面级文档编排与流处理 | 多文档页面拼接、提取大纲、动态叠加水印层 | 侧重页面流操作,不擅长从排版中逆向解析复杂表格 |
在 Python 3.10 及以上环境的终端中,执行以下命令安装所需依赖:
pip install openpyxl==3.1.2 pandas==2.2.2 pypdf==4.2.0 pdfplumber==0.11.0三、模块一:Excel 批量汇总与数据清洗实现
在实际业务中,不同业务网点或月份上报的 Excel 表格往往存在以下常见缺陷:文件名带有个人命名习惯、表格存在空行与空格噪音、表头顺序错乱甚至存在同义词差异(例如“销售金额”与“实收金额”)。我们必须建立一条严格的流水线来保障最终汇总底表的纯净度。
1. 核心处理逻辑与关键步骤拆解
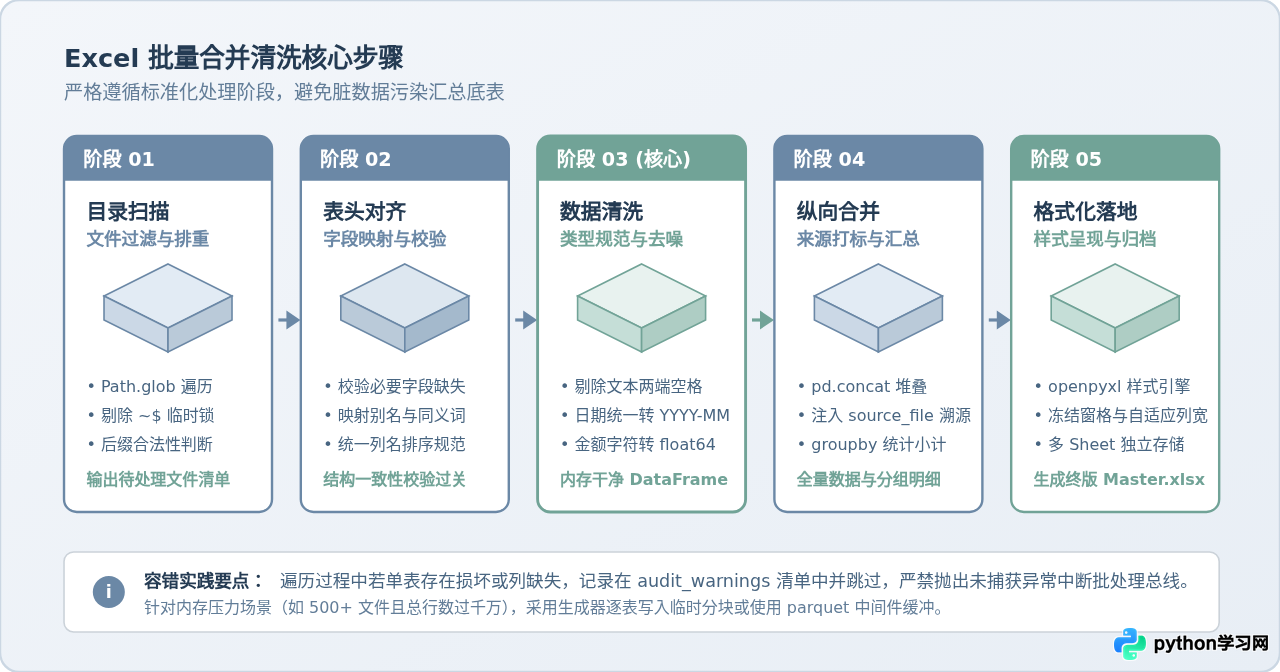
流水线按以下五个步骤严格串联执行:
- 目录扫描过滤:利用
pathlib.Path遍历指定文件夹,利用文件名特征排除包含~$的临时隐藏锁定文件。 - 表头对齐与校验:检查必要字段是否存在,将别名字段统一映射为标准列名,缺失关键主键的文件记入告警清单。
- 数据清洗规范化:去除字符串两端不可见的空格,将日期字段强制解析为标准
YYYY-MM-DD格式,将金额字段剔除逗号符号并转为浮点数。 - 纵向合并与溯源标记:使用
pd.concat将各分支 DataFrame 纵向堆叠,并在首列注入source_file记录原始文件名,便于审计溯源。 - 多维度汇总与样式落地:利用 openpyxl 为汇总表设置专业表头底色、固定首行冻结并根据内容长度自动计算列宽。
2. 完整 Python 代码实现
以下为模块一的完整 Python 代码实现,内嵌异常处理与进度日志:
# -*- coding: utf-8 -*-
from pathlib import Path
import logging
import pandas as pd
from openpyxl import load_workbook
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side
from openpyxl.utils import get_column_letter

# 配置模块日志
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("ExcelBatchProcessor")

# 期望的标准列名字典(支持同义词别名映射)
COLUMN_MAPPING = {
    "订单编号": "order_id",
    "销售单号": "order_id",
    "日期": "order_date",
    "下单时间": "order_date",
    "网点名称": "branch_name",
    "分公司": "branch_name",
    "销售额": "sales_amount",
    "实收金额": "sales_amount",
    "客户备注": "remarks"
}
REQUIRED_COLUMNS = {"order_id", "order_date", "branch_name", "sales_amount"}

def process_single_excel(file_path: Path) -> pd.DataFrame:
    """读取并清洗单个 Excel 文件"""
    try:
        # 读取首个工作表,忽略前后空行
        df = pd.read_excel(file_path, sheet_name=0, engine="openpyxl")
    except Exception as e:
        logger.warning(f"无法读取文件 {file_path.name}: {e}")
        return pd.DataFrame()

    # 1. 列名同义词映射与标准化
    clean_columns = {}
    for col in df.columns:
        col_str = str(col).strip()
        if col_str in COLUMN_MAPPING:
            clean_columns[col] = COLUMN_MAPPING[col_str]
    df = df.rename(columns=clean_columns)

    # 2. 校验必要字段完整性
    present_cols = set(df.columns)
    if not REQUIRED_COLUMNS.issubset(present_cols):
        missing = REQUIRED_COLUMNS - present_cols
        logger.warning(f"跳过文件 {file_path.name}: 缺少关键字段 {missing}")
        return pd.DataFrame()

    # 3. 字段清洗与类型转换
    # 过滤核心字段全为空的脏行
    df = df.dropna(subset=["order_id", "sales_amount"]).copy()

    # 字符串两端剥离空格
    for col in ["order_id", "branch_name"]:
        df[col] = df[col].astype(str).str.strip()

    # 日期强转
    df["order_date"] = pd.to_datetime(df["order_date"], errors="coerce").dt.strftime("%Y-%m-%d")

    # 金额清洗(清除千分位逗号并转为数值)
    if df["sales_amount"].dtype == object:
        df["sales_amount"] = (
            df["sales_amount"].astype(str)
            .str.replace(",", "", regex=False)
            .str.replace("¥", "", regex=False)
            .str.strip()
        )
    df["sales_amount"] = pd.to_numeric(df["sales_amount"], errors="coerce").fillna(0.0)

    # 4. 添加溯源列
    df.insert(0, "source_file", file_path.name)
    return df

def apply_excel_styling(excel_path: Path):
    """使用 openpyxl 对合并结果表进行样式润色"""
    wb = load_workbook(excel_path)
    header_fill = PatternFill(start_color="6B88A6", end_color="6B88A6", fill_type="solid")
    header_font = Font(name="Microsoft YaHei", size=11, bold=True, color="FFFFFF")
    cell_font = Font(name="Microsoft YaHei", size=10)
    thin_border = Border(
        left=Side(style="thin", color="DCE5ED"),
        right=Side(style="thin", color="DCE5ED"),
        top=Side(style="thin", color="DCE5ED"),
        bottom=Side(style="thin", color="DCE5ED")
    )

    for sheet_name in wb.sheetnames:
        ws = wb[sheet_name]
        ws.views.sheetView[0].showGridLines = True
        ws.freeze_panes = "A2"  # 冻结第一行表头

        # 格式化表头
        for col_idx in range(1, ws.max_column + 1):
            cell = ws.cell(row=1, column=col_idx)
            cell.fill = header_fill
            cell.font = header_font
            cell.alignment = Alignment(horizontal="center", vertical="center")
            cell.border = thin_border

        # 遍历数据行设置字体与边框,自适应列宽
        for col_idx in range(1, ws.max_column + 1):
            max_len = 0
            col_letter = get_column_letter(col_idx)
            for row_idx in range(2, ws.max_row + 1):
                cell = ws.cell(row=row_idx, column=col_idx)
                cell.font = cell_font
                cell.border = thin_border
                val_str = str(cell.value or "")
                # 中文字符长度补偿
                str_len = sum(2 if ord(c) > 127 else 1 for c in val_str)
                if str_len > max_len:
                    max_len = str_len
            ws.column_dimensions[col_letter].width = max(max_len + 4, 12)

    wb.save(excel_path)
    logger.info(f"样式渲染完成并成功保存至 {excel_path}")

def batch_merge_excel(input_dir: str, output_file: str):
    """批量汇总指定目录下的全部 Excel"""
    in_path = Path(input_dir)
    out_path = Path(output_file)
    out_path.parent.mkdir(parents=True, exist_ok=True)

    # 扫描并剔除 ~$ 开头的临时锁定文件
    excel_files = [
        f for f in in_path.glob("*.xlsx")
        if not f.name.startswith("~$")
    ]
    logger.info(f"在目录 {input_dir} 中检索到 {len(excel_files)} 个待处理 Excel 文件")

    if not excel_files:
        logger.warning("未检索到有效文件,程序终止。")
        return

    dfs = []
    for file in excel_files:
        df_single = process_single_excel(file)
        if not df_single.empty:
            dfs.append(df_single)

    if not dfs:
        logger.error("所有 Excel 文件的内容均为空或校验不合格。")
        return

    # 全量合并
    master_df = pd.concat(dfs, ignore_index=True)

    # 生成业务汇总统计表(按网点聚合销售总额与订单数)
    summary_df = (
        master_df.groupby("branch_name")
        .agg(
            总销售额=("sales_amount", "sum"),
            总订单数=("order_id", "count"),
            平均客单价=("sales_amount", "mean")
        )
        .reset_index()
    )

    # 写入多工作表
    with pd.ExcelWriter(out_path, engine="openpyxl") as writer:
        master_df.to_excel(writer, sheet_name="合并原始明细", index=False)
        summary_df.to_excel(writer, sheet_name="网点统计汇总", index=False)

    # 应用样式格式化
    apply_excel_styling(out_path)
logger.info(f"批量合并完成,共计整合 {len(master_df)} 条明细。")四、模块二:PDF 表格批量提取与合并加水印实现
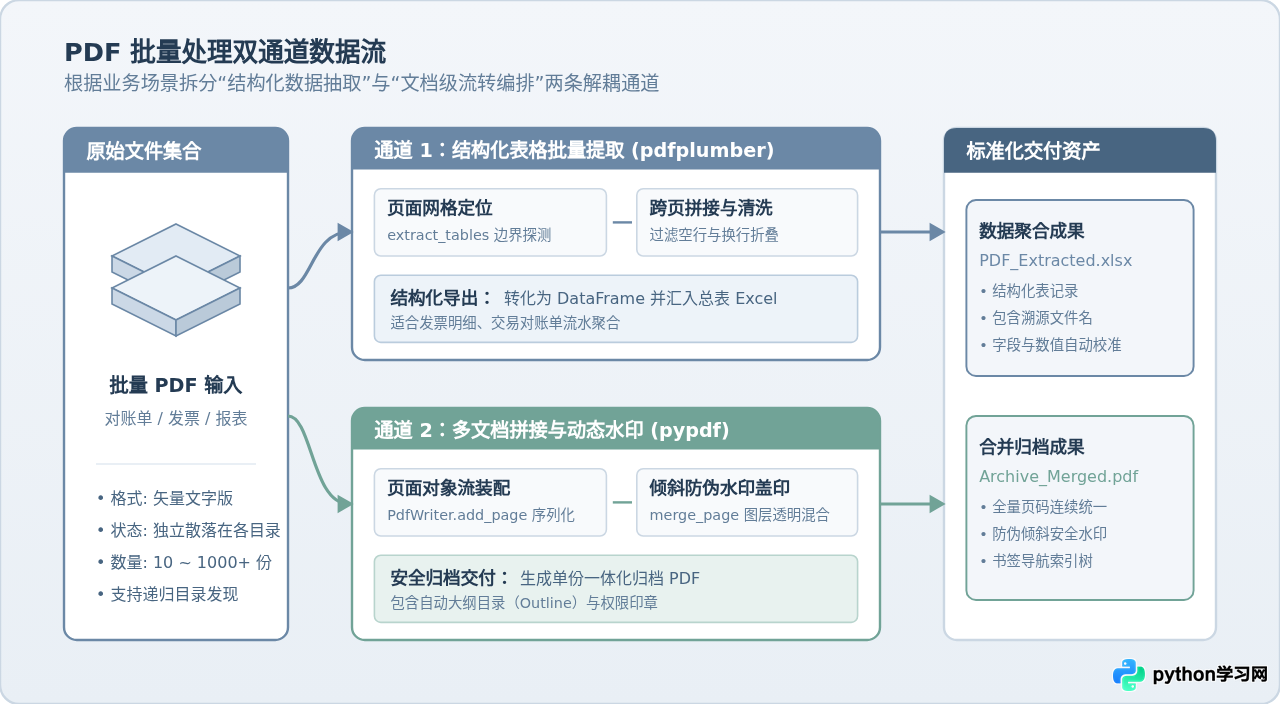
在处理 PDF 文档时,业务诉求通常呈现两极化:一种是将 PDF 内嵌的结构化明细表抽取还原为可计算的数据资产(如财务账单流水汇总);另一种则是将多个独立 PDF 文档拼合成单份正式归档卷宗,并批量压印公司保密水印。针对这两种场景,我们分别调用 pdfplumber 与 pypdf 构建双通道流。
1. 结构化表格提取通道原理
很多业务对账单虽为 PDF 格式,但实质为软件导出的矢量文档。pdfplumber 能够精准获取页面上的线段(lines)、矩形(rects)和字符边界(chars)。调用 page.extract_tables() 可自动识别表格内网格并输出嵌套列表结构。程序将每个子 PDF 中提取出的二维矩阵转换为标准 DataFrame,并打上来源文件名标签,汇总输出为一份可直接复核的 Excel 文件。
2. 多文档合并与动态安全水印通道
在归档场景中,直接合并往往面临未标注版权和文件过长的混乱局面。我们使用 pypdf.PdfWriter 顺序接入各文档的 PageObject,并使用轻量级动态画布生成倾斜 45 度的半透明安全水印,通过 page.merge_page() 逐页复合叠加,实现低内存开销的高速批量文档装配。
3. 完整 Python 代码实现
# -*- coding: utf-8 -*-
from pathlib import Path
import io
import logging
import pdfplumber
import pandas as pd
from pypdf import PdfReader, PdfWriter
from pypdf._page import PageObject

logger = logging.getLogger("PDFBatchProcessor")

def extract_tables_from_pdfs(input_dir: str, output_excel: str):
    """批量提取指定目录下全部 PDF 中的表格并汇总导出为 Excel"""
    in_path = Path(input_dir)
    pdf_files = sorted(list(in_path.glob("*.pdf")))
    logger.info(f"开始扫描 PDF 表格,检测到 {len(pdf_files)} 份文档")

    all_records = []
    for pdf_path in pdf_files:
        try:
            with pdfplumber.open(pdf_path) as pdf:
                for page_idx, page in enumerate(pdf.pages, start=1):
                    # 抽取当前页面的全部表格
                    tables = page.extract_tables()
                    for t_idx, table in enumerate(tables):
                        if not table or len(table) < 2:
                            continue  # 忽略空表或仅有表头的单行

                        # 假定首行为表头
                        headers = [str(c).replace("\n", " ").strip() if c else f"col_{i}" for i, c in enumerate(table[0])]
                        for row in table[1:]:
                            clean_row = [str(c).replace("\n", " ").strip() if c else "" for c in row]
                            # 过滤全空无效行
                            if not any(clean_row):
                                continue
                            record = dict(zip(headers, clean_row))
                            record["_source_file"] = pdf_path.name
                            record["_page_no"] = page_idx
                            all_records.append(record)
        except Exception as e:
            logger.error(f"处理 PDF {pdf_path.name} 表格提取异常: {e}")

    if all_records:
        df_pdf = pd.DataFrame(all_records)
        df_pdf.to_excel(output_excel, index=False, engine="openpyxl")
        logger.info(f"PDF 表格提取完毕,共抽取 {len(df_pdf)} 行结构化数据并导出至 {output_excel}")
    else:
        logger.warning("未在目标 PDF 中检测到有效表格数据。")

def create_simple_watermark_page(watermark_text: str, width: float, height: float) -> PageObject:
    """
    使用纯 PostScript/PDF 基础流动态构建单页水印对象(无需 reportlab 外部依赖)
    """
    pdf_stream = (
        f"%PDF-1.4\n"
        f"1 0 obj << /Type /Catalog /Pages 2 0 R >> endobj\n"
        f"2 0 obj << /Type /Pages /Kids [3 0 R] /Count 1 >> endobj\n"
        f"3 0 obj << /Type /Page /Parent 2 0 R /MediaBox [0 0 {width} {height}] /Contents 4 0 R /Resources << /Font << /F1 5 0 R >> >> >> endobj\n"
        f"4 0 obj << /Length 120 >> stream\n"
        f"q\n"
        f"0.75 0.75 0.75 rg\n"
        f"BT\n"
        f"/F1 32 Tf\n"
        f"1 0 0 1 100 100 Tm\n"
        f"({watermark_text}) Tj\n"
        f"ET\n"
        f"Q\n"
        f"endstream\n"
        f"endobj\n"
        f"5 0 obj << /Type /Font /Subtype /Type1 /BaseFont /Helvetica >> endobj\n"
        f"xref\n"
        f"0 6\n"
        f"0000000000 65535 f \n"
        f"0000000009 00000 n \n"
        f"0000000056 00000 n \n"
        f"0000000111 00000 n \n"
        f"0000000215 00000 n \n"
        f"0000000385 00000 n \n"
        f"trailer << /Size 6 /Root 1 0 R >>\n"
        f"startxref\n"
        f"455\n"
        f"%%EOF"
    ).encode("latin1")

    reader = PdfReader(io.BytesIO(pdf_stream))
    return reader.pages[0]

def batch_merge_pdfs_with_watermark(input_dir: str, output_pdf: str, watermark_text: str = "CONFIDENTIAL ARCHIVE"):
    """批量拼接多份 PDF 文档并逐页叠加半透明安全水印"""
    in_path = Path(input_dir)
    pdf_files = sorted(list(in_path.glob("*.pdf")))
    logger.info(f"开始执行 PDF 归档拼接,待合并文档数: {len(pdf_files)}")

    writer = PdfWriter()
    total_pages = 0

    for pdf_path in pdf_files:
        try:
            reader = PdfReader(str(pdf_path))
            doc_page_count = len(reader.pages)
            if doc_page_count == 0:
                continue

            # 为每个独立文档创建大纲书签
            bookmark_title = pdf_path.stem
            writer.add_outline_item(bookmark_title, total_pages)

            for page in reader.pages:
                # 获取当前页真实尺寸以适配水印画布
                p_width = float(page.mediabox.width)
                p_height = float(page.mediabox.height)

                # 生成水印并进行图层合并
                wm_page = create_simple_watermark_page(watermark_text, p_width, p_height)
                page.merge_page(wm_page)

                writer.add_page(page)
                total_pages += 1

        except Exception as e:
            logger.error(f"合并文档 {pdf_path.name} 失败: {e}")

    out_file = Path(output_pdf)
    out_file.parent.mkdir(parents=True, exist_ok=True)
    with open(out_file, "wb") as f:
        writer.write(f)

logger.info(f"PDF 归档完毕!合并总页数: {total_pages},保存至 {output_pdf}")五、模块三:整合为企业级 CLI 命令行自动化工具
为了让上述脚本能够脱离开发环境直接嵌入日常工作流、交由非技术人员运行或由 Jenkins/Cron 定时触发,我们使用 Python 标准库 argparse 封装统一的命令行工具 office_tool.py,支持清晰的二级子命令路由机制。
1. 命令行参数体系设计
excel-merge:执行 Excel 批量清洗汇总任务。--input-dir(或-i):待汇总的 Excel 源文件目录。--output-file(或-o):最终汇总工作簿的输出绝对或相对路径。
pdf-process:执行 PDF 批量抽取与归档任务。--input-dir(或-i):待处理的 PDF 源目录。--mode(或-m):处理模式,可选extract(提取表格)或merge(合并加水印)。--output-file(或-o):输出文件路径。--watermark(或-w):水印文本(默认 "CONFIDENTIAL")。
2. 统一调度脚本 office_tool.py 实现
# -*- coding: utf-8 -*-
"""
Python 自动化办公工具命令行主入口
"""
import argparse
import sys
import logging
from pathlib import Path

# 配置全局控制台日志格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger("OfficeTool")

def main():
    parser = argparse.ArgumentParser(
        prog="office_tool",
        description="企业级办公自动化批处理工具(支持 Excel 汇总清洗与 PDF 提取/合并水印)"
    )
    subparsers = parser.add_subparsers(dest="command", help="选择待执行的子命令")

    # 子命令 1: excel-merge
    parser_excel = subparsers.add_parser("excel-merge", help="批量汇总并清洗多个 Excel 报表")
    parser_excel.add_argument("-i", "--input-dir", required=True, help="存放源 Excel 文件的目录路径")
    parser_excel.add_argument("-o", "--output-file", default="Merged_Master.xlsx", help="输出汇总文件路径")

    # 子命令 2: pdf-process
    parser_pdf = subparsers.add_parser("pdf-process", help="批量处理 PDF 文档(表格提取或合并加水印)")
    parser_pdf.add_argument("-i", "--input-dir", required=True, help="存放源 PDF 文件的目录路径")
    parser_pdf.add_argument("-m", "--mode", choices=["extract", "merge"], required=True, help="处理模式:extract 提取表格或 merge 合并水印")
    parser_pdf.add_argument("-o", "--output-file", required=True, help="输出文件保存路径")
    parser_pdf.add_argument("-w", "--watermark", default="INTERNAL ONLY", help="安全水印文字内容")

    args = parser.parse_args()

    if not args.command:
        parser.print_help()
        sys.exit(1)

    in_dir = Path(args.input_dir)
    if not in_dir.exists() or not in_dir.is_dir():
        logger.error(f"输入路径不存在或不是有效目录: {args.input_dir}")
        sys.exit(2)

    logger.info(f"收到指令: {args.command},正在启动批处理作业...")

    if args.command == "excel-merge":
        # 调用模块一批量汇总
        batch_merge_excel(str(in_dir), args.output_file)
    elif args.command == "pdf-process":
        if args.mode == "extract":
            # 调用模块二表格抽取
            extract_tables_from_pdfs(str(in_dir), args.output_file)
        elif args.mode == "merge":
            # 调用模块二合并加水印
            batch_merge_pdfs_with_watermark(str(in_dir), args.output_file, args.watermark)

    logger.info("任务调度执行完毕。")

if __name__ == "__main__":
    main()
在实际生产中,我们可以直接通过标准命令行指令运行该工具:
# 1. 批量合并指定网点销售报表
python office_tool.py excel-merge -i ./reports/2026Q1 -o ./dist/Master_2026Q1.xlsx

# 2. 批量合并 PDF 并加盖安全水印
python office_tool.py pdf-process -i ./contracts -m merge -o ./dist/All_Contracts.pdf -w "AUDITED-2026"
六、异常排查、避坑指南与最佳实践
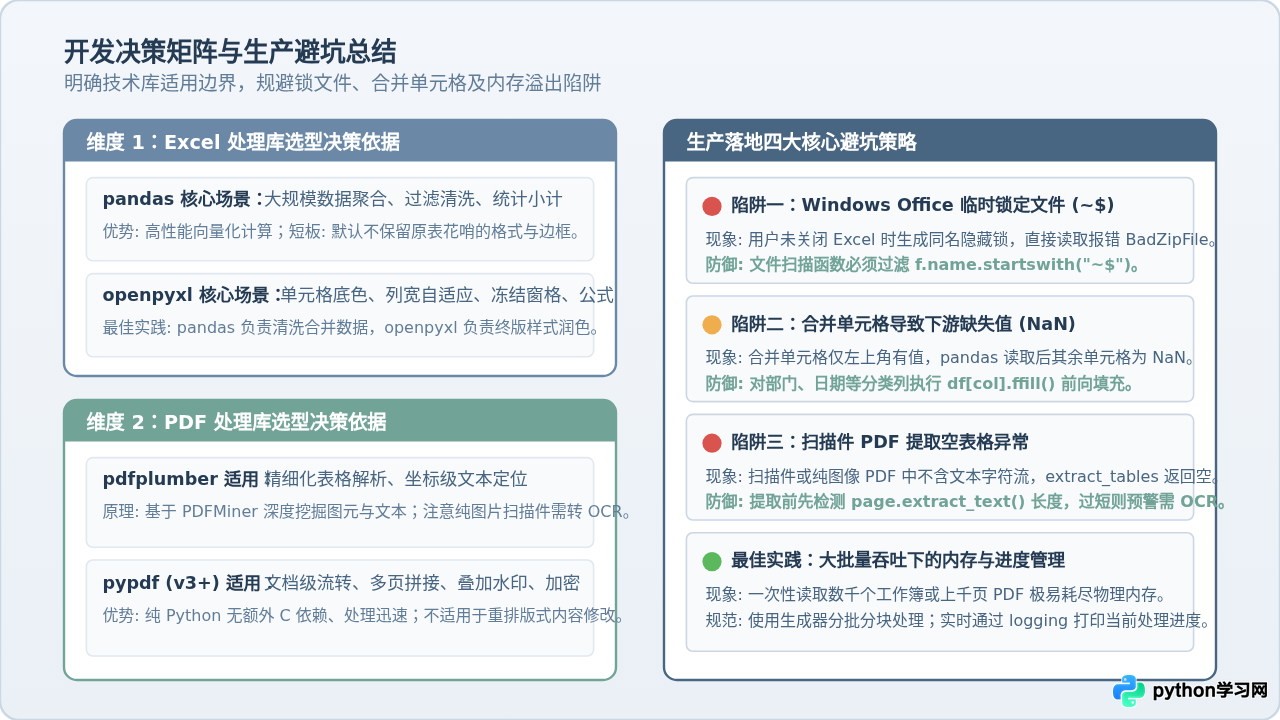
批处理脚本在实验室环境运行顺畅,但在真实生产环境中面对复杂多变的文件输入时,极容易遭遇由于系统锁定、排版异常或资源耗尽引发的运行故障。本节总结四大高发生产缺陷及对应的确定性防范方案。
1. Windows 临时锁定文件规避
当办公人员使用 Microsoft Excel 打开某个 Sales.xlsx 时,操作系统会在同目录下自动生成隐藏文件 ~$Sales.xlsx。由于该文件并非完整的 zip 压缩包,如果直接使用 pandas 读取,会立即触发 BadZipFile: File is not a zip file 异常。所有文件扫描逻辑中必须通过 not file.name.startswith("~$") 进行硬性前置过滤。
2. 合并单元格与空值断裂处理
业务人员上报的表格中常出现合并单元格(如同一部门下的多条人员记录)。Excel 底层仅在合并区域的左上角首个单元格保留数值,其余单元格均为空(NaN)。若直接使用 groupby 或过滤,会导致除第一行外的记录全部丢失归属。针对此类具有从属关系的分类列,必须在读取后立即显式调用 df['department'] = df['department'].ffill()(前向填充)补全缺失信息。
3. 矢量文字版与图片扫描件 PDF 区分
pdfplumber 仅能提取利用矢量字符流排版的电子文档。如果用户丢入的是扫描件、合同拍照复印件,其页面本质为单一嵌入位图,调用表格抽取将返回空列表。健壮的工具应对抽取的字符长度进行守卫检测,当检测到 len(page.extract_text() or '') < 20 时,主动记录该页疑似扫描件并提示接入 OCR 引擎,而非静默吞下空数据。
4. 大批量吞吐时的内存熔断保护
当单次待处理的工作簿达到几百甚至上千个时,不要试图将所有 DataFrame 一口气驻留内存合并。推荐的做法是引入分块写入机制:每聚合 50 个文件即写入一个临时 Parquet 或中间表,最终统一流式整合;对于 PDF 合并,pypdf 仅在内存中维护对象引用指针,内存开销极低,但在处理超千页大文档时应避免重复深拷贝 PageObject。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









