

yield 关键字详解:Python 生成器函数与普通函数的差异
深入详解 Python 中 yield 关键字的底层工作机制,全面对比生成器函数与普通函数在执行模型、栈帧挂起恢复、内存开销以及生命周期上的核心差异,配合详实代码示例与实用避坑指南。
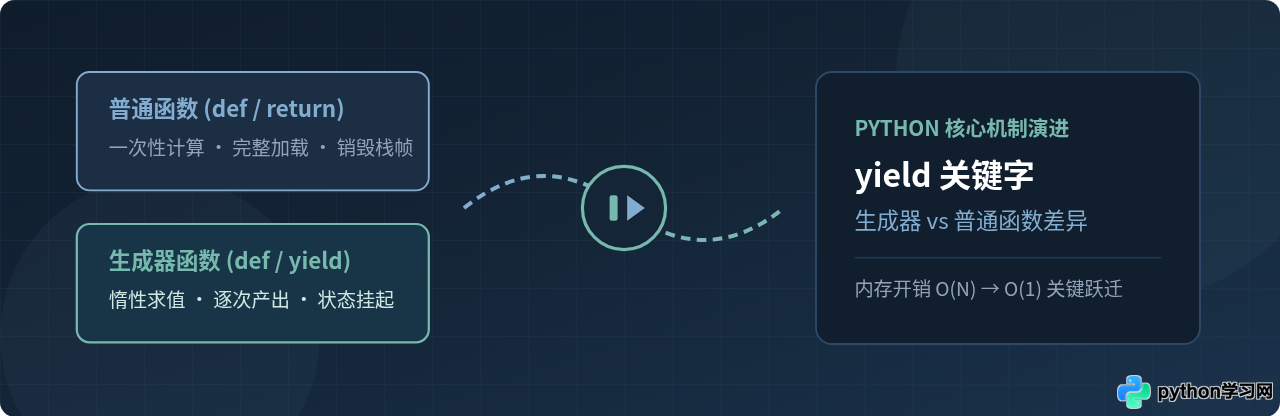
在处理 10GB 大小的服务器访问日志、或者生成数千万条递增序列时,初学者常常会写一个普通函数,内部维护一个列表不断执行 append(),最后用 return 返回。然而脚本运行瞬间就会将服务器内存占满并崩溃抛出 MemoryError。解决这个问题的关键,就是将普通函数中的 return 替换为 yield 关键字。包含 yield 的函数不再是一次性把全部数据加载进内存的普通函数,而是转变为生成器函数(Generator Function):它通过“按需生成、状态挂起”的机制,将海量数据的内存开销从随着数据量线性暴增的 O(N) 降至微小恒定的 O(1)。
一、核心认知:普通函数与生成器函数的本质区别
很多 Python 开发者在初学时,容易将 yield 简单理解成“另一种形式的 return”。这种理解会掩盖它们在底层运行机制上的根本差异。
在 Python 语言定义中:
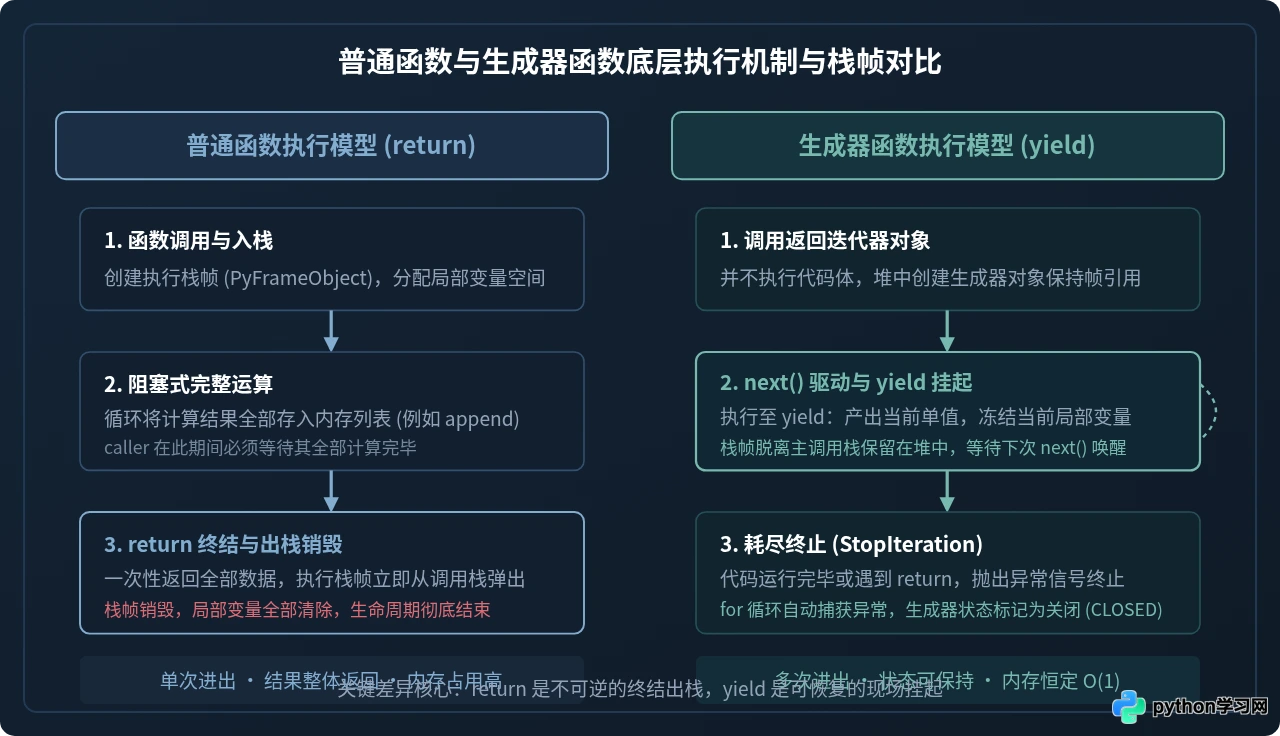
- 普通函数(Normal Function):使用
def定义,且仅使用return(或者不显式写 return 时默认返回None)。调用该函数会立刻触发内部代码从头到尾顺序执行,遇到return时抛出最终运算结果,并将该函数在调用栈中的栈帧(Stack Frame)彻底销毁,局部变量随之释放。 - 生成器函数(Generator Function):只要函数体内出现了
yield关键字,Python 解释器在编译字节码时就会为该代码对象打上CO_GENERATOR标志。此时调用该函数,根本不会立即执行函数体内的任何一行代码,而是直接返回一个特殊的迭代器——生成器对象(Generator Object)。
真正的计算只有在外界通过 next() 函数或 for 循环驱动它时才会发生。当函数体执行到 yield 语句时,它会产出(yield)当前值给调用方,随后冻结当前的所有局部变量和执行指针并挂起(Suspend)。直到下一次接收到推进请求,解释器再恢复执行现场,从暂停处的下一条语句继续往下走。
二、执行流拆解:从定义到迭代消费的操作步骤
为了直观感受生成器函数与普通函数在生命周期上的差异,我们可以通过具体代码一步步验证其执行流。
代码对比:列表收集 vs 按需产出
# 示例 1:普通函数,使用 return 返回完整列表
def get_numbers_list(n):
    result = []
    for i in range(n):
        result.append(i * 2)
    return result

# 示例 2:生成器函数,使用 yield 逐个产出
def generate_numbers(n):
    for i in range(n):
        yield i * 2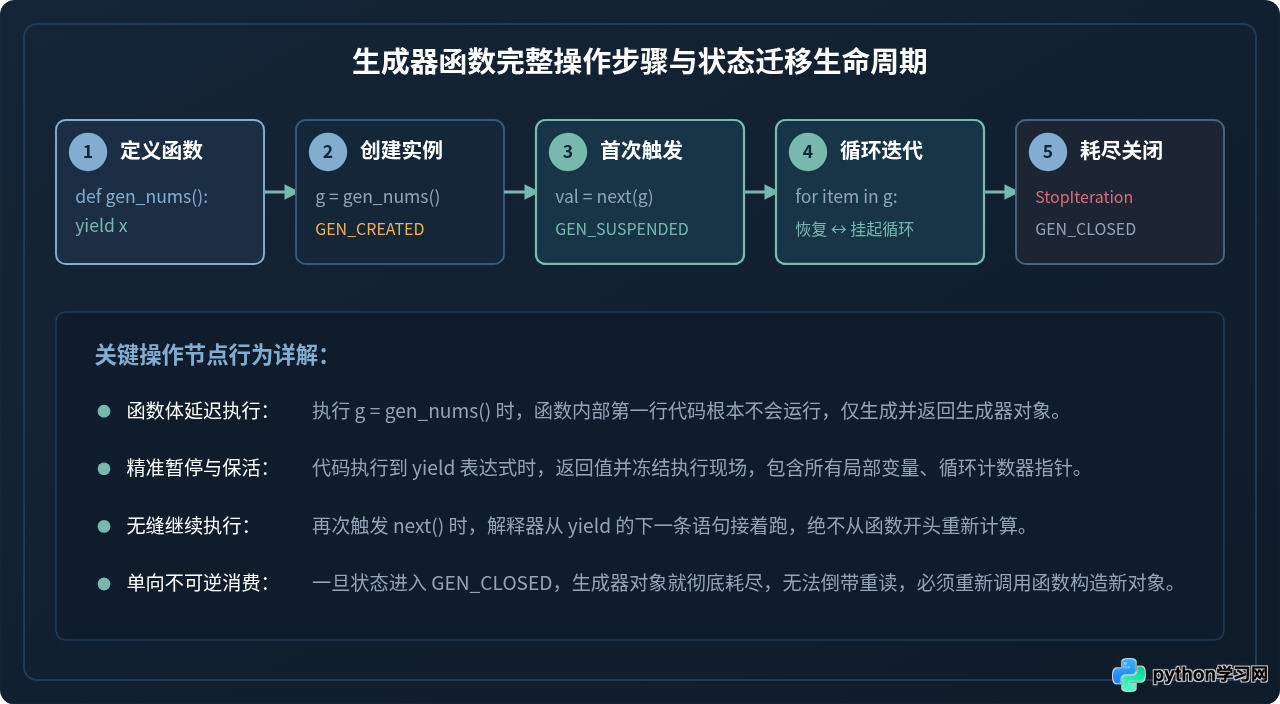
操作步骤详解:
-
步骤一:定义包含 yield 的生成器函数
如上方的generate_numbers,我们在循环中不使用result.append()聚合数据,而是直接yield i * 2。 -
步骤二:调用函数并观察返回值
执行命令与输出:
请注意:调用gen = generate_numbers(3) print(gen) # 示例输出:<generator object generate_numbers at 0x104b2c120>generate_numbers(3)时并没有输出任何数值,循环体一步都没有走,只是创建了一个处于GEN_CREATED状态的生成器对象。 -
步骤三:使用 next() 逐步单步推进验证挂起机制
每次调用print(next(gen)) # 示例输出:0 (执行至 i=0 时的 yield,挂起当前状态) print(next(gen)) # 示例输出:2 (从 i=0 暂停处恢复,进入 i=1,遇到 yield 产出 2 并挂起) print(next(gen)) # 示例输出:4 (恢复执行,进入 i=2,产出 4 并挂起)next(gen),程序才会前进到下一个yield,这证明了数据是“随用随算”的,绝不提前占用多余计算时间。 -
步骤四:触发终止与 StopIteration 异常
当生成器内部的数据生成完毕(循环走完或遇到无值 return),再次调用next(gen)时,Python 会抛出StopIteration异常:
这正是 Python 迭代器协议的标准规范。当我们使用print(next(gen)) # 示例输出报错:StopIterationfor item in generate_numbers(3):时,for循环在底层会自动调用next()并在捕获到StopIteration时优雅退出循环,对开发者完全透明。 -
步骤五:单遍消费特性验证
生成器对象是一次性的(单遍迭代器)。当生成器抛出StopIteration进入GEN_CLOSED状态后,如果你再次尝试对它进行for循环遍历,将什么都不会输出。如果需要重新遍历,必须重新调用生成器函数创建新的生成器实例。
三、深层剖析:内存占用与流式数据管道
为什么在生产环境中,处理批量数据或海量流式数据时极力推荐生成器?根本原因在于内存复杂度的几何级差距。
内存占用实测对比
我们可以使用 Python 标准库 sys.getsizeof() 观察存储 1,000,000 个整数时两者所占用的内存空间差异:
import sys

# 1. 普通列表方案:100 万个整数一次性常驻内存
huge_list = [x for x in range(1_000_000)]
print(f"普通列表占用内存: {sys.getsizeof(huge_list) / 1024 / 1024:.2f} MB")
# 示例输出:普通列表占用内存: 8.05 MB (仅列表外壳指针,未计元素对象)

# 2. 生成器表达式/生成器函数方案
huge_gen = (x for x in range(1_000_000))
print(f"生成器对象占用内存: {sys.getsizeof(huge_gen)} 字节")
# 示例输出:生成器对象占用内存: 104 字节
不论数据规模是 1 万、100 万还是 1 亿,生成器对象所占用的内存恒定只有大约 104 ~ 200 字节。因为它根本不预先保存数据,而只保存一套代码执行状态和指针。
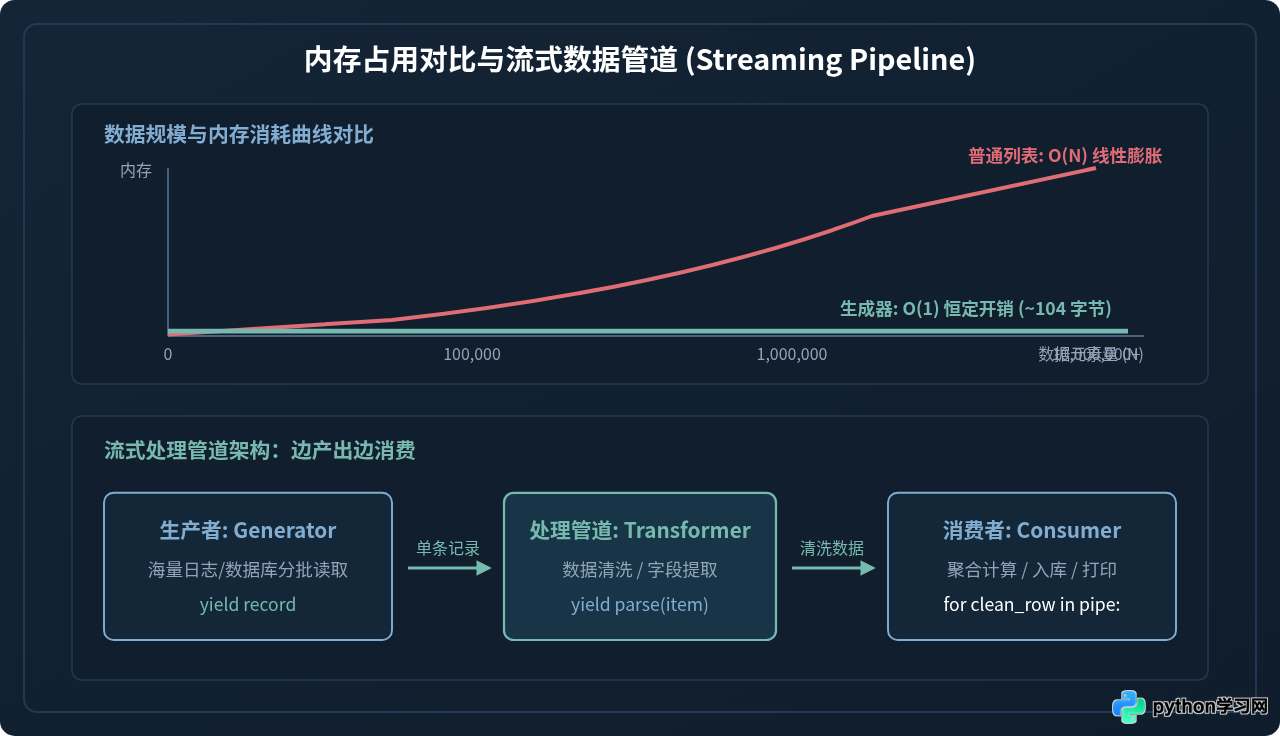
实战场景:构建超大文件流式管道
当分析几百 GB 的服务器 access.log 时,使用生成器可以串联多级处理管道,内存始终保持平稳:
def read_large_file(filepath):
    """生成器 1:逐行读取超大文件,无需一次性 readlines()"""
    with open(filepath, "r", encoding="utf-8") as f:
        for line in f:
            yield line

def filter_error_logs(lines):
    """生成器 2:逐行筛选错误日志"""
    for line in lines:
        if "ERROR" in line:
            yield line.strip()

# 流水线装配消费:数据从磁盘逐行流经管道,处理完立即丢弃
log_stream = read_large_file("access.log")
error_stream = filter_error_logs(log_stream)

for err in error_stream:
    print(f"发现异常记录: {err}")
在此模式下,任何时刻内存中都只有当前正在处理的一行文本,系统不会因为文件体积膨胀而发生内存溢出。
四、进阶特性:双向通信与 yield from
yield 不仅能够向外产出数据,它还可以作为表达式接收调用方发送进来的参数,实现外部与函数内部的协同通信。
1. send() 方法传递数据
生成器对象提供了 send(value) 方法。它可以将 value 作为挂起处 yield 表达式的计算结果传递回生成器内部:
def running_average():
    total = 0.0
    count = 0
    average = None
    while True:
        # yield average 产出当前均值,同时接收外部 send 传入的新数值
        val = yield average
        if val is None:
            break
        total += val
        count += 1
        average = total / count

# 使用示范
avg_gen = running_average()
next(avg_gen)           # 预激生成器,执行到 yield 处挂起,输出 None
print(avg_gen.send(10))  # 示例输出:10.0
print(avg_gen.send(20))  # 示例输出:15.0
print(avg_gen.send(30))  # 示例输出:20.0
2. yield from 语法糖委派
Python 3.3 引入了 yield from subgen 语法,用于将子生成器的产出直接透明地透传给外层调用方,大大简化了嵌套生成器的扁平化代码:
def chain_data(list1, list2):
    # 等价于 for x in list1: yield x 加上 for y in list2: yield y
    yield from list1
    yield from list2

for item in chain_data([1, 2], [3, 4]):
    print(item, end=" ")
# 示例输出:1 2 3 4
五、常见避坑指南与使用注意
初学者容易犯的错误是直接将生成器函数调用的返回值当成列表使用,例如:data = generate_numbers(5); print(len(data))。这会立即抛出 TypeError: object of type 'generator' has no len()。生成器是按需生成的流,无法预先得知长度,也没有切片功能(data[0] 同样非法)。如需随机访问,请先显式转化为列表:list(data)。
生成器属于一次性迭代器。一旦遍历完毕,指针已停留在末尾(状态为 CLOSED)。如果对同一个生成器变量再次执行 for 循环,将直接跳出,不会产生任何数据,容易导致数据丢失或统计结果为空的隐蔽 Bug。
在生成器函数中可以使用 return value,但需要注意:return 的值不会作为生成器产出的数据项输出,而是作为 StopIteration 异常对象的 value 属性保存。通常在协程通信或 yield from 中充当子生成器的最终返回值。
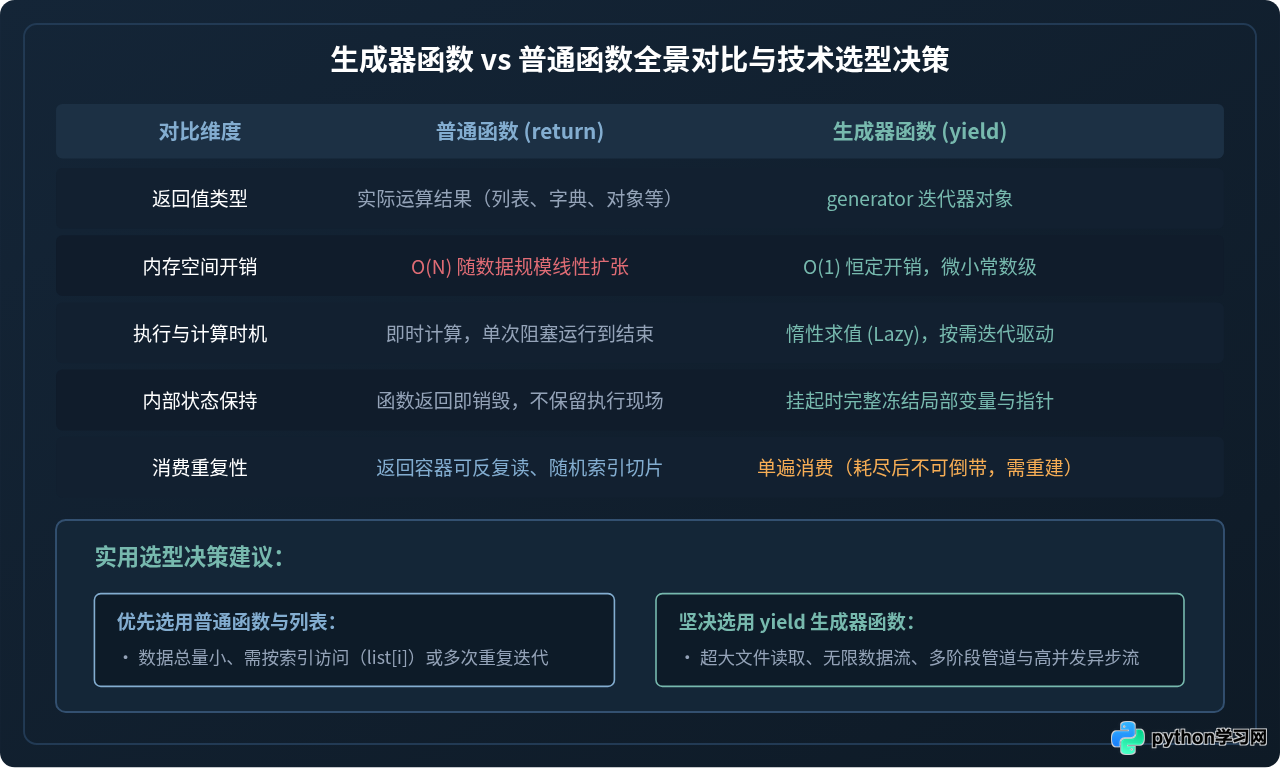
六、总结与技术选型建议
归结起来,yield 是 Python 语言中从“全量预计算”走向“按需流式计算”的核心枢纽。在实际工程项目中,两者的选择边界非常清晰:
- 选择普通函数与标准集合(list/dict):当数据量规模已知且较小、需要重复遍历访问、需要按照下标切片索引(如
items[3:8])、或者需要快速获取集合总长度(len())时,普通函数最为直观高效。 - 坚决选择 yield 生成器函数:当面对超大文件读写、无限流序列生成、数据库分页海量抽取、多阶段级联流水线处理、以及并发协作场景时,生成器函数不仅能从根本上消除
MemoryError隐患,还能显著提升程序的首包响应速度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









