

Python处理大体积Excel文件速度慢怎么优化
针对Python在处理大体积Excel文件时耗时长、内存占用过高的问题,深入分析.xlsx底层XML解压瓶颈,并提供裁剪读取字段、换用calamine高性能引擎、openpyxl流式只读以及转存Parquet等全套实用优化方案。
在数据分析与自动化处理场景中,当 Excel 文件大小达到数十兆甚至几百兆、行数超过数十万时,Python 的 pandas.read_excel 往往会出现读取长达几分钟甚至直接因内存耗尽(OOM)而崩溃的现象。解决这一问题的核心逻辑在于阻断全量 DOM 对象反序列化,具体优化路径包括:在读取时裁剪非必要字段与类型、更换底层高性能解析引擎(如基于 Rust 的 calamine)、采用流式逐行消费(openpyxl 的只读模式),以及在源头转存为 Parquet 或 Feather 等高性能二进制格式。
一、为什么 Python 处理大体积 Excel 会异常缓慢
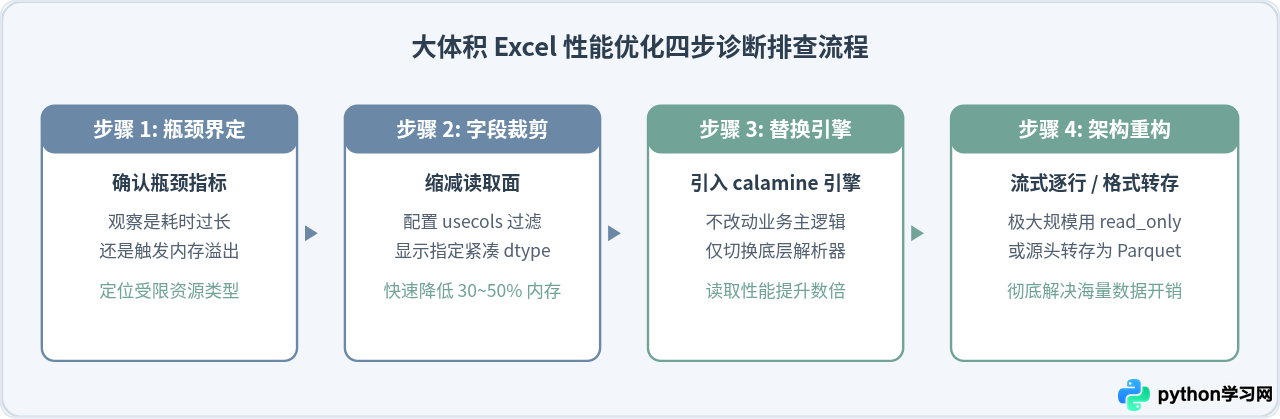
日常使用的 .xlsx 文件并不是简单的纯文本或扁平表格,它的物理本质是一个经过 Zip 算法打包的压缩文件夹,内部遵循 Office Open XML 规范。一个标准工作簿包含结构定义文件、样式表(styles.xml)、共享字符串表(sharedStrings.xml)以及每个工作表对应的底层 XML 文件(sheet1.xml)。
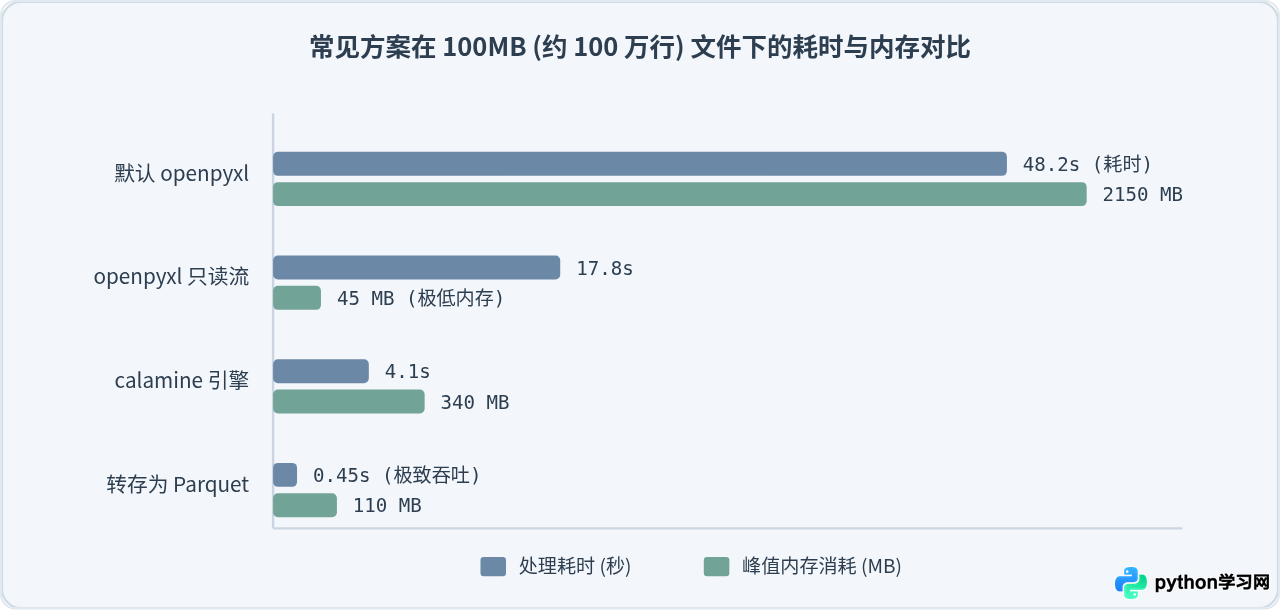
当使用常规方式(如 openpyxl 默认配置或基于它的 pandas 接口)读取 Excel 文件时,Python 解析器必须依次经历解压归档、读取 sharedStrings.xml 将字符串索引还原为具体文本、解析 XML 节点并建立庞大的单元格对象树模型。在 Python 中,每个单元格被封装为一个包含类型、样式、公式、值以及边框元数据的复合对象,这会导致内存膨胀率达到 10 到 30 倍。一个 100MB 的 .xlsx 文件在载入内存时往往会消耗 2GB 到 3GB 内存,大量时间都消耗在 XML 标签遍历与 Python 对象分配的开销上。
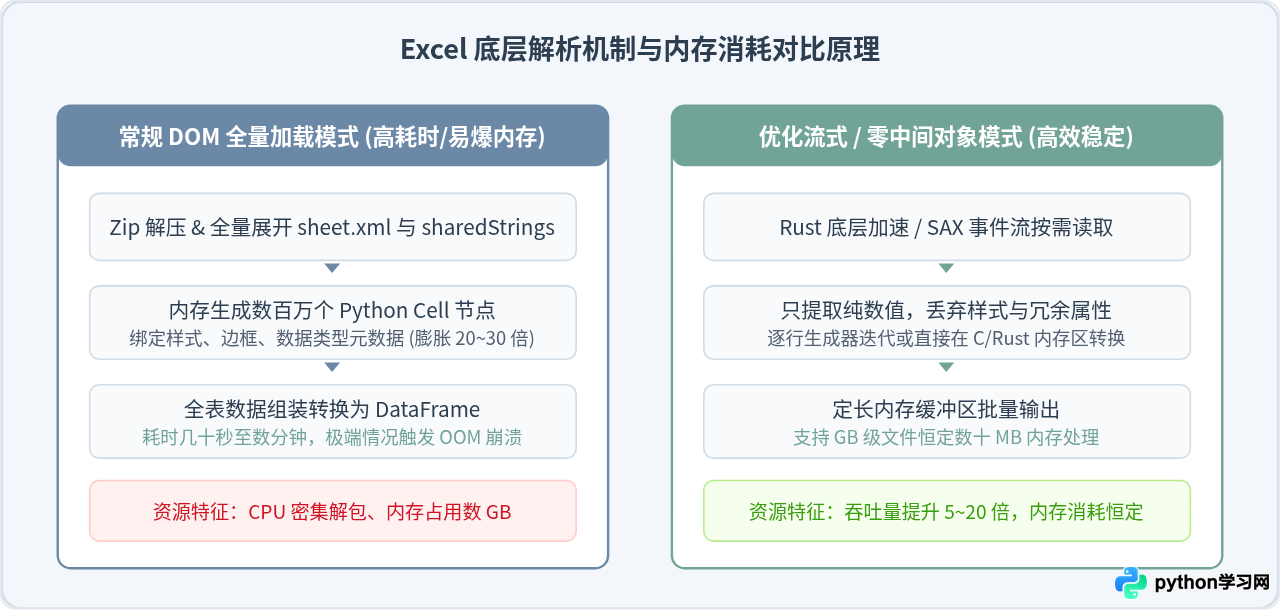
二、大体积 Excel 优化诊断与排查四步流程
在动手修改代码之前,应遵循科学的排查顺序,确定当前任务属于“单次临时分析”还是“长期生产流水线”,并依据数据特征选择最经济的优化手段。
三、方案一:Pandas 参数裁剪与类型压缩
在很多实际业务中,表格可能包含数十甚至上百个字段,但下游分析仅需要其中几列。Pandas 默认会把所有未指定类型的字符串解析为通用 object 类型,导致每个单元格数据都带有额外的 Python 对象头指针。
通过向 pd.read_excel 传递 usecols 限制只读取必要列,同时利用 dtype 将数值限制为紧凑类型(例如 float32 或 category),可以显著减轻后续内存分配的负担:
import pandas as pd

# 仅载入业务相关列,并显式指定字段存储类型
columns_to_load = ['order_id', 'amount', 'category', 'status']
data_types = {
    'order_id': 'string',
    'amount': 'float32',
    'category': 'category',
    'status': 'category'
}

df = pd.read_excel(
    'orders_2026.xlsx',
    usecols=columns_to_load,
    dtype=data_types
)
这种调整无需安装额外依赖,适用于几十兆以内、字段较多但使用率较低的表格。但如果文件本身已经达到上百兆、行数超过五十万,解析 XML 的 CPU 瓶颈依然无法通过参数消除,需要进一步更换底层解析器。
四、方案二:换用基于 Rust 的 calamine 解析引擎
自 Pandas 2.1 起,官方引入了对 calamine 引擎的原生支持。calamine 底层由 Rust 编写,它直接对 Excel 压缩包内的 XML 流进行极速内存映射与二进制解析,完全跳过了 Python 层的复杂对象包裹。
根据不同文件规模,calamine 相比传统 openpyxl 的解析吞吐量通常提升 3 到 10 倍以上,且内存占用大幅降低。在环境中使用以下命令安装驱动库:
pip install python-calamine在 Python 代码中,只需在 pd.read_excel 中显式指定 engine='calamine':
import pandas as pd

# 使用高性能 Rust 引擎 calamine 读取
df = pd.read_excel(
    'large_dataset.xlsx',
    engine='calamine',
    sheet_name='Sheet1'
)

print(f"数据读取完成,共 {len(df)} 行,内存占用: {df.memory_usage().sum() / 1024**2:.2f} MB")五、方案三:openpyxl 的只读流式模式 (read_only=True)
当单个 Excel 文件达到数百兆、甚至行数突破上百万行时,哪怕解析速度再快,一次性将整张表组装为 DataFrame 也会瞬间撑爆服务器内存。此时最适宜的策略是“流式逐行消费”。
openpyxl 提供了针对超大文件的 read_only=True 模式。在此模式下,openpyxl 采用基于 SAX 的 XML 解析器,在迭代时逐行读取 XML 节点,消费完一行即释放一行,内存占用始终维持在几十兆的固定水准:
from openpyxl import load_workbook

def process_huge_excel(file_path):
    # 开启只读流式模式,data_only=True 确保读取计算后的数值而非原始公式
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    sheet = wb.active

    row_iterator = sheet.iter_rows(values_only=True)

    # 读取表头
    headers = next(row_iterator)

    batch = []
    batch_size = 5000

    for row in row_iterator:
        batch.append(row)
        if len(batch) >= batch_size:
            # 批量写入数据库或转储,防止内存积压
            flush_batch_to_storage(batch)
            batch.clear()

    if batch:
        flush_batch_to_storage(batch)
        batch.clear()

    # 只读模式处理完毕后显式关闭工作簿释放句柄
    wb.close()

def flush_batch_to_storage(records):
    # 示例消费逻辑:插入数据库或落地中间存储
    pass
在只读模式下需要注意两点限制:一是不能调用 sheet.max_row 预先获取总行数(因为 SAX 是流式扫描,不知道总行数是多少,强行读取会导致遍历整个文件);二是已遍历过的行无法倒退重新访问。
六、方案四:格式转换与架构级解法
在工业级数据管线中,Excel 适合人类阅读与录入,但极其不适合作为海量数据的交换格式。如果同一个大体积 Excel 文件需要被反复读取多次,或者数据量已经超过 50 万行,最彻底的提速手段是将数据脱离 .xlsx 封装,转换为列式存储格式(如 Apache Parquet)或轻量级数据库。
使用 Python 可以仅在数据落地时进行一次格式转换,后续全部基于 Parquet 读取:
import pandas as pd

# 仅在数据接收时执行一次性转换
def convert_excel_to_parquet(excel_path, parquet_path):
    # 使用 calamine 极速读取原始 Excel
    df = pd.read_excel(excel_path, engine='calamine')
    # 转存为压缩 Parquet 格式,自带强类型元数据
    df.to_parquet(parquet_path, engine='pyarrow', compression='snappy')

# 后续业务流水线直接消费 Parquet 文件
df = pd.read_parquet('orders_2026.parquet')
结合现代化数据框架 Polars,读取同样规模的 Parquet 文件耗时通常在毫秒级到一秒以内,不仅支持并行多核扫描,还支持只加载指定列与行过滤推断(Predicate Pushdown),从根本上消除 Excel 带来的性能瓶颈。
七、优化选型总结与实践决策
针对不同文件大小、业务约束及计算环境,建议依据以下决策模型进行选型:
| 场景与数据规模 | 推荐方案 | 核心优势 | 主要代价/约束 |
|---|---|---|---|
| 几十 MB 以内,临时分析任务 | pd.read_excel(usecols=..., dtype=...) |
零额外第三方库,改动极小 | 提升幅度有限,不解决 XML 根因 |
| 几十至数百 MB,要求载入 DataFrame | pd.read_excel(engine='calamine') |
读取速度提升 3~10 倍,内存占用更低 | 需安装 python-calamine,仅支持读取 |
| 几百 MB 以上,内存极度受限(如 2G 容器) | openpyxl (read_only=True) 流式迭代 |
内存恒定在 50MB 左右,永不 OOM | 单向只读,需自行编写批处理持久化 |
| 每日定时调度、海量流水线或多轮计算 | 源头转存为 Parquet / SQLite | 毫秒级秒开,列式压缩比高达 80%+ | 需要前置转换流程,业务方需支持 |
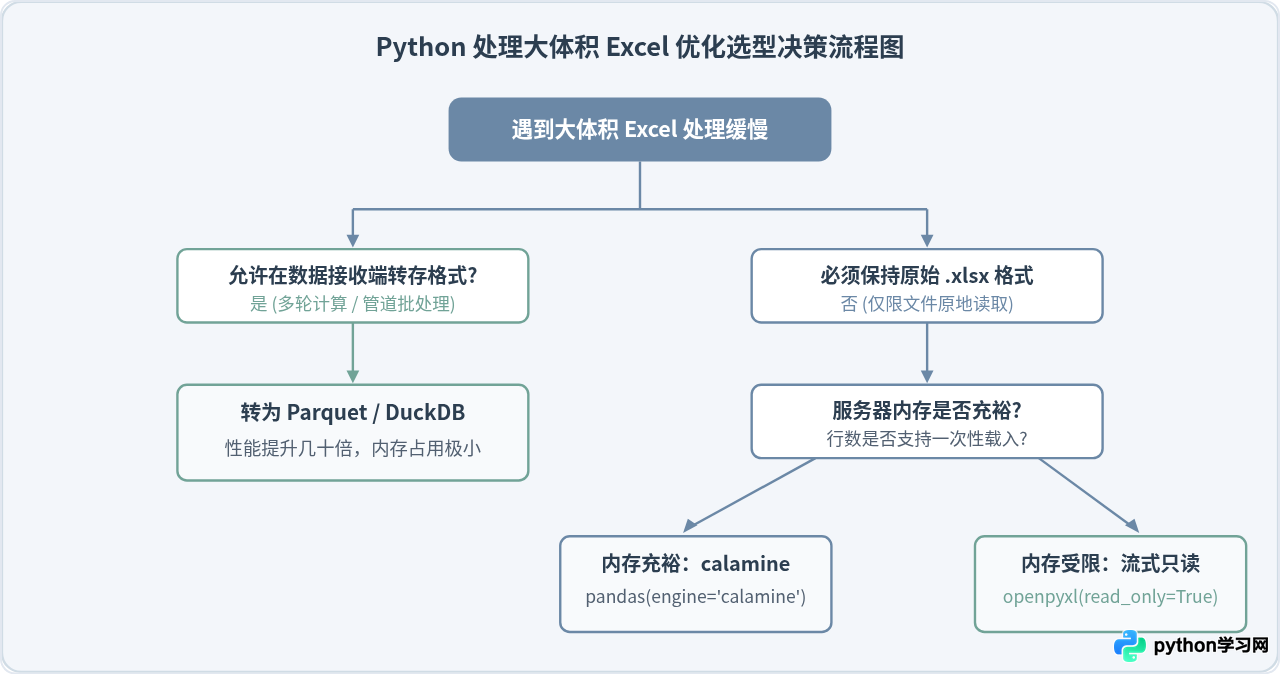
综上所述,Python 处理大体积 Excel 缓慢的核心在于解压及生成冗余的 Python 单元格对象。在实际排查中,优先使用 usecols 裁减无关列;若需整体载入内存进行探索性分析,引入 calamine 引擎即可获得立竿见影的加速;当数据量达到百万行或内存严苛受限时,选用 openpyxl 的 read_only 模式按批次流式写入下游;而在生产数据通道中,将表格转存为 Parquet 格式才是彻底规避 Excel 开销的长远方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









